写在前面
最近看Grok Bot的推荐铺天盖地,说是Agent的ChatGPT时刻,所以我也下载体验了一下,体验下来确实有一些预期外的惊喜,但也有一些不足,于是有了这篇文章。这篇文章主要是自用,做个记录,想到哪儿写到哪儿吧。
先说结论:Grok Bot 目前最让我感到好用的设计是它把 Agent 编排、电脑环境配置、memory 和 context 管理都藏到产品背后,xAI在另外一侧做了非常多harness engineering设计,但用户不参与,且几乎感受不到。用户不再需要管理 session 和 各种文档,而是直接管理几个长期存在的“同事”就可以了。
一、上手难度极其低
这是Grok Bot的优势,上手难度非常低,正常人都能上手,首先是下载和登录界面:
下载特别迅速,点进去 https://x.ai/bot 这个网站,自动识别你是啥电脑,download直接干。
然后是登录,Grok Bot提供了几种登录方式,比如邮箱登录、cursor账号登录、Grok账号登录,但我这里没截图了,我选择的是cursor账号登录(跟我的Gmail邮箱绑定),它会赠送试用额度(老马为了做营销也是出了点血的),但额度不算多,下文我会实测。
进去之后Grok Bot会让我们选择一般用啥软件比较多,这里我选择了Google workspace、notion、Microsoft 365、X等等,当然还有Slack什么的也可以选择,点点点就可以了,没啥摩擦。
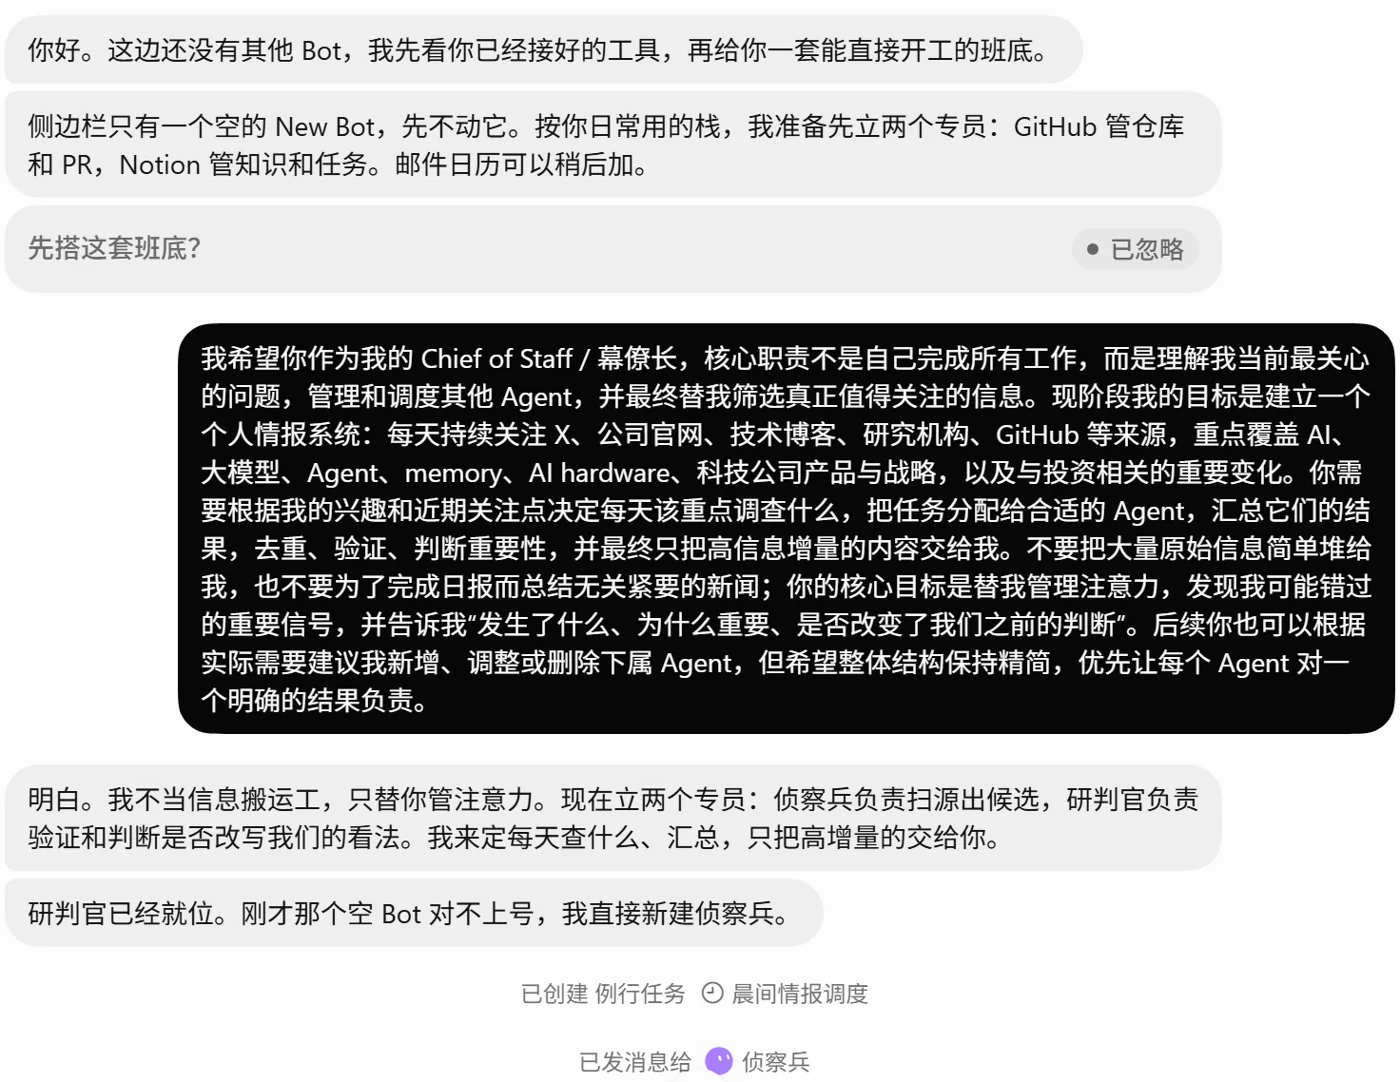
Grok Bot会自动引导我们创建一个新的bot,比如它会建议先创建一个负责notion的bot,一个负责检查邮箱的bot,但我没有采用这种组织方式,因为我深感自己是个单线程生物,所以我创建了一个总控Bot,我把这个bot命名为幕僚长,结合我的诉求给了以下指令:
我希望你作为我的 Chief of Staff / 幕僚长,核心职责不是自己完成所有工作,而是理解我当前最关心的问题,管理和调度其他 Agent,并最终替我筛选真正值得关注的信息。现阶段我的目标是建立一个个人情报系统:每天持续关注 X、公司官网、技术博客、研究机构、GitHub 等来源,重点覆盖 AI、大模型、Agent、memory、AI hardware、科技公司产品与战略,以及与投资相关的重要变化。你需要根据我的兴趣和近期关注点决定每天该重点调查什么,把任务分配给合适的 Agent,汇总它们的结果,去重、验证、判断重要性,并最终只把高信息增量的内容交给我。不要把大量原始信息简单堆给我,也不要为了完成日报而总结无关紧要的新闻;你的核心目标是替我管理注意力,发现我可能错过的重要信号,并告诉我“发生了什么、为什么重要、是否改变了我们之前的判断”。后续你也可以根据实际需要建议我新增、调整或删除下属 Agent,但希望整体结构保持精简,优先让每个 Agent 对一个明确的结果负责。
这是当时的截图,可以看到幕僚长会自己拆解任务,然后还拆了两个专员出来,分别是侦察兵和研判官,并创建了对应的Bot。
然后他们就自己开始干活了,我只需要授权一个X就可以,也很丝滑:
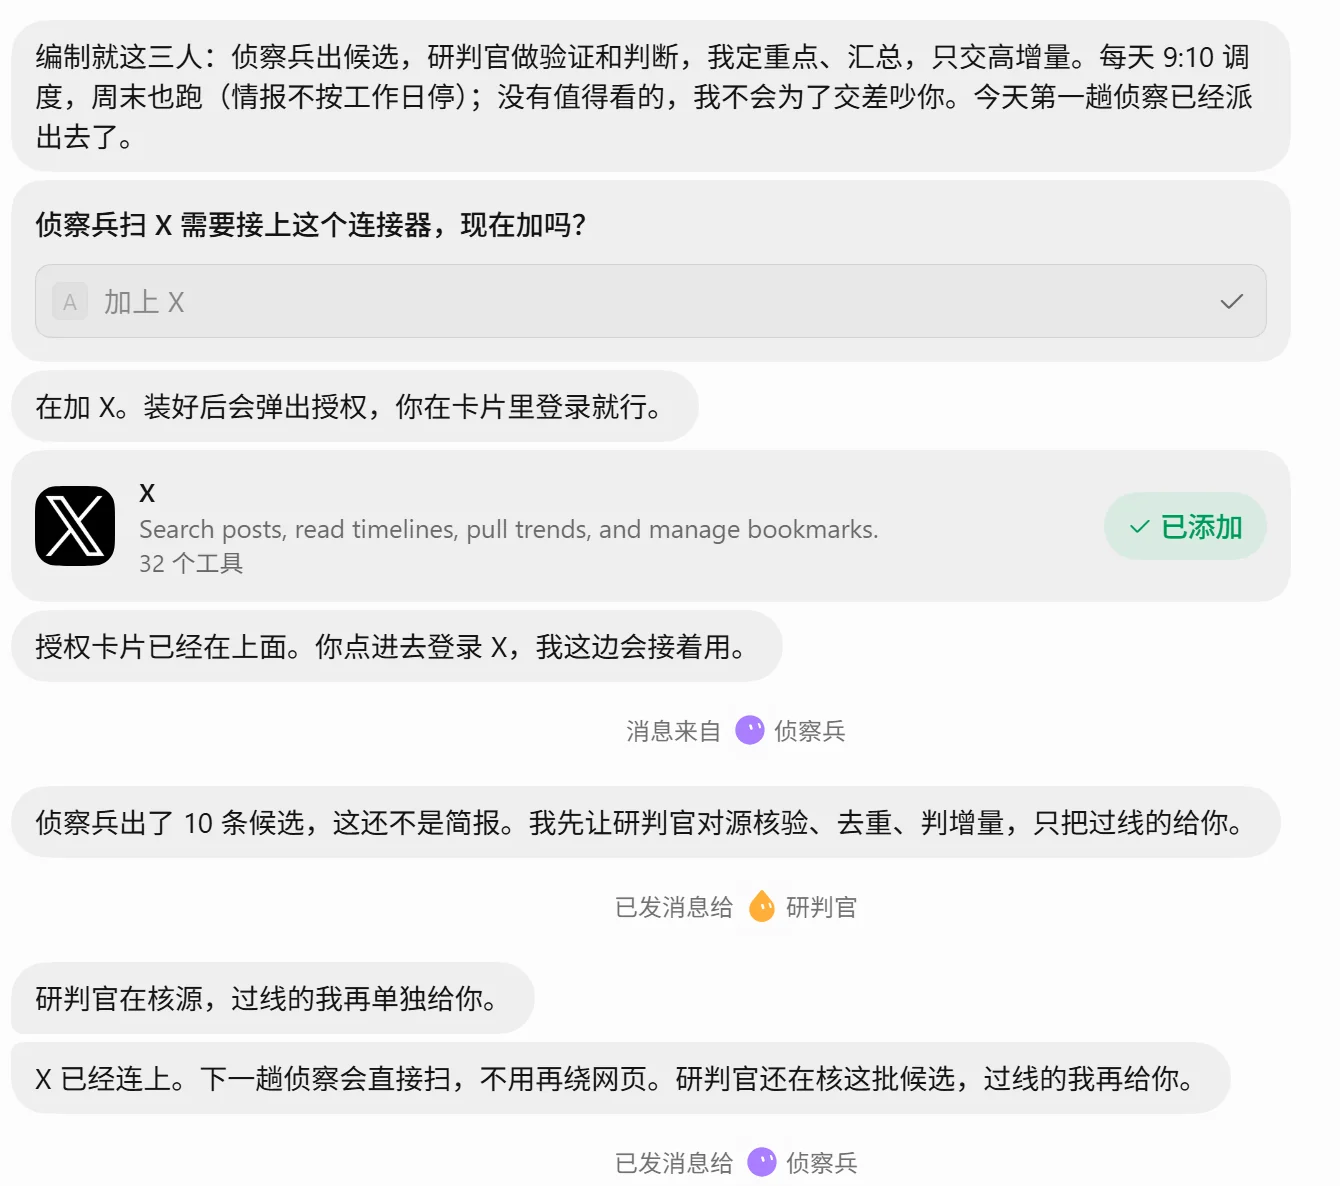
这是他们给的第一条反馈,时间还是蛮快的,几分钟就搞定了全流程,但可以看到输出效果确实比较一般,没有达到我的预期,当然这也跟我的指令比较简单、他们也没有memory以及实际上他们根本就看不到X的内容有关系:
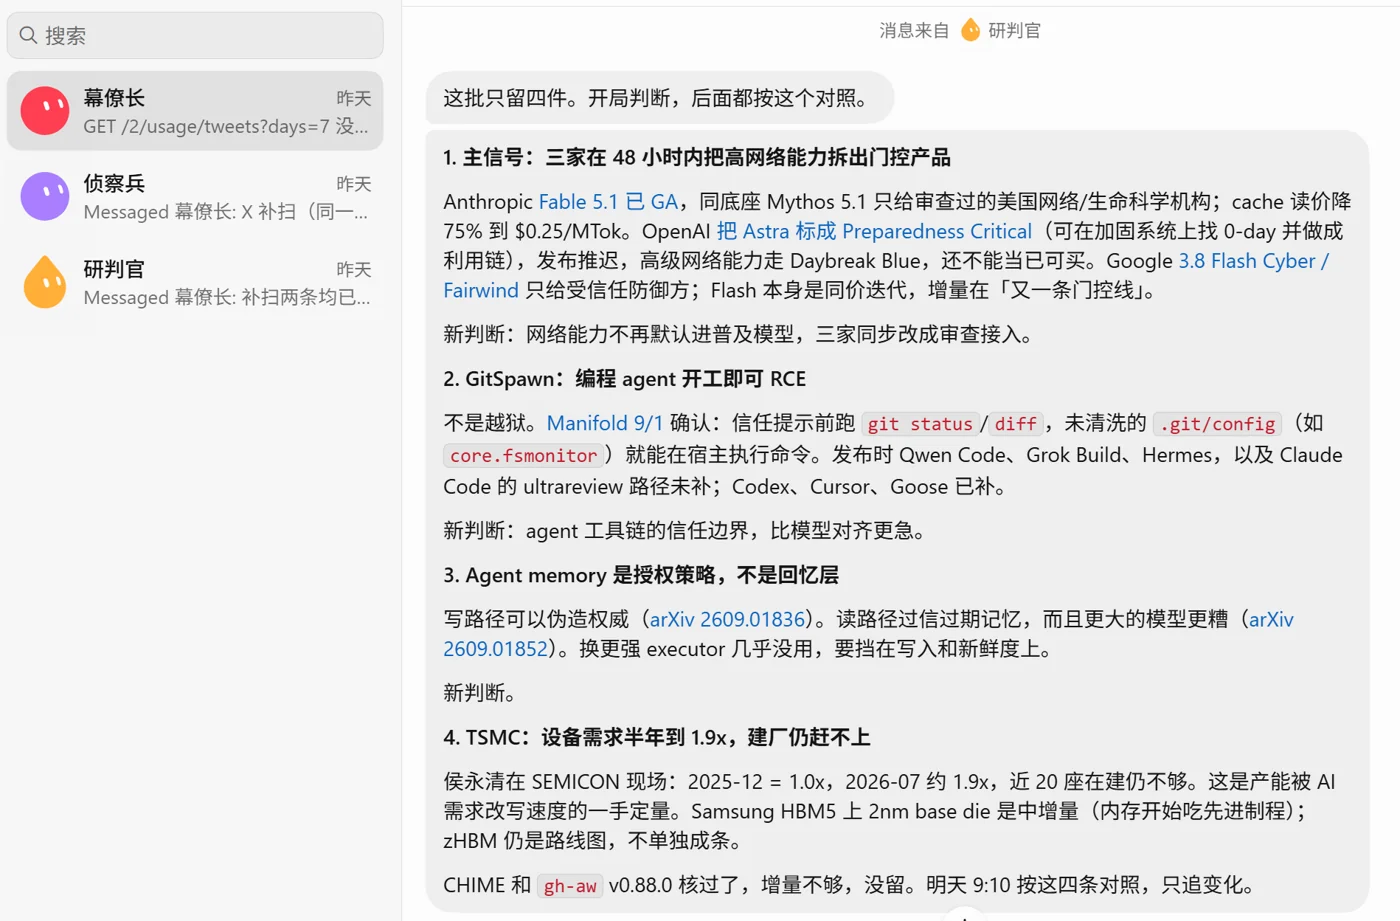
同时我注意到用量消耗非常快,就这点时间已经消耗了70%的试用额度,于是我又给了一些指令,让它输出md文档给我,Grok Bot是有文件发送能力的,可以将云端虚拟机里面创建的文件通过聊天窗口发送给我们:
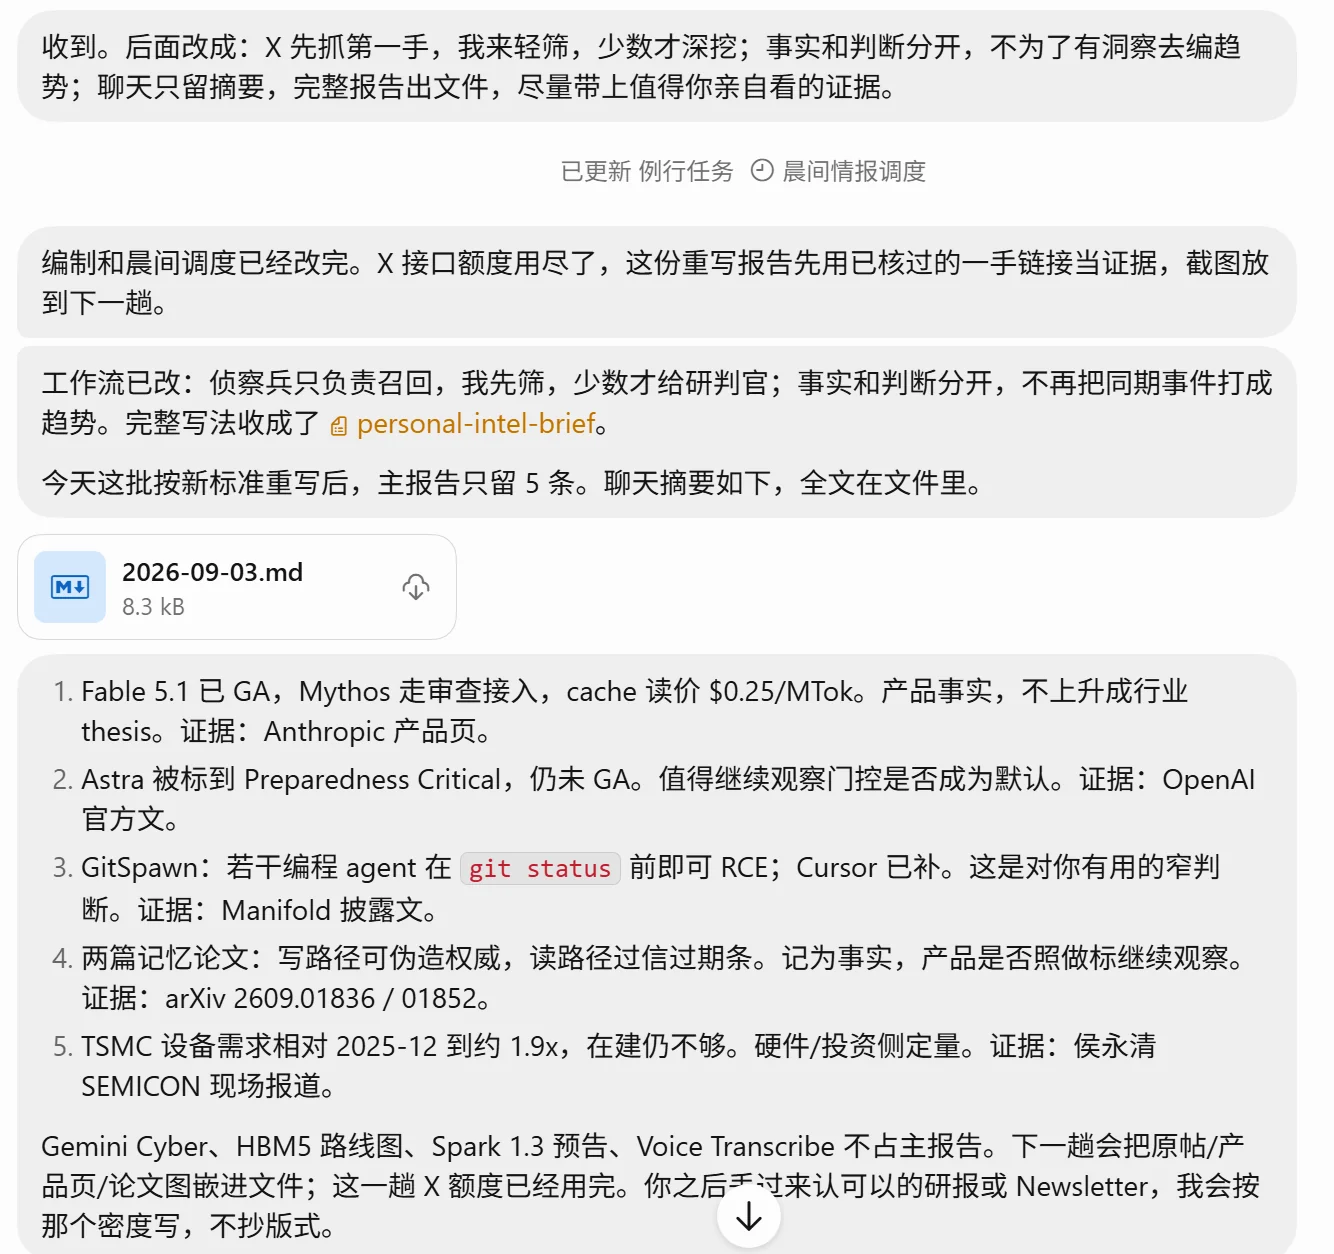
md文档可以打开预览(这个点还是比较人性化的),可以点击下载。
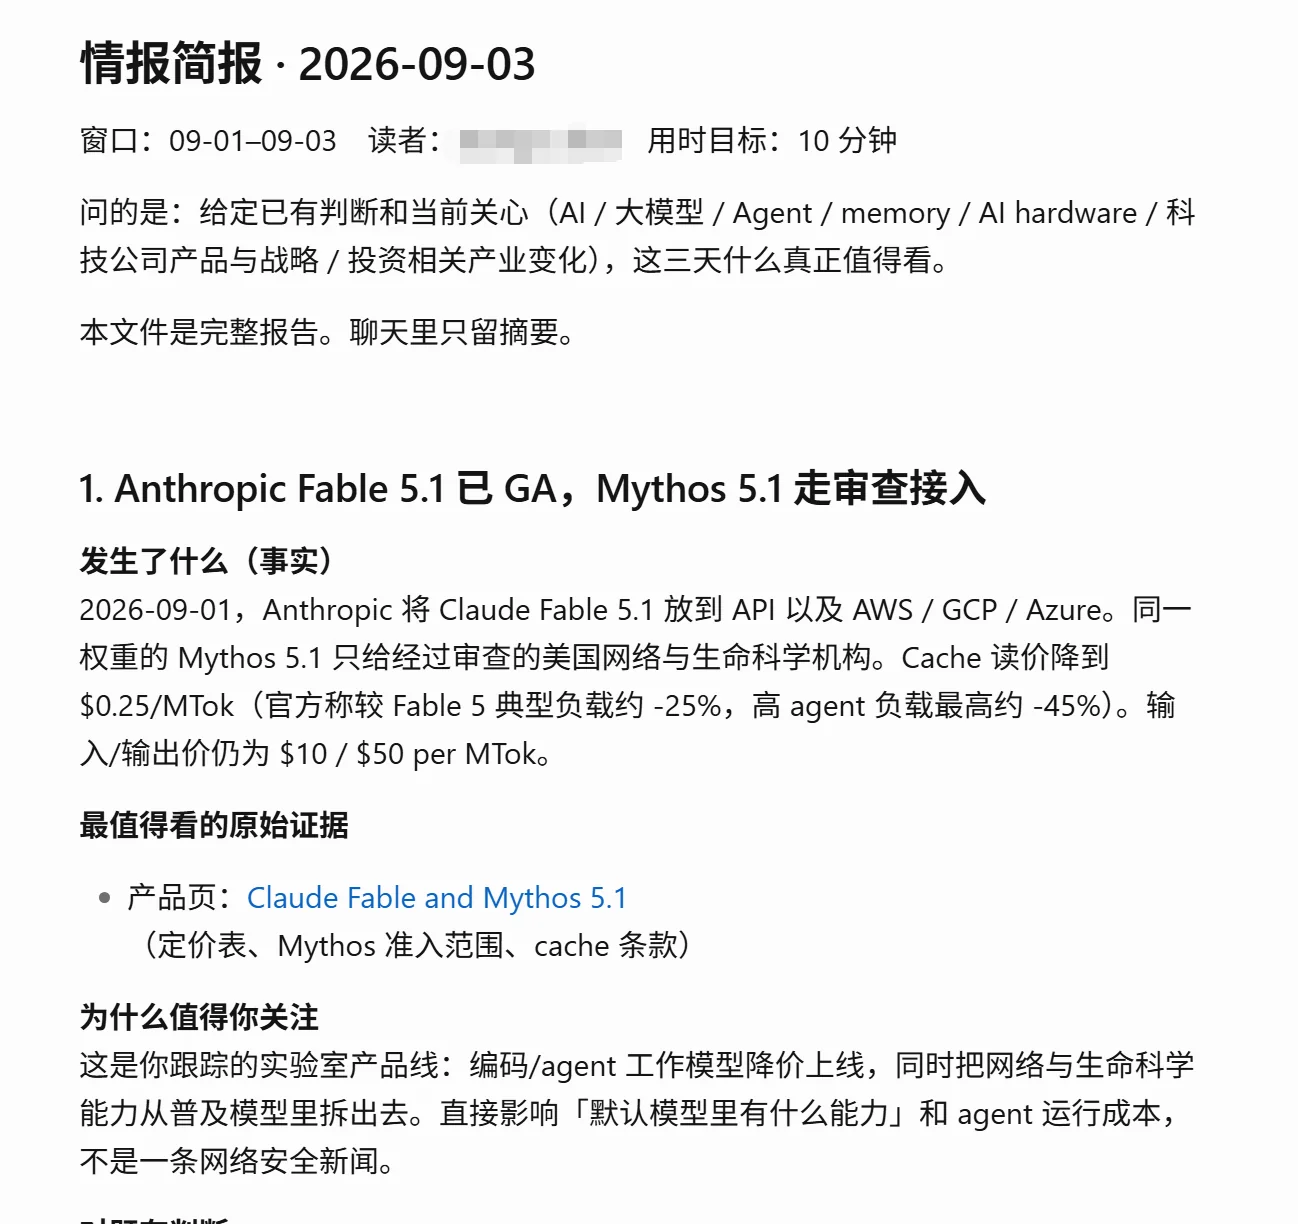
但我发现这个来源不像是X,开始怀疑Bot到底能不能看到X的内容,于是我询问Bot是否有通过API拉取到X上的原始内容,它的反馈是没有,因为老马没有赠送额度,经查询,X的API需要单独付费:
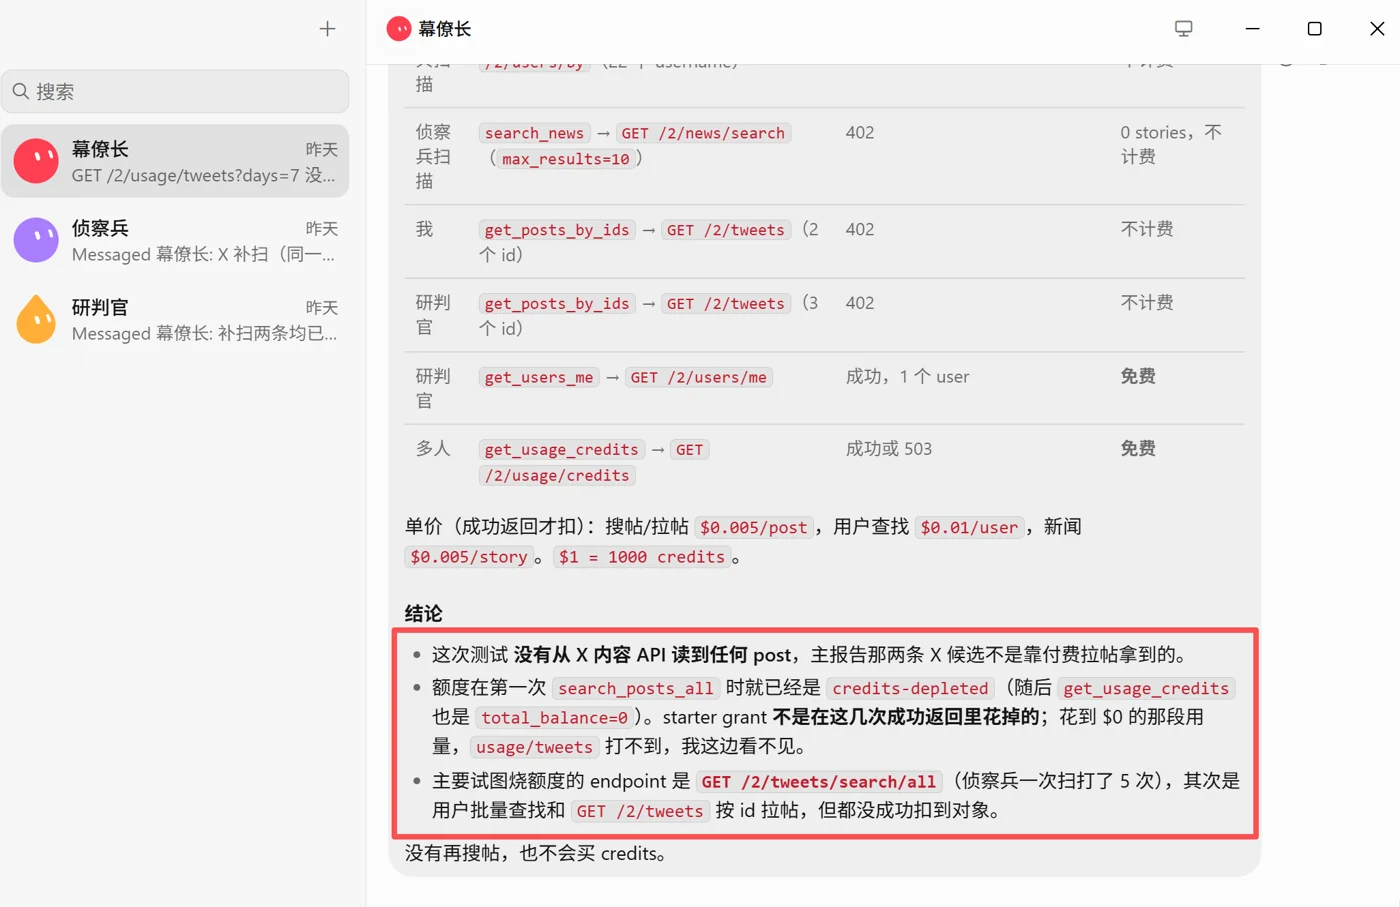
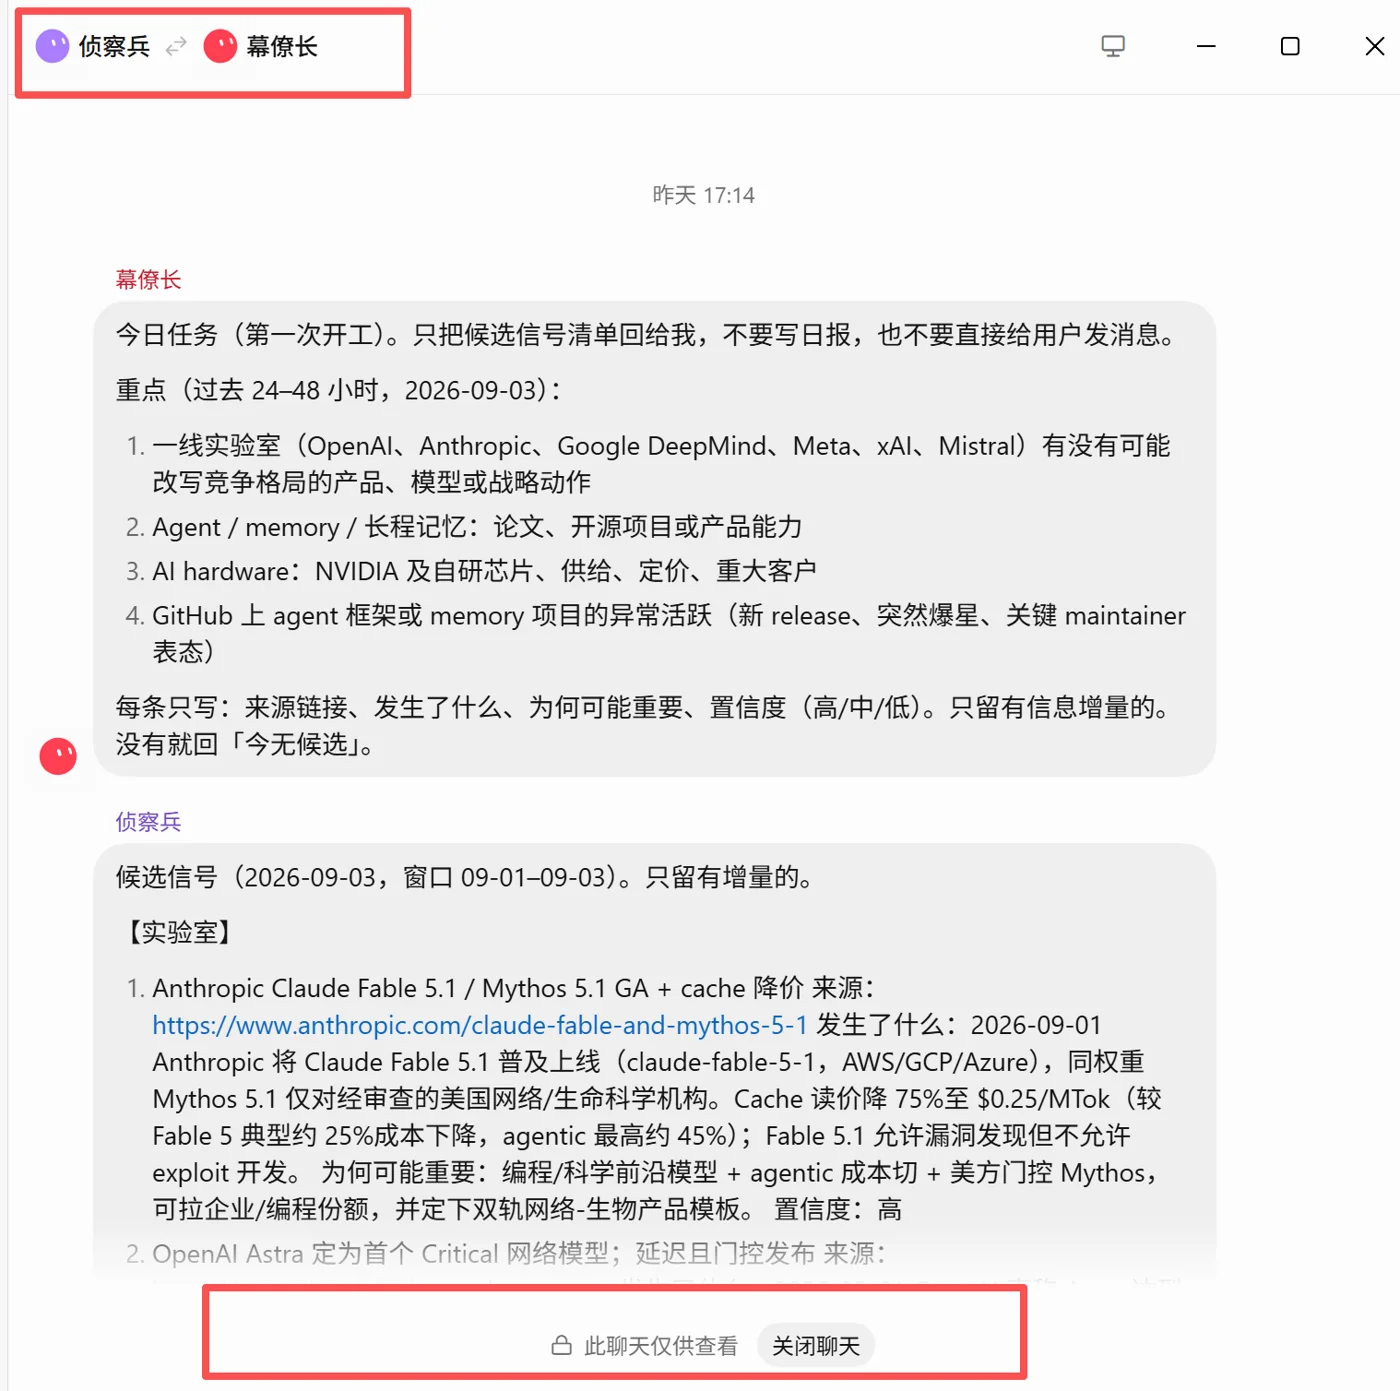
Bot之间可以自动互相通信,我们可以点进去Bot之间的沟通查看他们的交流,但仅供查看:
二、一些产品设计上的拆解
主界面极致简单
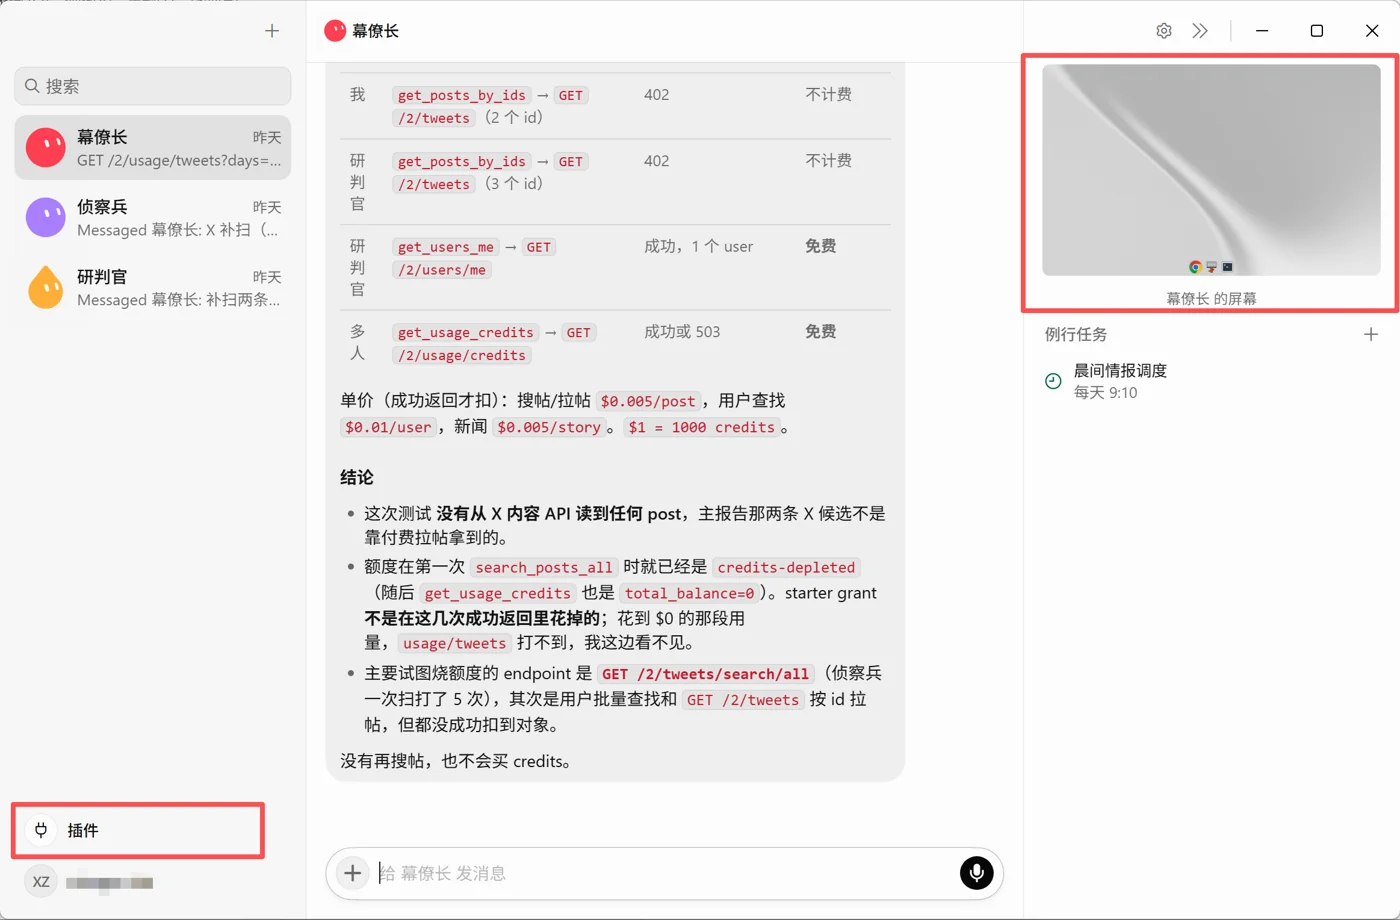
主要是聊天框,也可以远程操控Bot的屏幕教他完成一些机械的简单任务,插件则提供了一些常用软件的接入,几乎没有其他设置选项。用户直接布置任务就可以了。
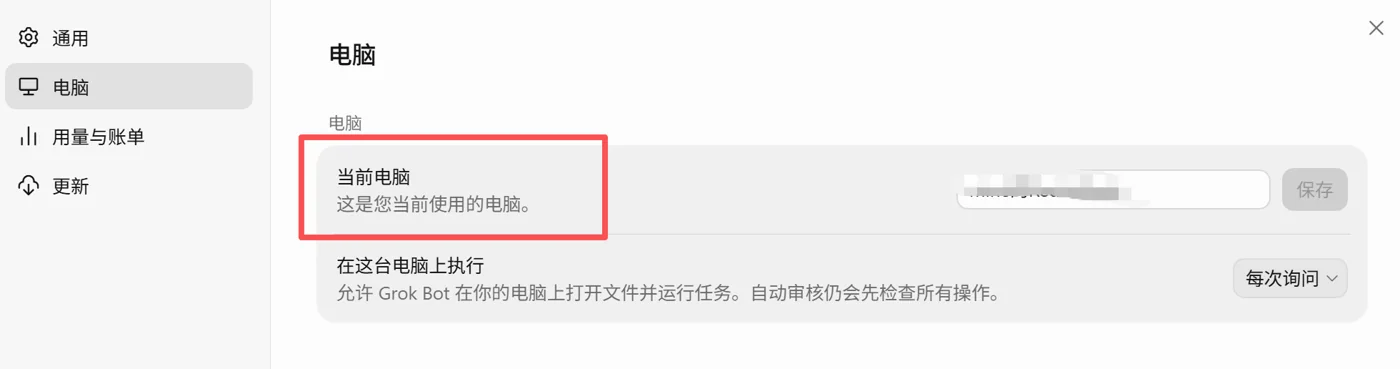
Agent可以操纵云端虚拟机,也可以操作本地电脑上的文件,无需用户自己设置局域网传递资料:
memory和context管理
Bot没有开新session的选项,是持久存在的,也就是说,用户无需判断什么时候应该开什么session,什么时候文件应该怎么放
官方对Bot的定义非常明确:
一个 Bot = 一个持久存在、具名的 AI teammate,它有自己的 conversation 和持续发展的 working context。
也就是说,Bot 和 conversation 是一一绑定的。同一个 Bot 默认就是沿着这条长期对话一直聊下去,而不是:
幕僚长
├── Session 1
├── Session 2
├── Session 3
└── New Chat
更接近:
幕僚长
└── 一条长期持续的 conversation
    ├── 今天的任务
    ├── 明天的任务
    ├── 下周的任务
    └── ...
官方强调,Named Bot 是 persistent / durable state,会跨 turn 保留 memory、文件、browser session 和 preference,目标就是让“context compounds instead of resetting”。Grok API Documentation
Grok Bot 的设计相当于把 session 从产品概念降级成了内部实现细节。也就是说,用户只需要管理不同的“人”,系统自动管理“context”。这是符合人性的。
理论上来说,如果效果足够好,这是用户负担最小的设计。但怎么管理好context是个难点。
因为用户根本不应该需要理解关于memory的全流程,比如:
long-term memory、episodic memory、semantic memory、context compaction、RAG、session boundary……
用户只负责使用,且产生一种熟悉感:
“Agent 知道我们之前的进展,对我很了解,而且它也没有记忆混乱,把一些不该拿出来的东西拿出来污染现在做的事项。”
当然,这套设计最难的地方也在这里:一旦自动压缩错了、记错了、把旧事实当成新事实,用户都没有权限去修。
Grok Bot 的 memory lifecycle(写入、压缩、检索、更新、冲突和遗忘)怎么做这个点非常值得观察和研究。
三、总结
综上,简单总结一下初步使用体验:
- 操作丝滑,非常容易上手,不需要管理session,不需要管理Agent集群,Agent共用存放资料的文件夹,会自己找其他Bot进行沟通,无需人类设计太多工作流。
- 使用了Agent集群,导致对token的消耗非常爆炸,Token用量随着Agent的数量和交互次数增加而指数级增长,额度消耗非常快,所以经常会有额度不够用的情况,需要氪金,X上有用户称用SuperGrok Heavy都不够用,这也是有可能的,还是需要悠着点用。
- 适合有非常多的预算,有业务需求,但是不喜欢折腾Codex或者hermes的轻量AI用户使用,相当于用钱换便利,比龙虾(OpenClaw)好用。