本篇导读:重学机器学习的第一站,我们回到 1809 年高斯的最小二乘法。为什么误差一定要“平方”?连续的线性预测又是如何跨越到离散的 0/1 概率分类的?本文将从正态分布与中心极限定理出发,顺着 Logit 变换揭开 Sigmoid 与交叉熵的数学本源,并一路推演至高维非凸空间的鞍点逃逸动力学。
1. 历史的原点:高斯与最小二乘法 (OLS)
机器学习最底层的模型,就是你在中学就见过的线性拟合:
很多人第一次学最小二乘法(Ordinary Least Squares, OLS)时,直觉都会问:凭什么衡量拟合好坏,要用“误差的平方和” ,而不是绝对值 或者四次方?
这里正是统计学给机器学习奠定的第一块基石。
当年高斯(Gauss)在 1809 年推导天体轨道时做了这样一个假设:
真实规律是线性的,我们观测到的每一个样本点之所以偏离直线,是因为存在测量噪声 ,即 。
(历史小注:高斯当年推导最小二乘时并非依靠中心极限定理,而是基于“多次测量的算术平均值是最优估计”这一公理倒推得出误差必须服从正态;一年后(1810 年),拉普拉斯才首次将中心极限定理(CLT)引入,指出观测误差由微观独立随机扰动叠加而成,为正态分布假设补齐了理论物理动机。)
中心极限定理(CLT)为这一物理假设提供了严格的数学动机:对独立同分布、方差有限且非零的扰动,中心化后再除以 的和,依分布收敛到标准正态分布(非同分布情形需要额外条件;方差无穷的扰动,如 Cauchy 分布,叠加后不会高斯化)。CLT 为“误差近似正态”提供了渐近建模动机,但它并不证明任何有限次叠加的真实噪声精确服从正态。
在此基础上,我们假设噪声条件独立且同方差:
当我们想让所有样本出现的联合概率密度(似然函数 Likelihood)最大化时,由条件独立性: 两边取自然对数(变为对数似然 ),丢掉与 无关的常数项后,关于 最大化对数似然在数学上等价于:
若噪声独立但异方差(),同样的推导给出加权最小二乘 ;若噪声相关,则得到广义最小二乘。普通(未加权)平方和只对应“条件独立、零均值、同方差高斯”这一特定情形。注意:这里选定的是观测的条件分布(似然模型),尚未对参数 本身引入任何先验,后者是第二站的主题。
关键直觉: 最小二乘法不是数学家拍脑袋想出来的几何技巧,它是在假设噪声条件独立、同方差且服从高斯分布的前提下,极大似然估计(MLE)给出的参数估计方法。
💡 数学细节与理论母题深入阅读:
- 高斯当年如何由“算术平均是最优估计”反向证明误差必服从正态?参见 附录 A:高斯正态误差假设的历史推导与逆向自洽证明。
- 为什么任意微扰叠加后都会趋向钟形曲线?参见 附录 B:中心极限定理(CLT)频域特征函数极简证明。
- 为什么 MLE 是机器学习与大模型 Next-token 预测的通用母题?参见 附录 C:极大似然估计(MLE)的统计与信息论最优性。
2. 现实的冲突:当输出不是数值,而是「是」与「否」
线性回归很优美,而且有显式的闭式解(矩阵满列秩时 直接算)。但现实中大量的问题不是预测房价、气温,而是:
- 这封邮件是不是垃圾邮件?(1 或 0)
- 这个病人是否患病?(1 或 0)
如果你直接用线性回归去拟合标签 0 和 1,会遇到两个致命的逻辑硬伤:
- 值域不匹配:线性回归的值域是 。如果算出 或 ,你无法将它解释为现实中的“概率”。
- 离群点(Outliers)剧烈扭曲边界:如果右侧出现了一个极度健康的样本(离分类线很远),线性回归为了拟合它,会硬生生拉平整条直线的斜率,导致中间原本分对的样本全部分错。
3. 巧妙的飞跃:广义线性模型与对数几率回归(Sigmoid 的诞生)
面对分类任务中“预测值域不匹配”与“离群样本扰动”的核心矛盾,统计学并没有直接抛弃成熟的线性工具,而是通过广义线性模型(Generalized Linear Models, GLM)构建了一座严密的数学桥梁:不再直接预测标签,而是让线性输出去逼近某种与概率严格对应的单调变换函数。
这一桥梁的核心,正是对数几率(Logit),而最终反解出的概率计算形式,正是著名的 Sigmoid 函数。两者本质上是同一数学映射的正反两面。
3.1 正向搭桥:对数几率(Logit)的构造
我们的核心矛盾是:想做分类,需要预测正例的概率 ;但手头的武器只有线性回归 ,其值域是 。
统计学家是这样优雅地把 铺展到全实数轴 的:
- 概率 :事件发生的可能性,范围是 。
- 几率(Odds):事件发生与不发生的概率比值:
- 当 时,;当 时,。此时值域扩展到了 。
- 对数几率(Logit / Log-odds):对几率再取自然对数:
- 当 时,;当 时,。
- 值域完美覆盖了全实数轴 !
3.2 模型的诞生:为什么叫“逻辑回归”?
既然 的值域是 ,而线性模型的输出 也是 ,我们让它们直接划等号:
这个方程,就是该模型的完整理论定义! 需要强调的是,“对数几率是特征的线性函数”是一个建模假设:值域匹配只说明 Logit 是一种可行的连接函数,并不唯一强迫出它(Probit 等连接函数同样能把 映射到全实数轴)。Logit 的优势在于其可解释性(系数即对数几率的变化量)以及它是伯努利分布的典范连接函数。
- 名称解谜:该模型本质是用线性回归拟合 Logit 函数,因此在英文中被命名为 Logistic Regression。
- 历史翻译误会:早期国内学者见其词根类似 Logic,便翻译成了“逻辑回归”。但它与形式逻辑毫无关联!周志华教授在《西瓜书》中特别强调:其严谨准确的中文定名应为「对数几率回归」。它虽然名字带“回归”,骨子里却是不折不扣的分类器。
3.3 反向求解:Sigmoid 是 Logit 的反函数
当模型训练好后,计算机输入样本特征 ,算出了具体的数值 。但分类决策需要具体的概率 。
我们把上面的模型方程中的 反解出来: 两边同除以 ,得到:
这就是名震江湖的 Sigmoid 函数 !
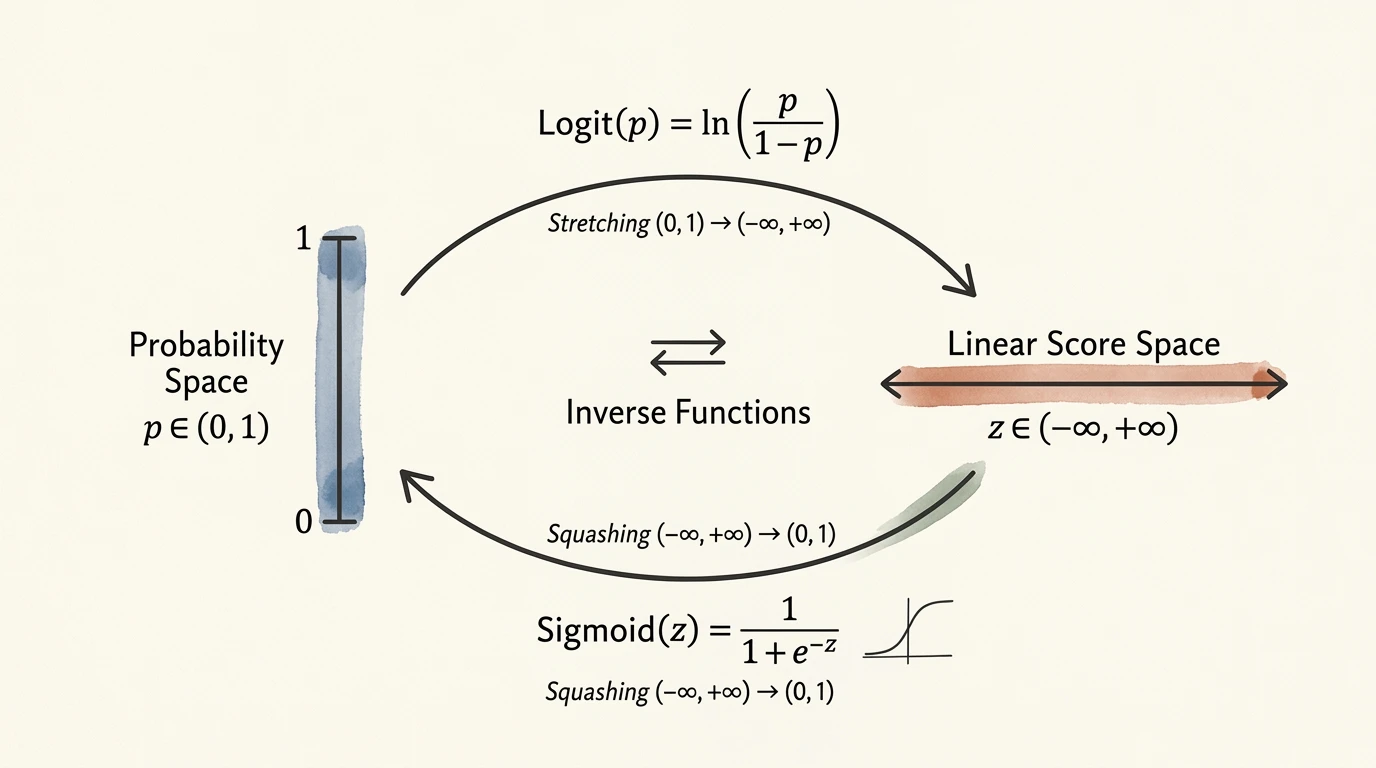 图:对数几率变换 与挤压函数 的互逆几何映射——正向将有界概率区间 拉伸至全实数轴 供线性模型拟合,反向将线性打分 重新挤压回概率空间
核心认知:
- 对数几率(Logit)是逻辑回归的物理灵魂(定义了线性模型在拟合什么目标);
- Sigmoid 函数不是凭空插进来的魔法补丁,它在代数上就是 Logit 函数的反函数,负责把模型算出的实数 重新挤压回 作为分类概率。
4. 参数求解的分水岭:从闭式解析解到数值凸优化
在定义了模型结构之后,机器学习的核心任务便转向参数估计(Parameter Estimation):我们拥有训练样本特征 和真实标签 ,但模型中的权重向量 与偏置 是未知的。如何从数据中求出这组最优参数?
4.1 为什么要“求导”?—— 极值求解的一般范式
在数学上,寻找最优参数的标准做法分为两步:
- 构造目标函数(损失函数 ):用以衡量当前参数下预测值与真实值之间的差异(例如极大似然估计导出的负对数似然损失)。学习的目标即转化为求解极小化问题:
- 驻点判定条件(微积分极值定理):根据费马引理,若损失函数处处光滑可导,其极小值点必然出现在梯度(偏导数向量)为零的驻点处:
这就是“求导”必然登场的数学原因:求导令导数等于零,是寻找最优参数解的核心方程。
4.2 求解维度的分化:解析解的终结与超越方程
正是这一步求导方程,拉开了线性回归与逻辑回归在计算复杂度上的巨大鸿沟:
-
线性回归的幸福(存在闭式解析解): 线性回归采用均方误差,损失函数是纯粹的二次型。对其求导并令梯度为零后,得到的是一个标准的多元一次线性方程组。通过基础矩阵代数移项,即可一步到位反解出显式公式(Closed-form Solution): 该公式要求 满列秩(含偏置 时把常数列并入 )。计算机只需求解一次线性方程组 ,无需任何循环迭代(数值实践中通常用 QR / Cholesky 分解求解,而非显式求逆)。
-
逻辑回归的死胡同(超越方程与迭代优化): 逻辑回归的极大似然损失函数(二分类交叉熵)包含了 Sigmoid 带来的对数与指数复合项: 对其求导并令 时,由于未知权重 同时出现在指数幂与代数项中,该方程是一个非线性超越方程,在代数上无法反解出 的显式闭式解。
4.3 救赎之路:凸优化与梯度下降
无法一步求出解析解,迫使机器学习转向数值迭代算法(Numerical Optimization): 既然不能瞬间到达谷底,计算机便从一个初始权重 出发,在每一步计算当前的梯度向量(指示局部最陡上升方向),沿着负梯度方向迭代步进:
为什么逻辑回归能放心使用梯度下降? 尽管二分类交叉熵损失无法直接反解,但其二阶导数矩阵(Hessian 矩阵)处处半正定,因此它是一个凸函数(Convex Function);当且仅当设计矩阵满列秩(,含偏置时把常数列一并计入)时,数据方向张满整个特征空间,Hessian 处处正定,损失进一步是严格凸的。凸性保证了任何局部极小值都是全局最小值,不存在“局部最优陷阱”。
但凸性的保证到此为止,以下三件事需要严格分开看:
- 唯一性:严格凸只保证最优点至多一个;
- 存在性(Albert & Anderson 准则):严格凸不保证有限极小值点存在。最简单的反例是单样本 : 二阶导处处为正,但下确界 只在 时逼近,没有有限的最优参数。在统计理论上,无正则逻辑回归存在有限最优解当且仅当正负样本集存在重叠(Overlap)且设计矩阵满列秩;若数据完全可分或准完全可分,不存在有限的 MLE;
- 算法收敛:在有限最优解存在时,梯度下降还需满足步长条件,牛顿法则通常需配合线搜索或阻尼才有全局收敛保证,原始全步长牛顿法并非对任意初始化都收敛。
💡 深入数学推导与动力学阅读:
- 二分类交叉熵海森矩阵处处半正定()的完整代数证明与单样本半正定维度分析,参见 附录 D:逻辑回归损失函数凸性(Hessian 矩阵半正定)的严格证明。
- 步长红线阈值()、不可约条件熵与无正则 MLE 发散规律,参见 附录 E:优化动力学深析 —— 步长红线、峡谷震荡与分类损失何时能趋于零。
5. 10 行 Python 极简验证:逻辑回归的梯度到底长啥样?
不需要加载 sklearn,逻辑回归在数学上的参数更新仅仅需要几行矩阵运算:
import numpy as np

# 假设 4 个样本,每个样本 2 个特征
X = np.array([[1.0, 2.0], [2.0, 1.0], [4.0, 5.0], [5.0, 4.0]])
y = np.array([0, 0, 1, 1])  # 真实标签

w = np.zeros(2)  # 初始化权重
b = 0.0          # 初始化偏置(不可省略,见下文说明)
learning_rate = 0.1

for step in range(100):
    # 1. 计算线性输出 z = X * w + b
    z = X @ w + b
    # 2. 映射为概率 p = Sigmoid(z)
    p = 1.0 / (1.0 + np.exp(-z))
    # 3. 计算误差 (预测概率 - 真实标签)
    error = p - y
    # 4. 核心魔术:梯度的形式竟然和线性回归惊人地一致!
    grad_w = X.T @ error / len(y)
    grad_b = error.mean()
    # 5. 沿负梯度方向更新参数
    w -= learning_rate * grad_w
    b -= learning_rate * grad_b

p = 1.0 / (1.0 + np.exp(-(X @ w + b)))
print("w:", np.round(w, 4), " b:", round(b, 4))
print("预测概率:", np.round(p, 4), " 预测类别:", (p >= 0.5).astype(int))
# 输出:w ≈ [0.3749 0.3749],b ≈ -1.5575
#       p ≈ [0.3935 0.3935 0.8602 0.8602],预测类别 = [0 0 1 1]
注意看第 4 步求出来的梯度 : 虽然推导过程引入了复杂的对数和指数,但经过链式法则求导后,预测概率与真实标签之差 ,居然以如此纯粹、线性的形式直接驱动梯度的演进。这种数学上的对称性与自洽,正是早期统计学习最迷人的地方。
偏置 为什么不可省略? 若去掉 (即固定 ),决策边界 被迫穿过原点。本例中任何过原点的直线都无法把两类点分开:若要求 、,两式相加得 ;而正例要求 、,相加得 ,两者矛盾。实测 100 步后 ,四个样本的概率约为 ,按 0.5 阈值全部预测为 1,训练准确率仅 50%,而此时梯度已接近零——这不是迭代不够,而是模型结构本身无法表达所需的边界。
另外需要说明:加入偏置后这 4 个点线性可分,继续迭代下去训练损失会持续下降、参数范数会持续增大,不存在有限的无正则 MLE(见 附录 E)。上面的 100 步只演示“梯度下降能找到一条正确的分界线”,并不代表收敛到了某个有限最优解。
5.1 梯度与等高线深度解析:从 3D 凸碗到 2D 俯视地图
许多人看等高线图容易犯晕,根本原因是混淆了数据空间与参数空间。要看懂梯度和等高线,只需建立起以下几何直觉:
1. 坐标系大挪移:从“看数据”切换到“看模型”
- 在前文的分类图里,横纵轴是特征 ,一个点代表一个病人/样本;
- 在等高线图里,横纵轴是权重 ,一个点代表一个完整的“AI 模型候选人”! 比如坐标 代表所有特征权重全为 0 的模型,坐标 代表另一组权重的模型。
2. 等高线是如何构造出来的?
想象一个三维立体空间:
- 地面 轴是 , 轴是 ;
- 垂直高度 轴是把这组参数代入全部训练集算出的总误差(Loss 值)!
- 我们把所有“高度(误差)相同”的参数点连成等高线(在最小值附近通常是一圈圈闭合曲线,远离最小值或在损失无有限最小值时也可能是开放曲线),就像地理测绘图一样从正上方垂直俯拍,就得到了 2D 俯视等高线图。
- 深绿/深紫色区域:海拔高,误差大(模型预测差,高山峭壁);
- 浅黄色区域:海拔低,误差小(模型预测准,谷底盆地)。
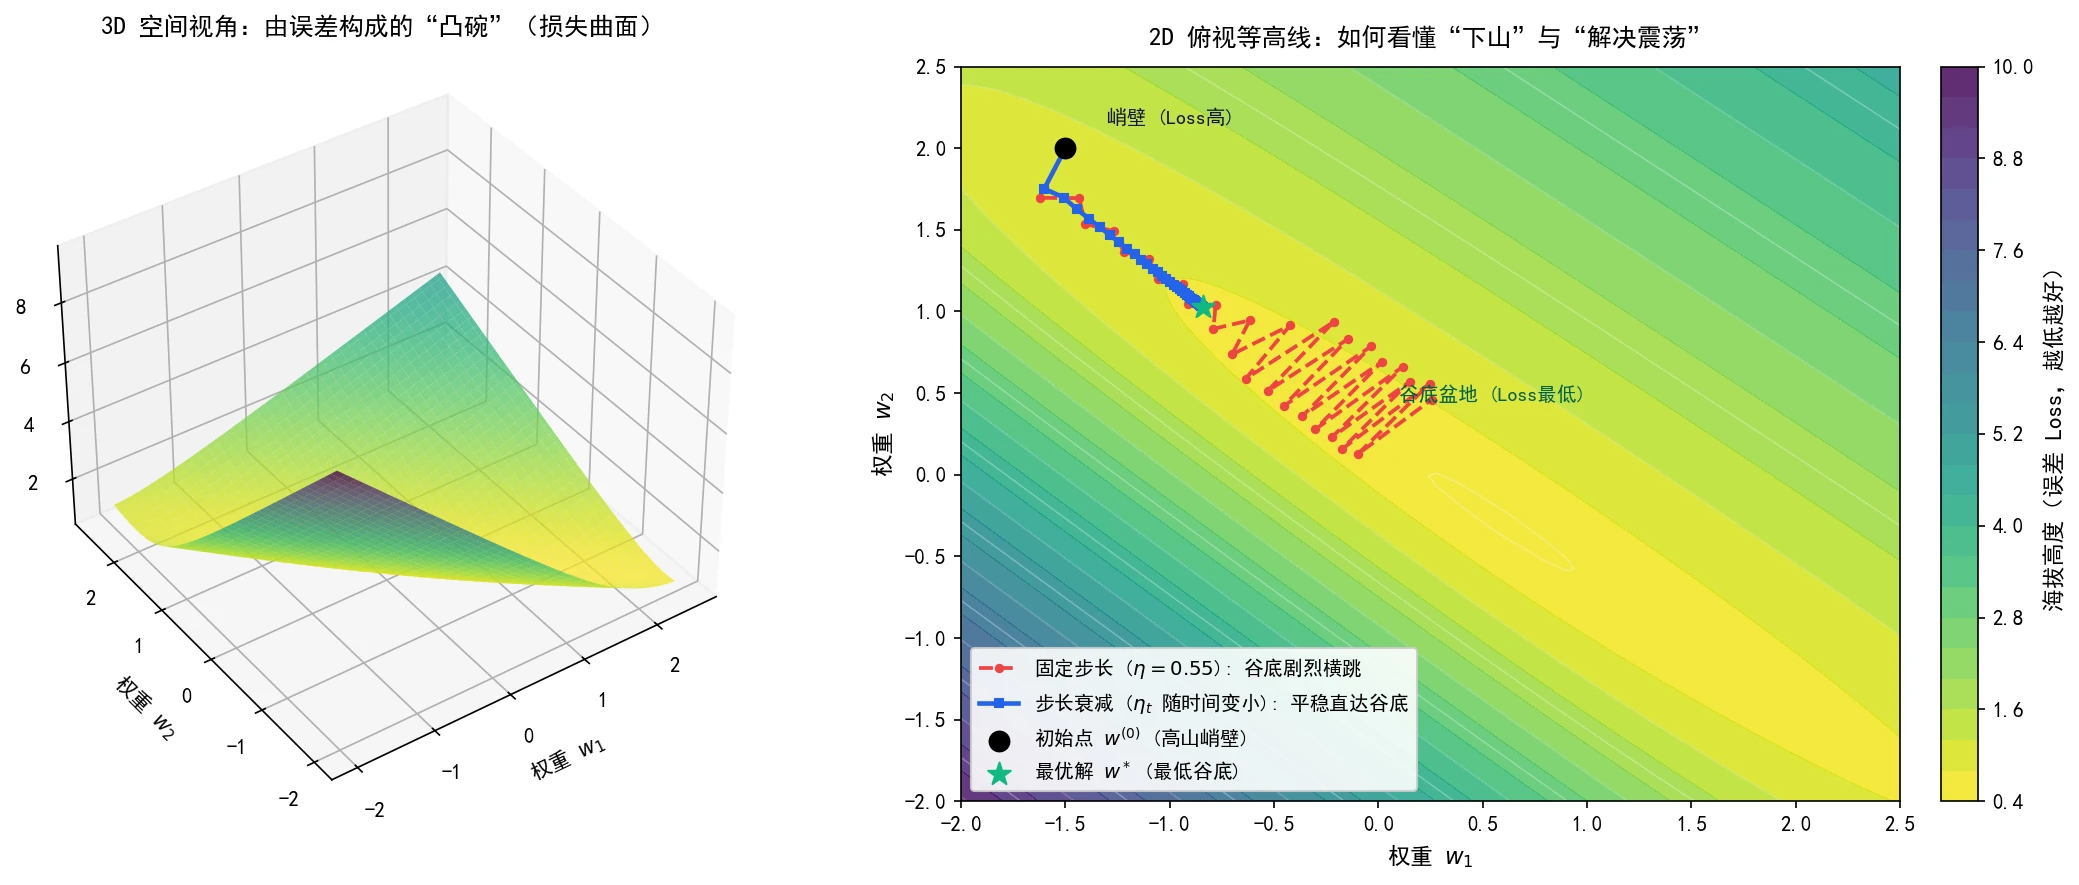 图:3D 凸碗损失曲面与 2D 俯视等高线。该图使用 6 个样本的无偏置示意数据集(),数据过原点不可分,存在有限最优解 ,绿色五角星由牛顿法精确求得。
3. 怎么看懂这幅图里的下山与震荡?
- 起点(黑圆点 ):初始猜测的模型,位于远离谷底的位置。
- 山谷的形状:最优点处 Hessian 的两个特征值约为 与 ,相差六十多倍——这就是图中“又窄又长”的峡谷:垂直于峡谷方向极陡,沿峡谷方向极缓。
- 红线(固定步长 的持续横跳): 前期沿峡谷下滑;但进入谷底后, 已超过谷底最陡方向的稳定阈值 (详见 附录 E),每一步都会跨过谷底撞到对面山壁,形成“峡谷锯齿震荡”(Zig-zagging),迭代 300 步后仍在谷底附近来回横跳,无法停在 。
- 蓝线(步长衰减 的逐步收敛): 初期步长与红线相同,同样出现锯齿;随着步长衰减到阈值以下,锯齿逐渐平息,最终抵达绿色五角星最优点 。
- 两点提醒:① 锯齿不等于不收敛——步长低于阈值时也可能出现逐步衰减的锯齿;② 衰减步长并不自动保证收敛:若衰减过快(步长总和有限),算法会在半路“冻住”,停在离最优点很远的地方。
4. 梯度的微观受力拆解:合力如何驱动每一步?
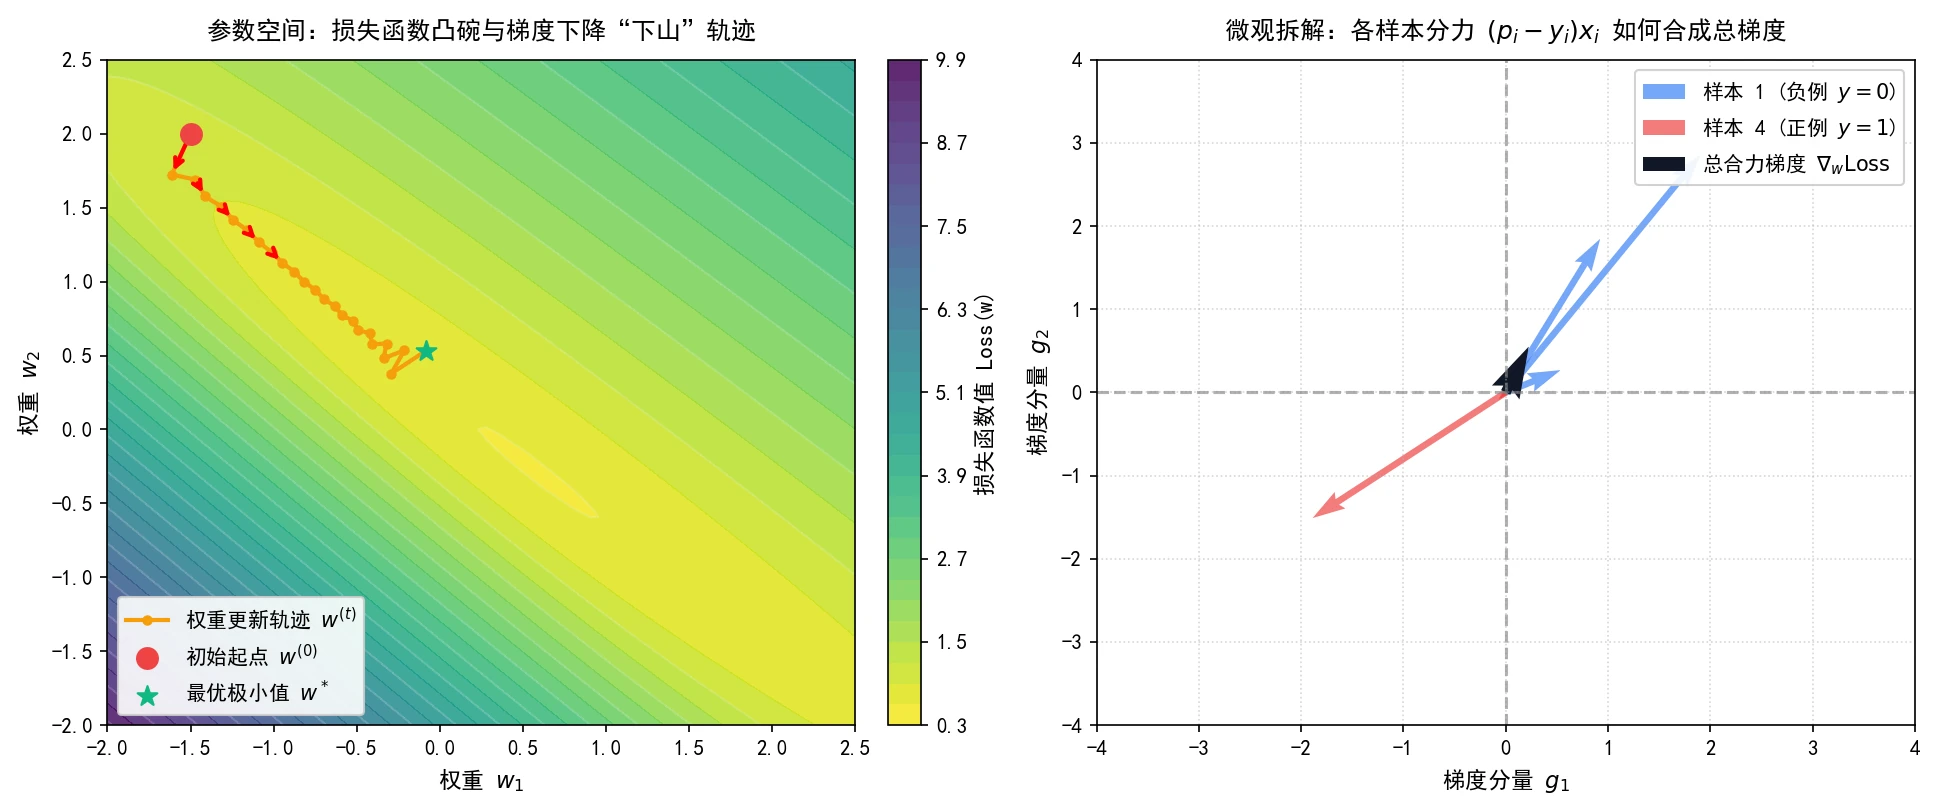 图:参数空间中的梯度下山轨迹与微观样本分力合成过程
- 梯度公式 在代数上是一次向量求和,在几何上就是一个矢量的物理合力:
- 蓝色箭头:负例样本贡献的推力;
- 红色箭头:正例样本贡献的拉力;
- 黑色粗箭头:所有样本合力生成的 总梯度向量,每一步更新正是沿着此合力的反方向推进。
5.2 训练结果映射:特征空间分界与 1D 概率挤压
梯度下降迭代一定轮数后,学到的参数 在实际数据空间中画出了清晰的分类结果:
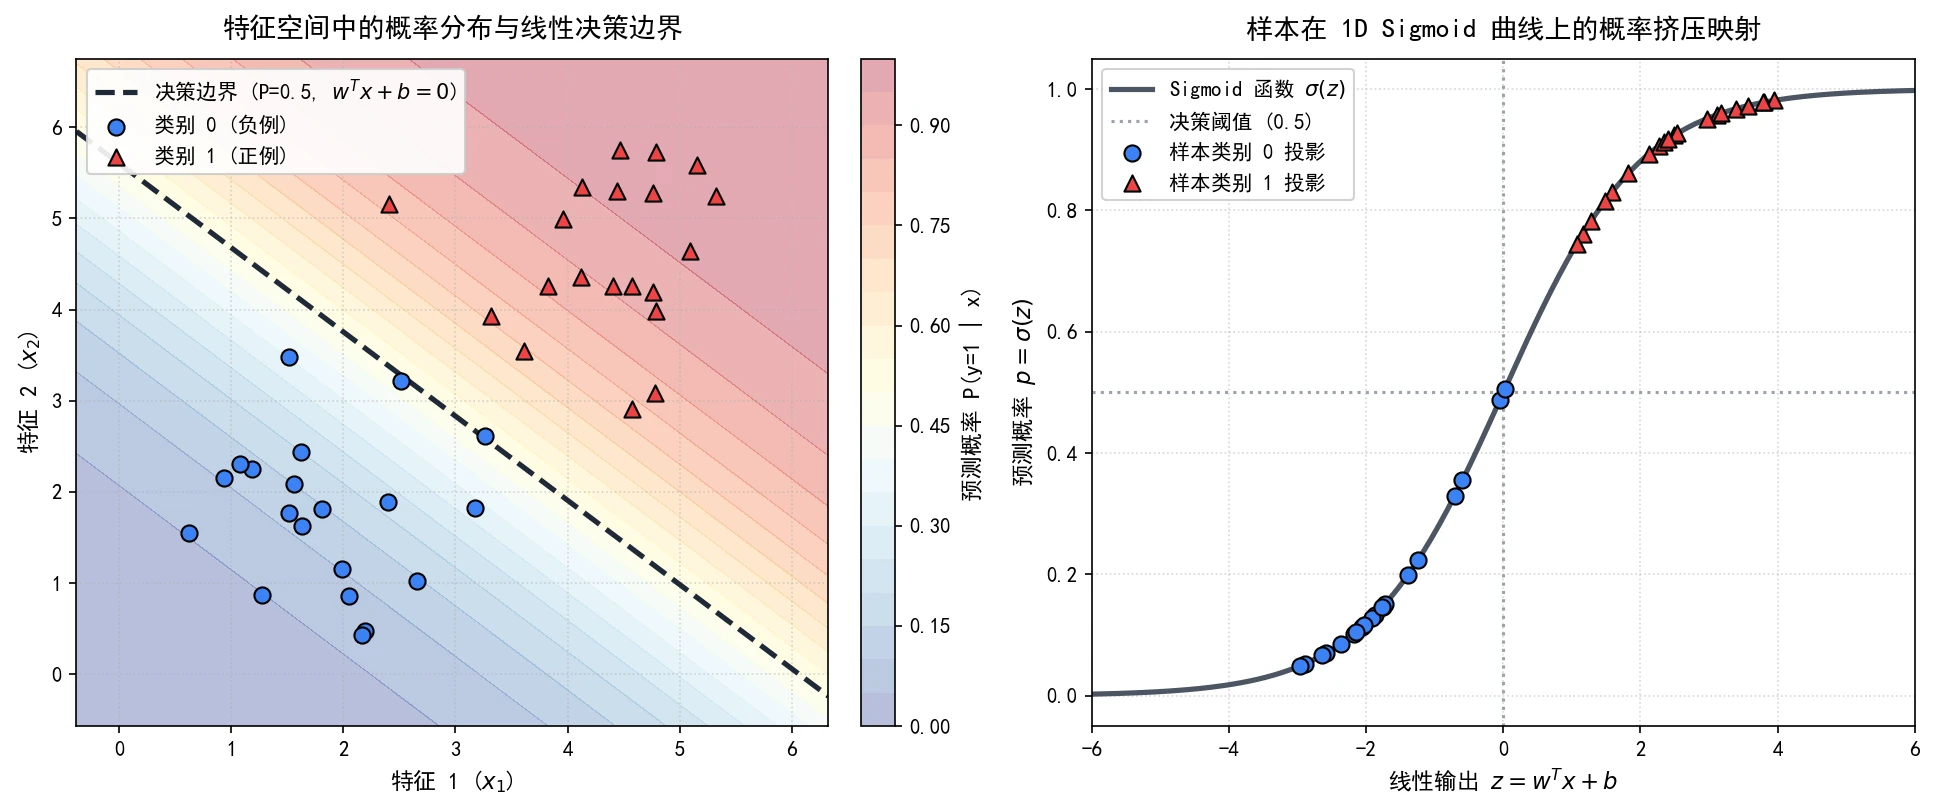 图:特征空间的二维线性决策边界(左)与投影至一维后的 Sigmoid 平滑概率挤压(右)。数据为两团各 20 个点的二维高斯样本(含偏置 、无正则化、固定步数梯度下降)。
-
左图(特征空间视角): 模型在二维特征平面上划出了一条笔直的线性决策超平面()。当且仅当样本落在该线上时,模型给出的预测概率恰好为 。背景平滑热力过渡直观展示了模型对整片空间从“极大概率负例(蓝色)”到“极大概率正例(红色)”的连续置信度过渡。
若把判定阈值从 0.5 换成一般的 ,决策面变为 ,仍是一个平行移动后的超平面。这里的“线性”是相对所用特征而言的:若先对输入做非线性特征扩展(如加入 、),边界在原始输入空间中就可以是弯曲的(这正是下一节探讨的核心)。
-
右图(概率空间映射视角): 每一个高维空间中的样本点,首先通过内积投影为一维标量 (横轴),随后被 Sigmoid 函数平滑挤压 到 的概率区间(纵轴)。远离分界线的样本被快速推向饱和区(接近 0 或 1),而临界样本则分布在斜率最陡峭的过渡区。
6. 思想跃迁:小模型叩开现代深度学习的三扇大门
走到这里,许多人会产生一个错觉:逻辑回归不过是一个二分类玩具模型,在当今千亿参数大模型时代已经过时了。
然而,正是这个看似简单的线性分类器,在历史发展中遭遇的一系列致命矛盾与突破,叩响了现代深度学习三座最核心的大门。
6.1 决策维度:为什么现实决策必须打破 0.5 阈值?
在实际工程与严肃决策场景中,逻辑回归模型给出的只是一个连续的后验概率 。然而在现实世界中,分类系统必须做出离散的行动选择(如:报警或放行、确诊或排除)。默认以 作为判定阈值,隐含了一个极其严苛且往往不切实际的假设:两类错误的破坏代价完全对等。
1. 期望风险最小化(Bayes Risk)的严格推导
- 设假阳性(False Positive,误诊)的代价为 (如健康人被误判为癌症,带来进一步抽血复检或轻度焦虑);
- 设假阴性(False Negative,漏诊)的代价为 (如癌症患者被误判为健康,导致延误黄金救治期甚至危及生命);
- 假设正确决策的代价为 0,两类误判代价非负且不同时为 0,并且 是目标人群上真实(或经过良好校准)的后验概率。面对任意预测概率为 的样本:
- 若做出阳性判断(),唯有样本真实为负例时才会犯错,期望风险为:;
- 若做出阴性判断(),唯有样本真实为正例时才会犯错,期望风险为:。
- 依据贝叶斯决策论(Bayes Decision Theory),唯有当“预测阳性的期望风险 预测阴性的期望风险”时,系统才应当介入报警:
2. 塔勒布式“非对称性”视角
- 当 时(例如设定癌症漏检的代价为误诊代价的一万倍),临界阈值 被急剧压缩:
- 这与纳西姆·塔勒布在《随机漫步的傻瓜》《反脆弱》等书中反复强调的观点高度呼应:决策时更应关注结果发生后的赔率与破坏力,而不只是事件发生的概率。需要区分的是,“两类错误代价不对称”与“损失分布是肥尾的”是两个不同的概念,前者不蕴含后者。
- 职责划分:模型算法的职责是给出尽可能校准、可靠的后验概率估计 (模型输出的原始概率并不自动等于真实后验,需通过可靠性图、ECE 等指标进行校准评估,必要时可采用 Platt 缩放或保序回归进行校准对齐);而具体的决策红线 则属于上层效用函数与风险控制矩阵的范畴。
6.2 几何维度:XOR 难题、AI 寒冬与翻越几何高墙的两大范式
1. 几何原罪:为什么一条直线切不开 XOR?
在二维特征空间中,异或逻辑(XOR)定义了 4 个样本点:
- 类别 0(负例,蓝色): 与 (输入相同);
- 类别 1(正例,红色): 与 (输入不同)。
前文已严格证明,逻辑回归在特征空间中的决策边界是一条完全刚性、笔直的线性超平面()。 几何上,两组类别分别占据了单位正方形的对角线顶点。在二维欧氏平面内,不存在任何一条单一直线能够将对角分布的红蓝点集完全分离。
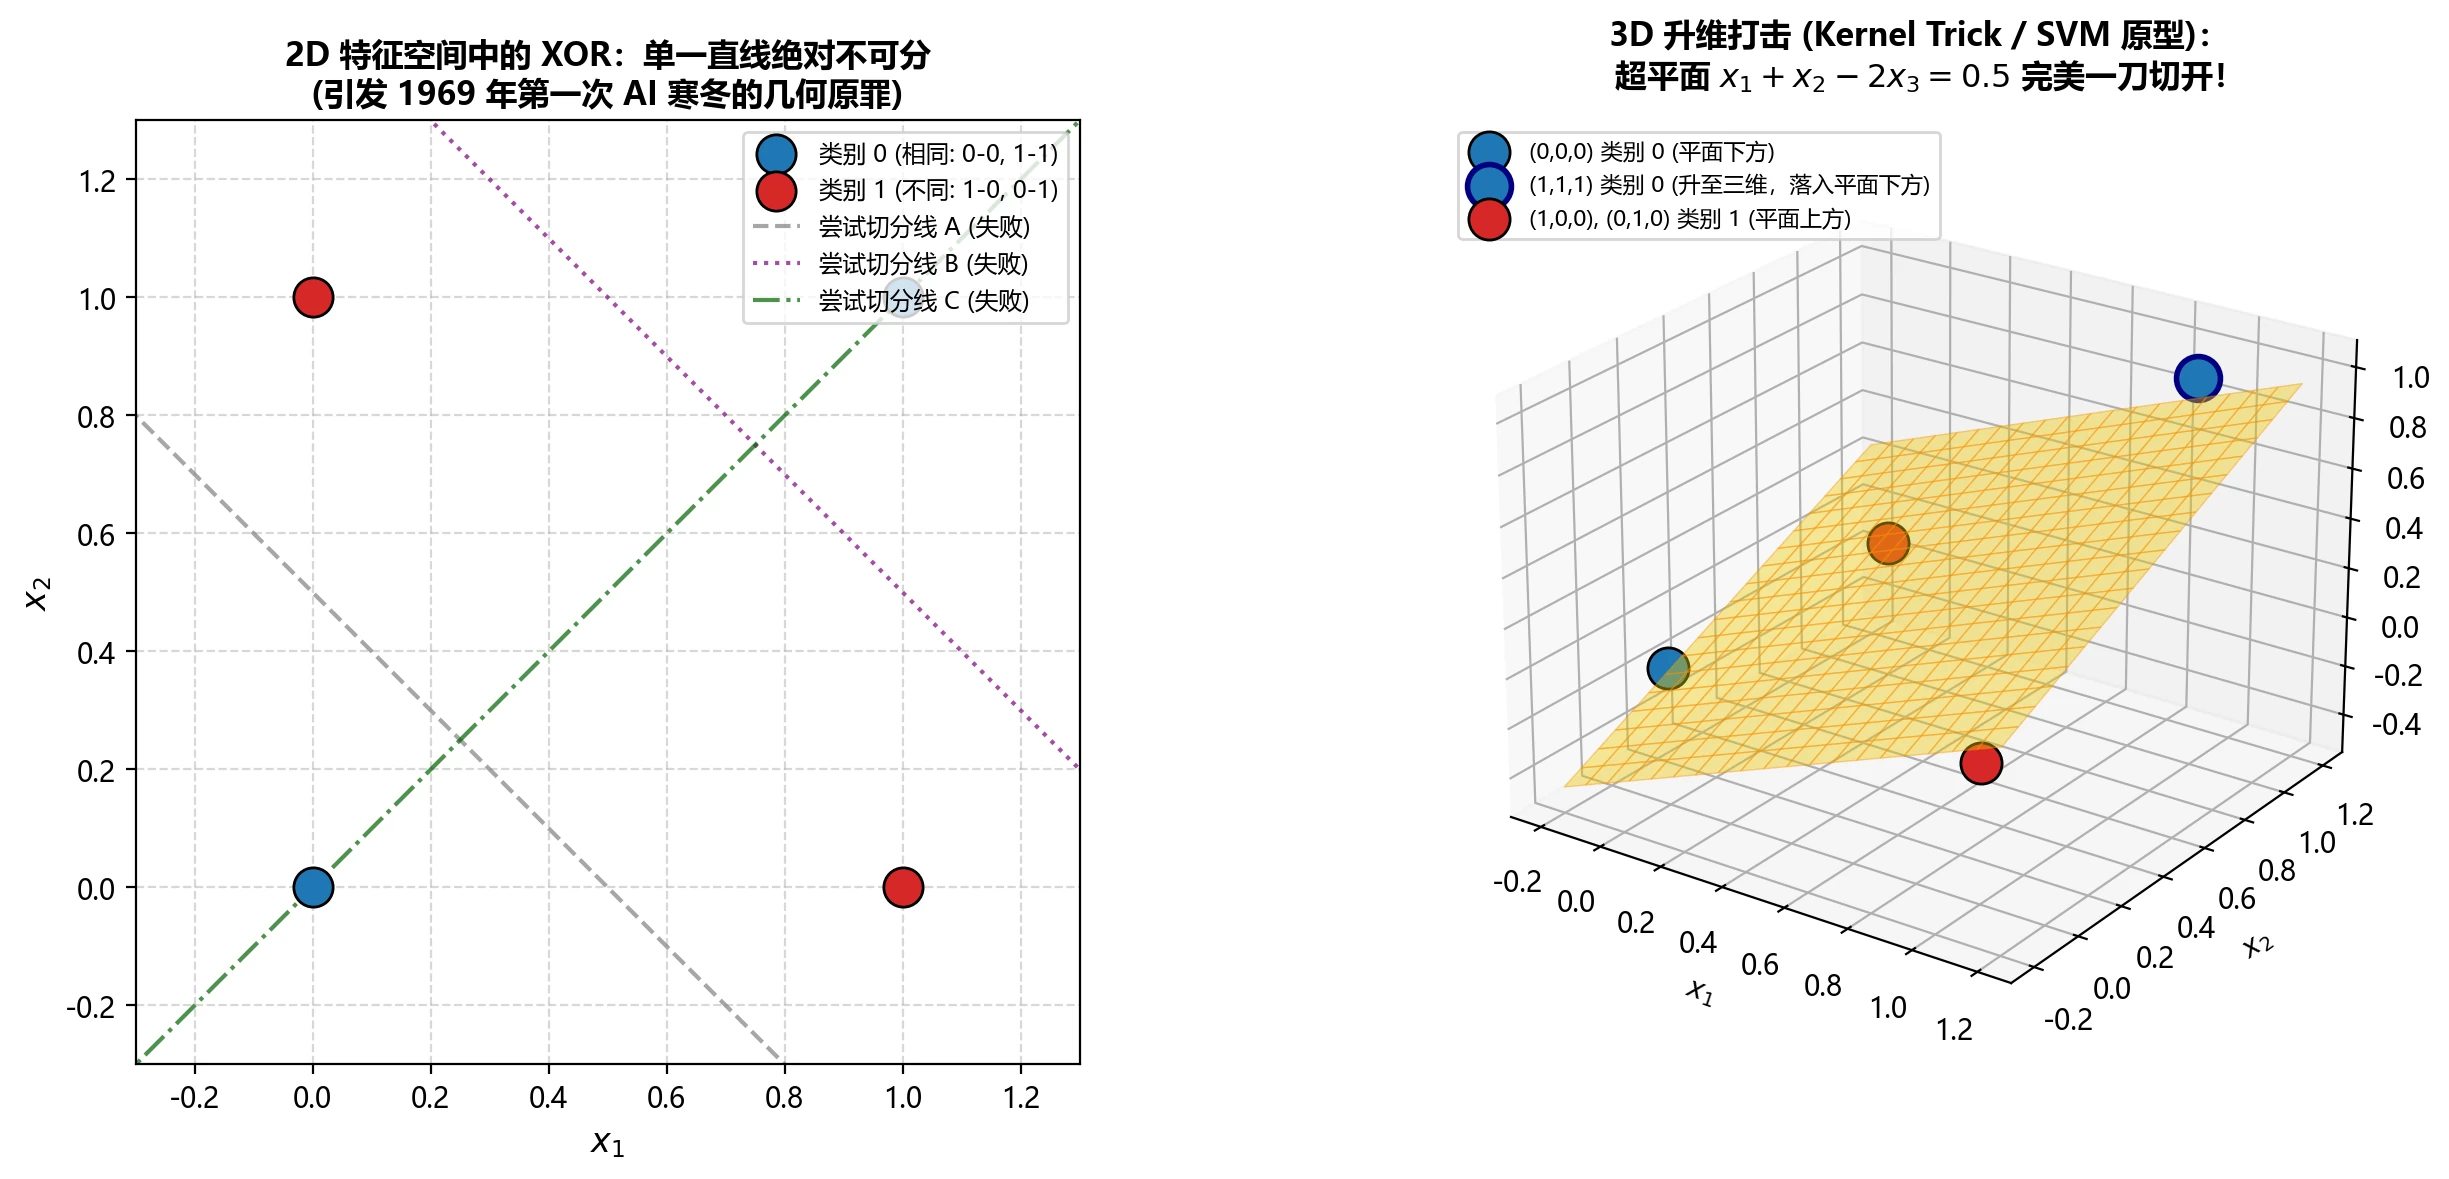 图:二维空间中不可线性分离的 XOR 异或分布,与通过非线性特征映射升入三维空间后的线性可分超平面
2. 历史公案:1969 年《感知机》与第一次 AI 寒冬
1969 年,马文·明斯基(Marvin Minsky)与西摩尔·帕珀特(Seymour Papert)出版《感知机》(Perceptrons),以严格的数学形式分析了单层感知机的表达能力局限,XOR 是其中最广为人知的例子。该书的分析深刻影响了此后一段时间神经网络研究的热度;而通常所说的“第一次人工智能寒冬”还有资金政策调整、早期过高预期落空等多重原因,不宜归结为该书的单一后果。
3. 人类翻越几何高墙的两大范式
面对单层线性模型的表达高墙,人类在随后的几十年里演进出两大经典范式:
-
范式一:统计学的升维打击(特征映射 / 核方法的几何动机): 既然在二维空间无法线性切开,便通过非线性坐标变换将数据映射至高维空间:
- 点 与两颗红色样本点因包含 0,高度仍停留在基底平面 ;
- 唯独点 因乘积为 1,被拔升至天空()!
- 此时构造一个倾斜的三维超平面:。 两颗蓝色点均处于平面下方(代数值为 ),而两颗红色点均处于平面上方(代数值为 ),实现完美线性可分。这种显式升维正是核方法(Kernel SVM 等)的几何动机;而“核技巧”本身指的是不显式计算 、只通过核函数 计算内积的算法手段。
-
范式二:连接主义的分层复合(多层感知机 MLP 与非线性激活): 单一直线无法切开对角点,但隐层可以组合多条线性切分。例如两条平行边界 与 围出条带 :两颗红色点()落在条带内,两颗蓝色点( 或 )落在条带外。(两条相交直线只能围出无界的角形区域,围出有界凸多边形至少需要三条直线。)
通过在网络中引入带有非线性激活函数(如 Sigmoid、ReLU)的隐层,神经网络可以对输入空间进行局部扭曲与折叠。通用近似定理(Universal Approximation Theorem)进一步保证:对合适的非线性激活函数,含偏置、隐层足够宽的网络可以在紧集上以任意精度逼近任意连续函数。但它只是存在性结论:不保证某个固定规模的网络足够,不保证训练算法能找到这些参数,连续函数逼近也不等同于精确恢复任意决策边界。
6.3 计算范式跃迁:高维鞍点假说、SGD 逃逸机制与 ResNet 损失景观
在逻辑回归中,我们享受了“损失函数是凸函数”带来的无与伦比的安全感:没有局部最优陷阱,只要步长合适,梯度下降终究能找到全局底座。
但一旦迈入多层神经网络(非凸世界),这种数学庇护荡然无存。深度学习究竟靠什么在崎岖险峻的非凸地形中完成参数寻优?
1. 低维直觉 vs 高维图景:鞍点假说(Saddle Point Hypothesis)
在 1 维或 2 维非凸优化的直觉里,参数空间布满了“局部死坑(Local Minima)”,使得基于一阶梯度的算法极难逃脱糟糕的局部最优解。 然而,Dauphin et al.(2014)结合统计物理中的随机场理论模型与神经网络实验,提出了一个反直觉的图景:
- 驻点二阶极值条件(二阶充分与必要条件):在无约束且二阶连续可微的问题中,对于梯度归零的内部驻点():
- 严格局部极小值的充分条件:海森矩阵严格正定(,即全部特征值 );
- 局部极小值的必要条件:海森矩阵半正定()。若驻点处存在零特征值且其余为正,单纯依靠海森矩阵无法判断极值性(例如 在 处 ,但为严格极小值;而 同样 ,却是极大值,二阶导不足以断言,需考察更高阶导数);
- 鞍点判定:若海森矩阵既有正特征值又有负特征值( 为不定矩阵),则该驻点必定是带有负曲率逃逸方向的严格鞍点(Strict Saddle)。反过来,鞍点不一定都有负特征值: 在原点 ,却仍是鞍点。
- 高维概率直觉(独立符号模型):若粗略假设驻点处各维度的特征值正负符号独立且对称(各 上坡/下坡概率),在 维空间中,全部维度同时为正曲率(满足极小值充分条件)的概率为:
- 结论的适用范围:这一计算只在上述独立符号假设内成立。真实网络的 Hessian 特征值彼此相关,并受参数对称性、数据、当前损失值以及大量零特征值的影响;在没有指定驻点概率分布时,“绝大多数”也没有严格的计数含义。因此,独立符号模型只说明“高维随机景观中鞍点可能远多于极小值”;特定理论模型与实证研究支持鞍点对优化的重要性,但不能据此断言任意神经网络的大多数驻点都是具有负曲率的鞍点。
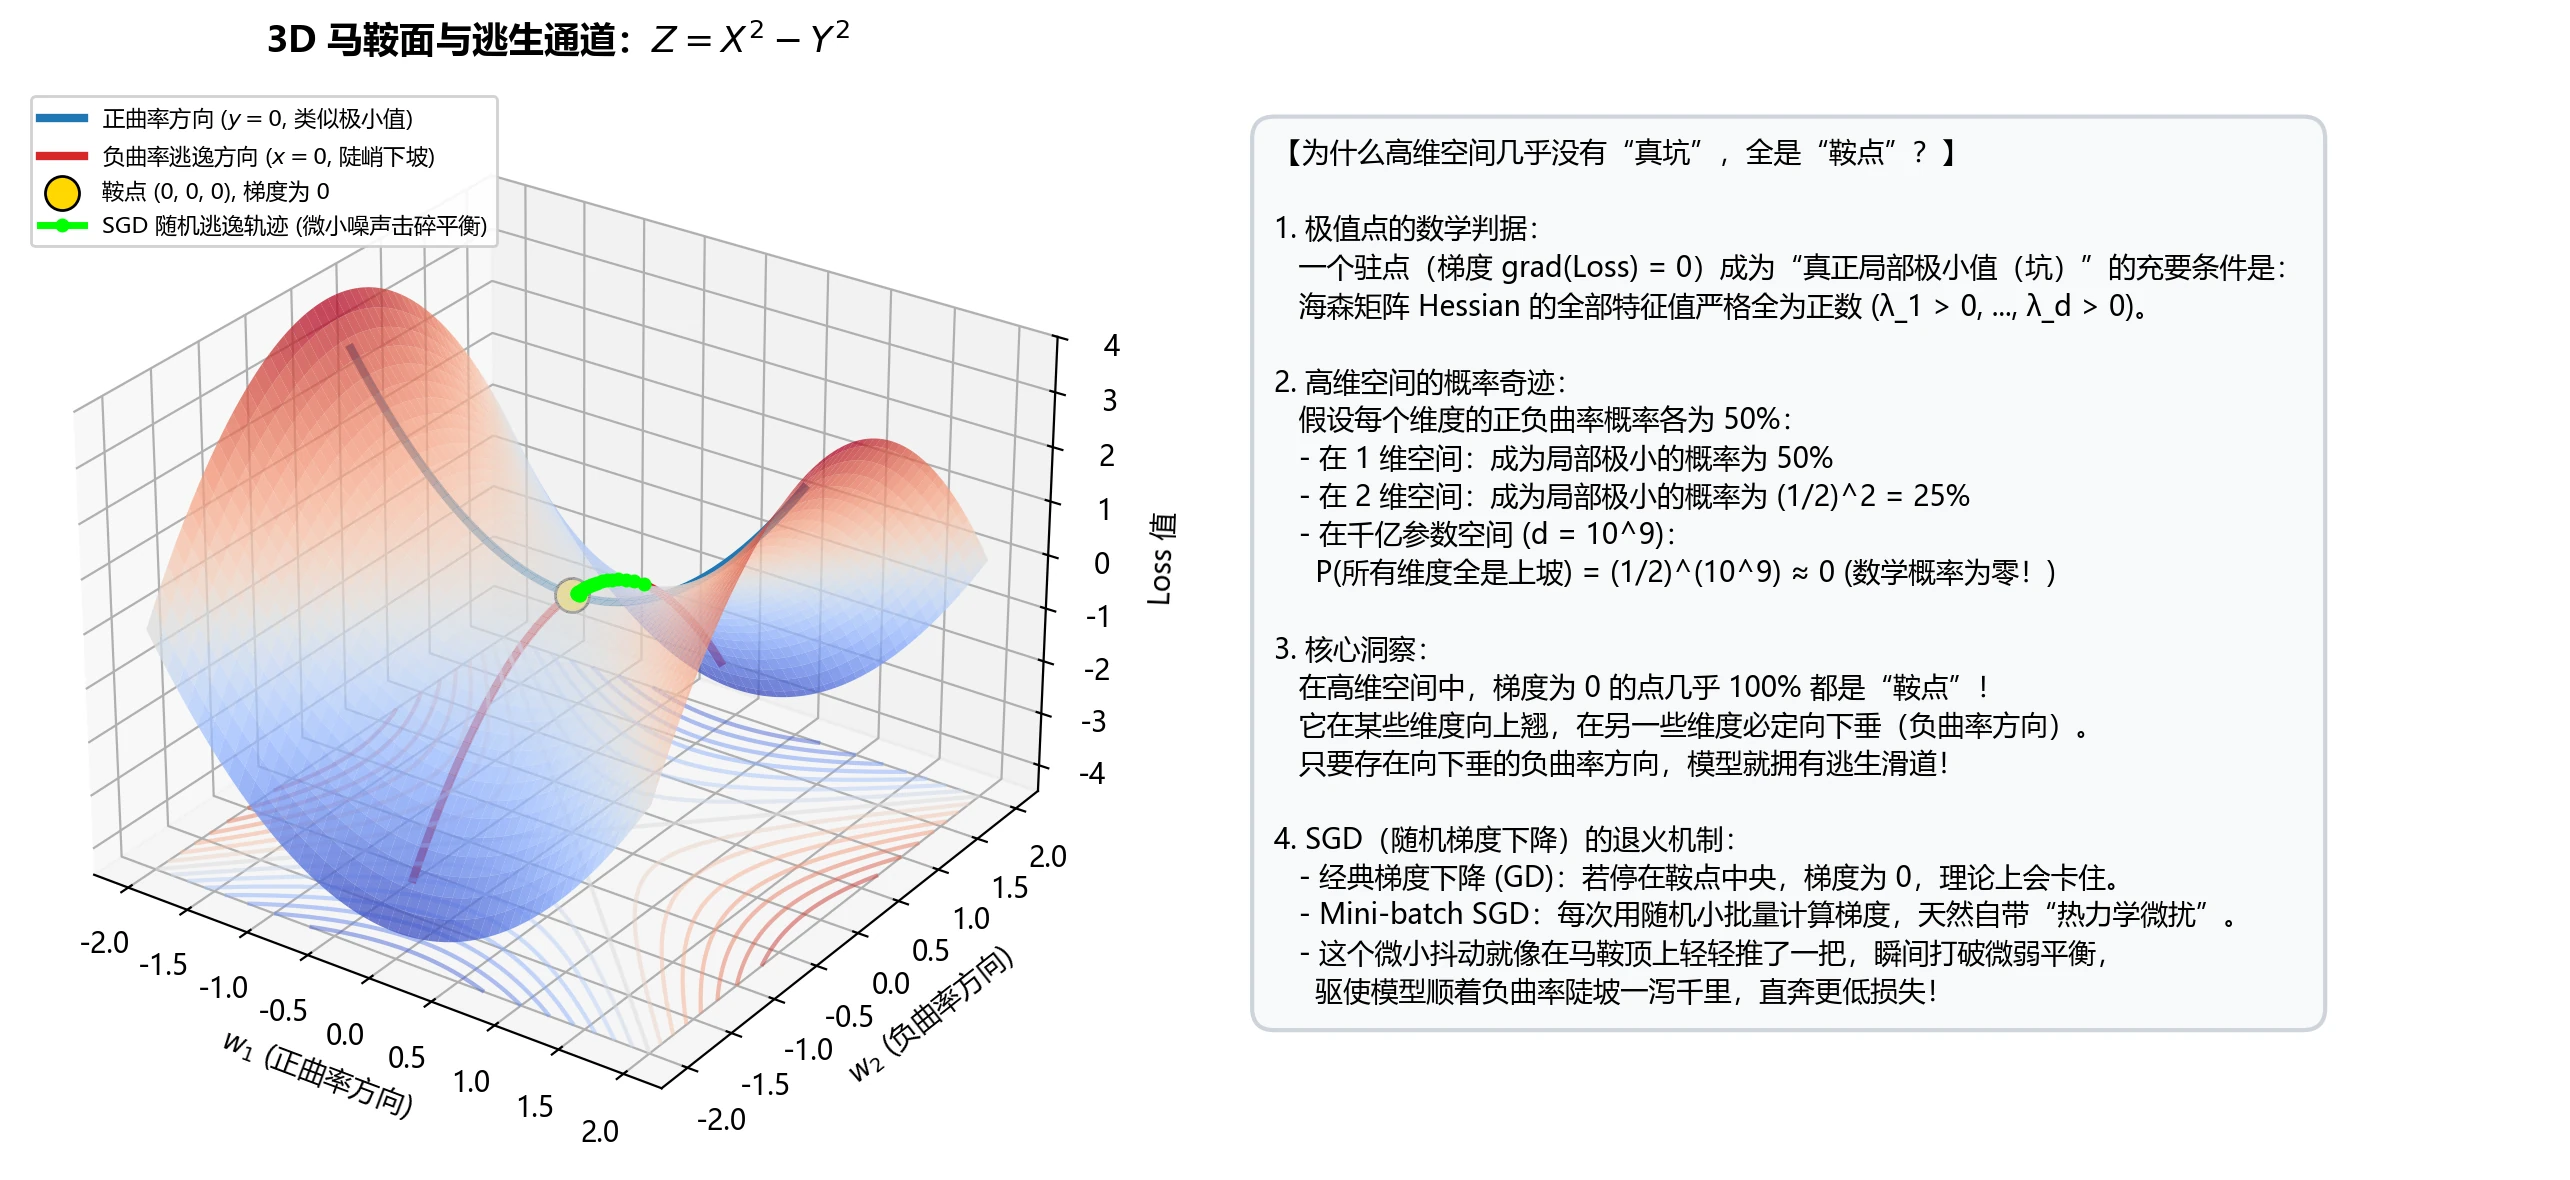 图:典型马鞍面几何结构与随机梯度微扰协助优化器逃离鞍点的动力学过程
2. SGD 随机梯度噪声与鞍点逃离
- 考察典型马鞍面 (如上图):鞍点 处虽然 ,但沿 轴方向具有负曲率()。
- 全量批梯度下降(GD)若恰好停在鞍点中央,因梯度为零会停滞;从一般位置出发时,GD 也可能在鞍点附近长时间减速。
- 小批量随机梯度下降(Mini-batch SGD) 每次仅依据子集估计梯度,引入了随机梯度噪声。当这种噪声在负曲率方向上有足够分量时,它如同在马鞍脊梁上给粒子施加一记横向推力,帮助模型离开严格鞍点、顺着负曲率方向下滑(Daneshmand et al., 2018)。
- 条件不可省略:SGD 噪声一般是各向异性且依赖参数的,可能在负曲率方向上恰好没有分量,甚至在驻点处完全为零。实际逃逸的快慢还取决于负曲率大小、步长、噪声结构与迭代时间。
3. 网络架构的几何工程:ResNet 残差连接究竟改变了什么?
Li 等人(NeurIPS 2018)在 Visualizing the Loss Landscape of Neural Nets 中引入滤波器归一化(Filter Normalization)方法,消除了权重尺度对可视化切片的扭曲,使不同架构的损失景观低维切片具备可比性,并系统研究了残差连接对损失地形的影响:
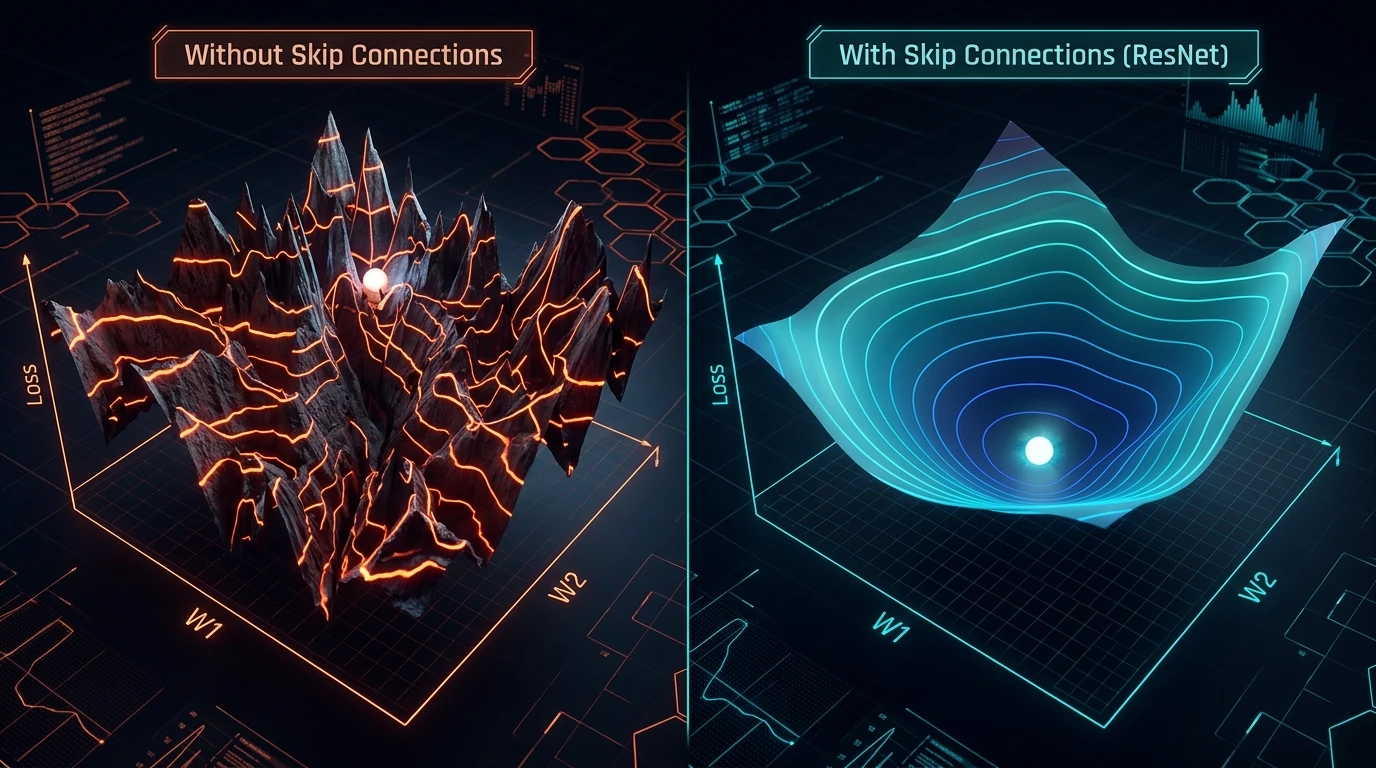 图:艺术概念对比:深层无残差网络崎岖破碎的非凸混沌地形 vs ResNet 残差跳连消除高频毛刺后的平滑低维切片
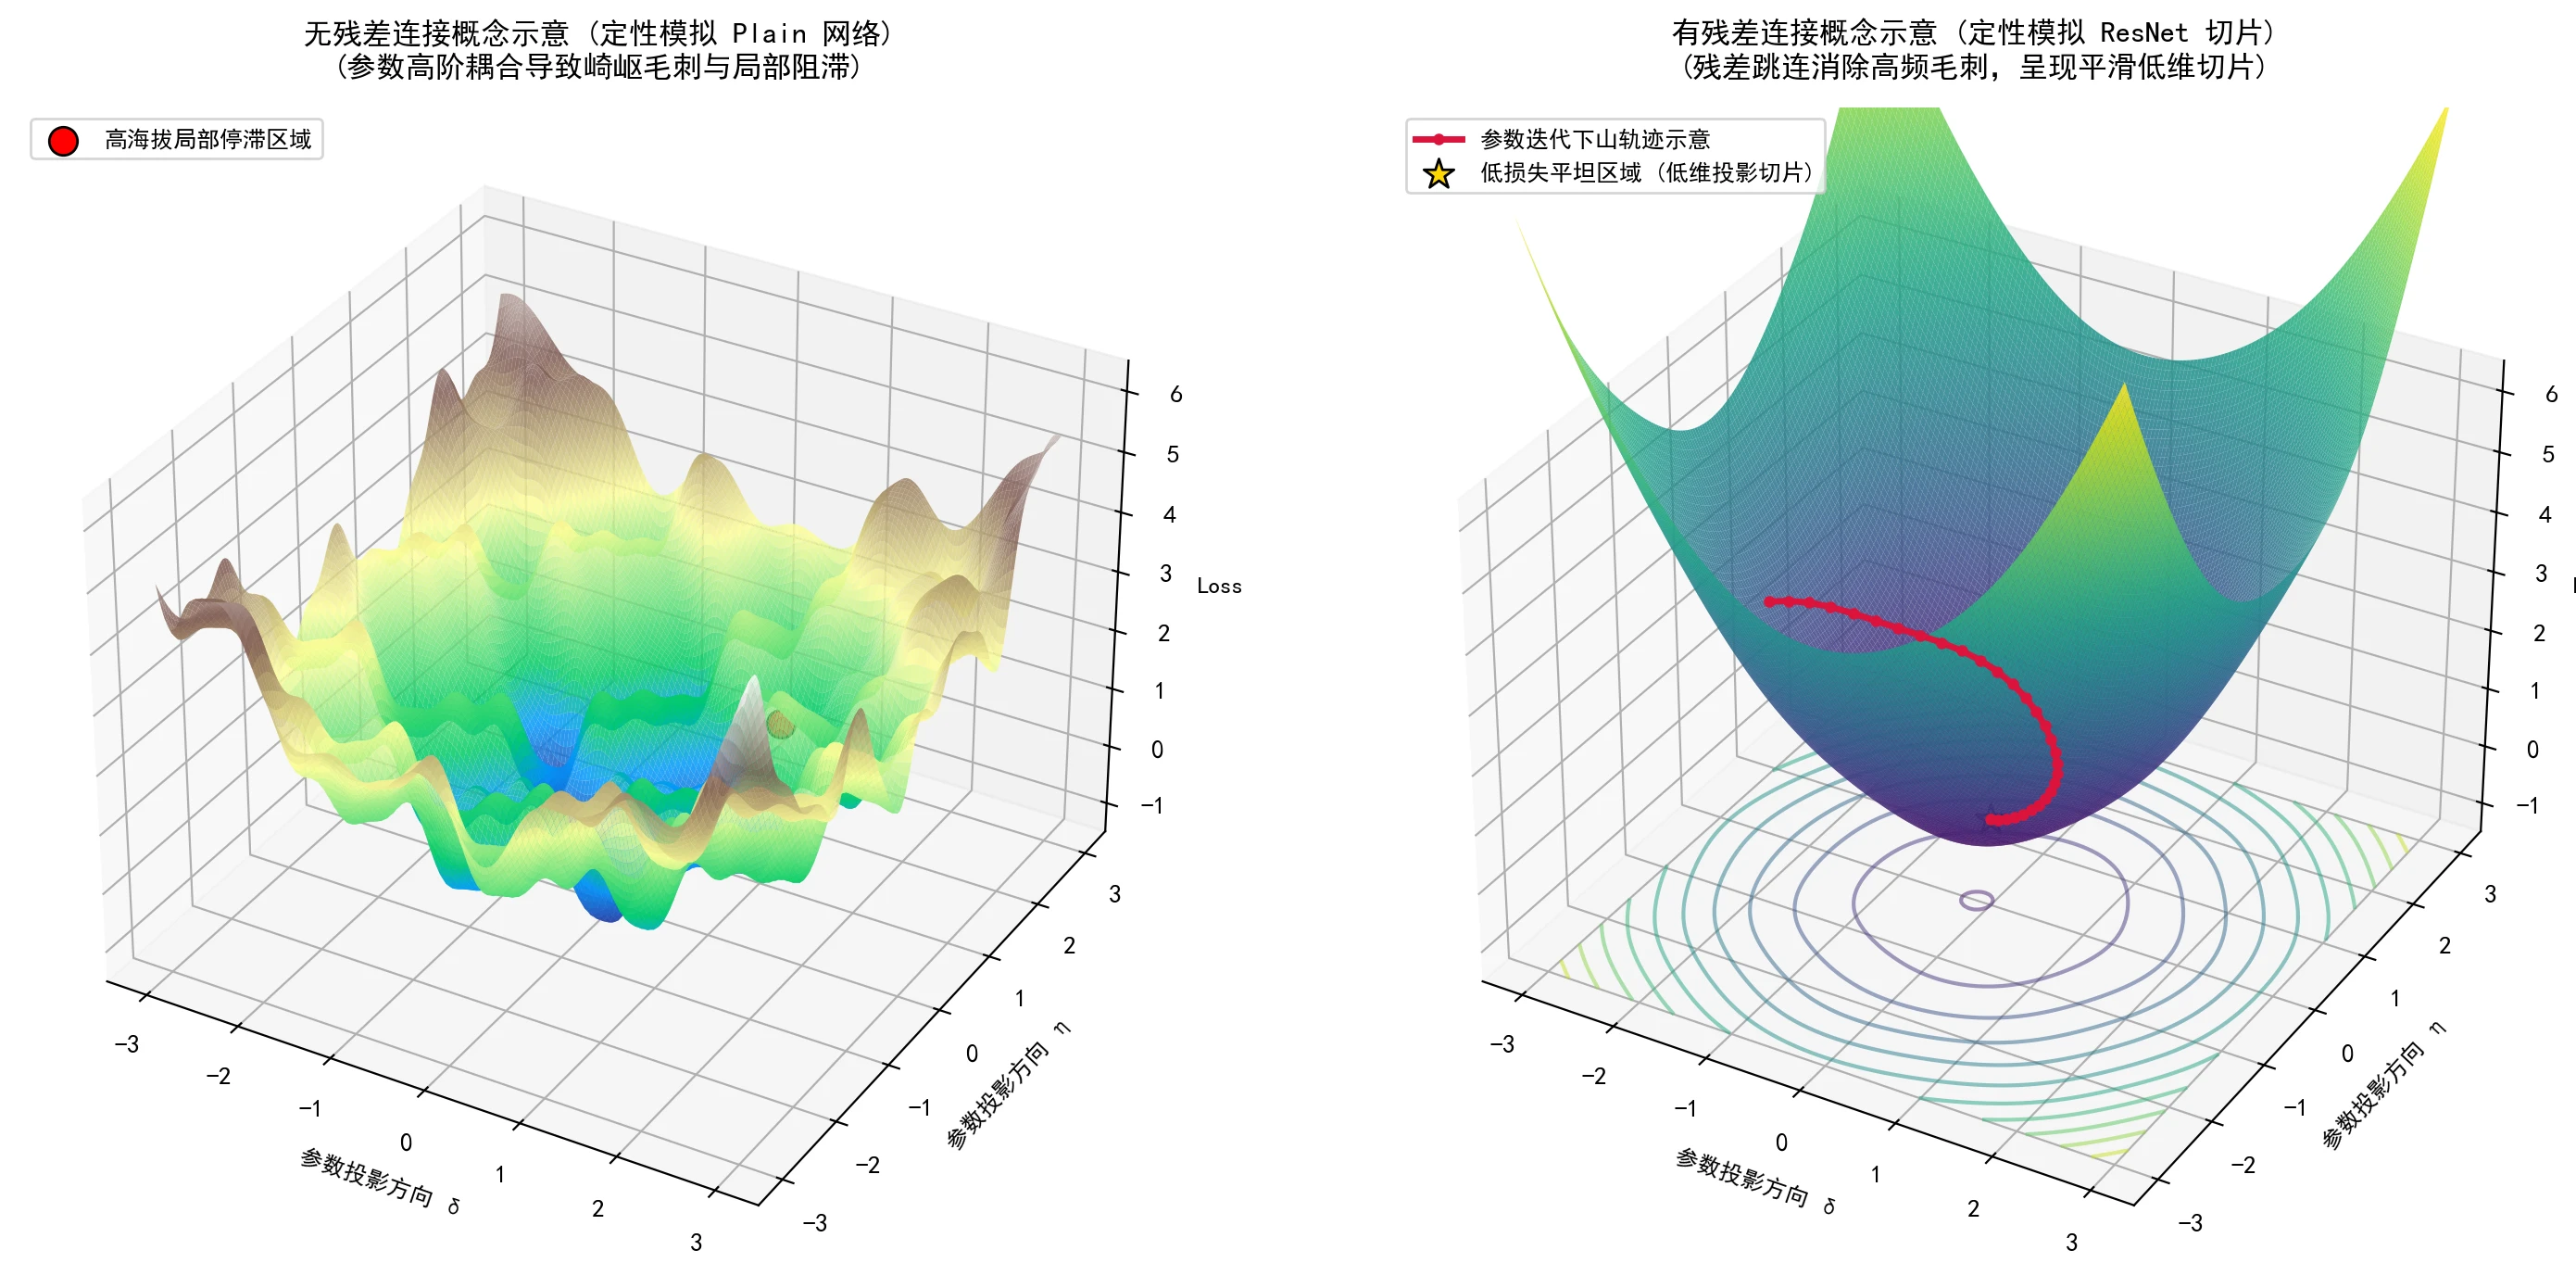 图:低维损失切片概念示意:无残差网络崎岖破碎的多局部停滞地貌(左)与残差架构下消除高频毛刺后的平滑低维切片(右)(定性模拟 Li et al., NeurIPS 2018 切片特征,非模型真实权重直接评估)
-
区分“输出特征加法”与“损失函数凸化”: ResNet 的残差模块定义为 。这里的加法发生在特征激活空间,而非给损失函数关于参数 加上了二次强凸项。 即便均方误差或交叉熵损失对于网络输出 是凸的,一旦将 展开为关于深层网络权重 的高阶非线性复合映射,损失对参数 依然是非凸的。
反例说明:设输入 ,目标真值 。残差分支为简单参数函数 ,则网络输出为 。 均方误差损失为 。 其对参数的二阶导数为 。在驻点 处,二阶导为 ! 可见,哪怕拥有残差恒等连接,参数损失曲面依然可以存在非凸与局部极大值。残差连接在数学上不能保证损失全局凸,也不能保证收敛至全局最优。
-
ResNet 真正起效的机制(He et al., 2016a, 2016b):
- 重构优化目标:深层网络退化问题源于从零逼近复杂的恒等映射较为困难;将层重构为残差学习 后,若恒等映射接近最优,优化器只需将残差分支推向零附近即可。
- 改善梯度传播(需满足恒等映射条件):在满足恒等跳连(Identity Skip Connection)且相加后不再经过额外非线性激活(即 pre-activation 形式 )的条件下,由链式法则可得浅层反向梯度展开式: 括号中的恒等项 提供了一条不经残差权重连乘的直通梯度路径,通常有助于缓解深层梯度衰减。但需要注意两点边界:① 原版 post-activation ResNet(相加后接 ReLU)或带投影矩阵的跳连还需额外计入相应的 Jacobian,不严格满足上式;② 存在恒等项 并不保证总梯度绝不抵消或消失(简单反例:单块 时输出恒为 ,;He 等人在论文中也仅指出小批量上完全抵消在经验上不太可能发生,而非数学上不可能)。
- 关于损失景观可视化的理性认知:Li 等人的 3D 损失曲面展示的是参数空间沿特定归一化随机方向所取的低维切片投影。切片表现为平滑近凸的碗状,不能证明其他万亿维正交方向也是凸的。残差跳连在工程与经验上极大改善了优化态势,消除了深层病态混沌与尖锐碎石峰峦(Spikiness),使一阶优化器在实际训练中更易找到泛化良好的低损失解,但这并不提供全局凸性或全局最优解的数学保证。
7. 本章核心总结与认知闭环
回顾本章的推导演进,我们实际上完成了一次从古典统计测量到现代深度学习的壮丽跨越。整个知识架构由五大支柱严密串联:
| 演进环节 | 核心数学/统计工具 | 解决的关键问题与认知飞跃 |
|---|---|---|
| 1. 连续值拟合 | 误差高斯假设 + CLT 渐近建模动机 + 极大似然估计 | 解释了为什么损失要用“平方和”:在条件独立、同方差高斯噪声假设下,最小二乘等价于 MLE。CLT 说明了正态近似的合理性,但不证明有限次叠加必定精确服从正态。 |
| 2. 分类目标搭桥 | 对数几率变换 | 打破值域不匹配:将 概率拉伸到全实数轴,使线性回归工具得以复用。 |
| 3. 概率恢复计算 | 反函数 Sigmoid | Logit 的代数逆运算,负责把高维线性超平面的输出实数平滑挤压回概率空间。 |
| 4. 计算范式转移 | 超越方程 + 凸优化(梯度下降) | 告别了解析解,依靠损失函数的凸性(Hessian 半正定,满列秩时严格凸)数值寻优;凸性排除了非全局极小值,但有限最优解存在性(依赖正负样本重叠条件)与算法收敛仍需额外保障。 |
| 5. 几何与现代跃迁 | 决策边界 + 升维/非线性 + 高维鞍点动力学 | 认识到线性决策面的刚性极限(XOR 难题);领会从特征工程升维到多层深度复合的演进;理解高维非凸优化如何依靠鞍点逃生与残差连接改善损失地形(低维切片平滑,非全局凸保证)。 |
从本章迈向下一站:本章建立的最小二乘与逻辑回归,底层思想完全建立在费雪的极大似然估计(MLE)之上——即只依据当前观测数据来估计参数。然而,当样本匮乏或参数空间过于灵活时,纯粹的 MLE 极易被局部抽样噪声绑架而走向过拟合(Overfitting)。下一站我们将把贝叶斯先验请回模型,从最大后验估计(MAP)推导出 正则化的等价性。
📖 深度附录(数学与理论底座)
本附录提供正文主干所依赖的严密数学证明、历史溯源与理论边界推导,供需要严格求证的读者查阅。
附录 A:高斯做出“误差正态分布”假设的历史背景与逆向自洽推导
这一假设与 1801 年谷神星(Ceres)在被观测 41 天后失踪的轨道测算问题密切相关。高斯在 1809 年的《天体运动论》中系统给出了误差正态分布与最小二乘的联系。这里有一段极富启发性的统计学公案:高斯当年提出正态误差假设时,其实并没有依赖中心极限定理(CLT)!
- 高斯的 1809 逆向推导(算术平均公理): 当时天文学界公认“多次测量的算术平均值是最优估计”。高斯反问:若算术平均值确实是真实位置的极大似然估计(MLE),误差分布在数学上必须服从什么函数? 在误差密度为正且光滑、构成位置族、并要求对任意样本量与任意样本取值都成立等条件下,倒推函数方程可得唯一解为正态分布 。高斯实际上是用“算术平均最优”倒逼出了正态分布,而非从微观微扰叠加推导而来。
- 拉普拉斯的 1810 物理动机(CLT 登场): 高斯的方法发表后,法国数学家拉普拉斯(Laplace)在 1810 年敏锐地指出高斯的算术平均公理在逻辑上略显循环。拉普拉斯利用特征函数法证明了早期形式的中心极限定理(CLT),并指出:天体观测中存在大气微气流折射、金属镜筒热胀冷缩、齿轮微小机械间隙、天文学家按秒表的生理反射延迟等微观独立随机扰动。拉普拉斯的洞察为正态误差假设补齐了重要的理论动机。注意这是大样本极限下的渐近结论,并不保证任何有限次叠加的微观噪声精确服从正态分布。
- 高斯的 1821 彻底解放(高斯-马尔可夫定理 BLUE): 高斯在晚年(1821–1823)意识到依赖正态分布的假设依然局限。于是他更进一步证明了:哪怕噪声根本不是正态分布,只要满足零均值、同方差且互不相关,普通最小二乘估计量依然是所有线性无偏估计中方差最小的(Best Linear Unbiased Estimator, BLUE)! 这就是著名的高斯-马尔可夫定理。从此最小二乘法彻底摆脱了正态假设的束缚。
附录 B:中心极限定理(CLT)的频域(特征函数)极简推导
为什么在一定条件下,不管单项微扰的原生分布长得多奇形怪状,大量叠加并归一化后其分布都会趋近高斯钟形曲线?
- 核心工具:独立变量之和的分布是各自分布的卷积,而傅里叶变换(特征函数 )能将复杂的卷积转化为简单的代数乘法。
- 推导脉络:
- 假设各微扰 独立同分布,标准化为 (即方差有限且非零)。归一化和为 。
- 单变量特征函数泰勒展开(只需二阶矩存在):。
- 项独立叠加在频域连乘:。
- 利用基础微积分极限 ,令 ,直接得到 ,这正是标准正态分布的特征函数。
- 由 Lévy 连续性定理:特征函数逐点收敛到一个在 0 处连续的极限函数,则对应的分布依分布收敛到该极限分布。因此 。注意这是分布函数的收敛,而非密度的收敛:例如 等概率取值的离散变量,其归一化和对任何有限 都没有密度,却同样满足 CLT。
- 启示与边界:
- 推导只用到了二阶矩,三阶、四阶矩甚至可以不存在;归一化后,高阶信息在极限中不再体现,宏观上只剩均值与方差决定的高斯形状。
- 条件不可省略:独立 Cauchy 变量(方差无穷)的样本均值仍服从同一 Cauchy 分布,永远不会高斯化;非同分布情形需要 Lindeberg 等额外条件。
- CLT 是关于极限的定理,它为“噪声近似正态”提供了建模动机,但不证明任何有限次叠加的真实噪声精确服从正态。
附录 C:为什么极大似然估计(MLE)是统计学与机器学习的通用母题?
-
建模流水线的一致性: 只要为观测数据选定一个条件分布(似然模型)(实数误差选高斯、二分类选伯努利、多类别分类选类别/多项分布),目标损失函数立即由联合似然取负对数自动生成,无需人为主观拼凑准则。注意这里指定的是观测的分布 ,而非参数的先验 ,后者是第二站 MAP 的主题。
-
信息论视角的统一性: 对离散数据(如分类标签、词元),在共同支撑等条件下,平均负对数似然满足: 其中经验熵 与 无关,因此最小化 NLL 等价于最小化经验分布与模型分布之间的 KL 散度。大语言模型的 Next-token 交叉熵训练本质上正是巨型 MLE。
对连续密度模型,经验分布由点质量构成, 通常为无穷,不能直接套用上式;此时应理解为:经验 NLL 是总体期望负对数密度的样本近似,而总体目标(在熵与 KL 良定义时)等价于最小化 。
-
统计渐近最优性: 在模型正确指定、参数可识别、固定维数、真参数位于参数空间内部、满足光滑性与可交换微分积分、Fisher 信息非退化等正则条件下,MLE 一致且渐近正态,其渐近方差达到 Fisher 信息的逆(即 CRLB 的渐近版本),在正规估计量中渐近有效。
这是渐近性质:有限样本下 MLE 通常有偏,也不必达到 CRLB;参数位于边界、支撑集随参数变化,或参数维数随样本量增长时,上述结论都可能失效。
附录 D:逻辑回归损失函数凸性(Hessian 矩阵半正定)的严格证明
二阶连续可微的多元函数在开凸集上为凸函数的充分必要条件是其海森矩阵(Hessian Matrix)处处半正定();若海森矩阵处处严格正定(),则函数为严格凸函数(这是充分而非必要条件,例如 严格凸但 )。严格凸只保证极小值点至多一个,并不保证它存在。
-
化简单样本损失(Softplus 形式): 记 ,。利用 ,二分类交叉熵可整合成:
-
一阶梯度向量:
-
二阶海森矩阵: 利用 Sigmoid 导数 ,对梯度再求一次导:
-
二次型非负性验证与维度分析: 对于任意非零向量 :
- 伯努利方差项:因 ,必有 ;
- 投影平方项:实数平方必有 。 因此 恒成立,海森矩阵处处半正定()。
维度与秩的精确边界: 单样本外积矩阵 的秩恒为 1。在特征维度 时,该矩阵必然存在 个零特征值;对于任何与特征向量 正交的方向 ,均有 。因此在多维空间()中,单样本的 Hessian 矩阵严格只能是半正定,绝不可能是严格正定的。
-
数据集总损失与满列秩条件: 总海森矩阵 ,其中 的对角元在有限参数处全为正。当且仅当设计矩阵 满列秩(,含偏置时包含常数列) 时,数据方向张满整个参数空间,才有 。
推论总结:
- 逻辑回归的负对数似然是凸函数;在设计矩阵满列秩时是严格凸函数。严格凸保证最优点至多一个(唯一性)。
- 有限最优解的存在性需额外条件:严格凸并不自动保证有限极小值点存在。根据 Albert & Anderson (1984) 的经典统计定理,无正则逻辑回归存在有限最优解的充要条件是正负样本集存在重叠(Overlap)且设计矩阵满列秩;若数据完全可分(Complete Separation)或准完全可分(Quasi-complete Separation),下确界 仅在参数范数发散至无穷时逼近,不存在有限的 MLE。
- 在有限最优解存在时,适当步长的梯度下降(参见附录 E)或带线搜索/阻尼的牛顿法可在相应条件下收敛;原始全步长牛顿法并不对任意初始化保证收敛。
附录 E:优化动力学深析 —— 步长红线、峡谷震荡与分类损失何时能趋于零
在数值优化与梯度下降的实际演进中,存在着数个深刻决定模型行为的动力学规律:
-
分类交叉熵损失能否趋近于零?要分“总体”与“训练集”两个层面:
- 总体层面(不可约噪声 / 条件熵):对任意模型 ,总体期望交叉熵满足恒等式 因此总体最小期望交叉熵为条件熵 。若现实中存在特征相同但标签不同的情形(如生理指标相似但患病状态不同的个体),则 ,这是不可约的噪声下界。 它的大小取决于真实条件概率:若 ,最优预测就是 ,此处条件熵约为 ;只有当 时才达到二元熵的最大值 。注意这是总体期望的下界,不是每个样本损失的下界。
- 训练集层面(可分数据与参数发散):有限训练集即使来自有噪声的总体,也完全可能线性可分。此时对正确标签的概率趋于 1,等价于有符号间隔 ;无正则逻辑回归的训练交叉熵可以趋于 0,增广参数 的范数发散,不存在有限 MLE(若所有样本都是正例,只需让 即可)。
- 发散条件与校准质量的辩证关系: 参数范数发散会将输出概率机械地推向 和 的极值。若真实环境中的条件分布存在不可约噪声(即真实后验并非退化的 或 ),这种过度自信会显著损害概率校准质量(Calibration Error 增大);但若真实生成机制本就是确定性无噪声的,概率推向 或 则属于有效收敛,不必然代表校准崩溃。
- 隐式偏差(增广最大间隔 vs 通常硬间隔 SVM): 理论上,对线性可分数据,适当步长的一阶梯度下降尽管参数范数发散,其参数方向 会渐近收敛到最大间隔方向(Soudry et al., 2018)。需要注意:若模型包含偏置 并作为增广参数 共同由无正则梯度下降更新,其渐近方向收敛到的是增广特征空间中的最大间隔解(等价于对偏置也施加了范数惩罚的间隔分离超平面);这与传统几何上偏置不计入范数惩罚的标准硬间隔 SVM(Standard Hard-margin SVM)解存在细微的数学差异。
-
梯度下降的步长红线(L-光滑条件): 若梯度 在算法所经区域上是 -Lipschitz 的(即 Hessian 的最大特征值在该区域内有统一上界 ,而不是某一点的局部曲率),且 凸、最优解存在,则固定步长 可保证标准梯度下降收敛。需要注意:
- 这是充分条件,不是对每个函数、每个初值都必要。对正定二次型 ,该区间恰好是“对所有初值都收敛”的精确范围,阈值为 。
- 反例:,,。从 出发取 ,迭代为 、,照样收敛——因为高曲率方向从未被激发。
- 步长超过某方向的稳定阈值时,参数在该方向上越过谷底撞向对侧,形成“峡谷锯齿震荡”(Zig-zagging)乃至发散(见 5.1 节红线);但反过来,出现锯齿不等于不收敛,阈值以下也可能出现逐步衰减的锯齿。
-
成熟优化库的停止准则与步长策略:
scipy.optimize、scikit-learn等库中的求解器通常同时提供最大迭代次数(如max_iter)与一种或多种容差停止准则(如tol),具体定义与默认阈值因求解器而异:有的检查梯度范数,有的检查参数或损失的相对变化,SGDClassifier默认则是“连续若干个 epoch 损失改善不足tol”即停止,也可设tol=None仅受max_iter约束。- 步长策略与线搜索准则:
确定性求解器(如 L-BFGS、牛顿类方法)常依赖线搜索确定步长:
- Armijo 准则(充分下降条件)与回溯线搜索:要求目标函数下降量至少达到梯度预期的常数比例:。标准回溯线搜索(Backtracking Line Search)从一个较大的试探步长出发,只要不满足 Armijo 条件就按 ()收缩步长,直到满足充分下降;
- Wolfe 条件(充分下降 + 曲率条件):拟牛顿法(如 BFGS/L-BFGS)为了确保海森逆矩阵更新的正定性,通常需要强 Wolfe 条件(Strong Wolfe Conditions),即在 Armijo 充分下降的基础上,额外引入曲率条件(Curvature Condition) ,以防止步长过小。
- 梯度很小或损失变化很小只是数值停止判据,并不自动证明已到达全局最优:步长过小同样会让损失几乎不变。
- 步长策略与线搜索准则:
确定性求解器(如 L-BFGS、牛顿类方法)常依赖线搜索确定步长: