本篇导读:在上一篇中,我们看到最小二乘与交叉熵背后共享着同一个引擎——极大似然估计(MLE)。但完全信赖观测数据的 MLE 在小样本或高维空间下极易走向过拟合与概率坍缩。本篇我们将引入贝叶斯先验(MAP),从高斯与拉普拉斯分布推导出 正则化的等价性,用对偶几何与谱分解拆解“稀疏性”的本质,并连接到大模型后训练(RLHF)的 KL 先验锚定。
1. 历史的溯源:从“散招百出”到费雪的 MLE 大一统
在统计推断与机器学习的演进史上,方法应用与基础理论之间存在着一个鲜明的先后次序:
先在具体现实问题中诞生各种启发式算法与局部解法 历经数十年乃至上百年后,才由理论数学家提出统一的推断范式,将分散的“散招”收归同一理论体系之下。 极大似然估计(MLE)正是这样一个在经典算法应用近百年后才诞生的统一框架。
1.1 散招时代(1760s - 1800s):拉普拉斯的“逆概率”与高斯的最小二乘
在 19 世纪初,统计推断处于群雄割据的阶段:
- 贝叶斯与拉普拉斯(1763 / 1774):他们试图做逆向推导(由观测数据推测未知参数),当时称为“逆概率(Inverse Probability)”。这一路径必须先指定参数的先验分布 。当对未知参数缺乏先验信息时,拉普拉斯常采用“无充分理由原则”(假定参数在取值范围内等可能,即均匀先验)。如何合理指定先验、均匀先验在参数做非线性变换后不再均匀等问题,在 19 世纪至 20 世纪初引发了持续的方法论争议(其数学机理与反例详见 附录 C)。
- 勒让德与高斯(1805 / 1809):勒让德从几何残差平方和最小化出发发表了“最小二乘法”;高斯随后将其与正态误差分布及最大后验/极大似然式的论证联系起来,但当时尚未抽离出跨分布族的通用参数估计框架。
1.2 费雪的系统化(1912 - 1922):MLE 的诞生与“似然 vs 概率”的区分
到了 20 世纪初,现代统计学奠基人之一罗纳德·费雪(Ronald A. Fisher)批评了随意假定均匀先验的做法,主张建立一套直接基于观测数据与概率模型、无需预设参数先验的点估计与推断体系。
在 1912 至 1922 年间,费雪系统提出了 似然(Likelihood) 与 极大似然估计(MLE),并厘清了一个关键的概念区分:
- 概率 / 概率密度(Probability / Density)—— 固定参数看数据:
- 设定:已知模型参数 (固定常数),描述观测数据 (随机变量)取各值的可能性。
- 数学性质:对数据变量 在整个样本空间上求和(离散情形)或积分(连续情形)必须严格等于 1。
- 似然函数(Likelihood Function)—— 固定数据看参数:
- 设定:实验已完成,观测数据 已经固定,把同一个联合概率(或联合密度)表达式改看作待估参数 的函数 。
- 核心洞察: 似然函数不是关于参数 的概率分布! 虽然在给定 时它的数值等于数据发生的概率(离散情形)或概率密度(连续情形),但把 当作变量在整个参数空间上积分, 完全不需要等于 1。 它衡量的是不同参数假说对当前观测数据的相对支持度(Relative Plausibility):在不含参数先验时,MLE 选择使当前观测数据出现可能性(或密度)最大的那个 。
费雪不仅用 MLE 统一了最小二乘、伯努利参数估计等经典方法,还证明了:在模型正确指定、参数可识别、真参数位于参数空间内部且 Fisher 信息非退化等适当正则条件的固定维模型中,MLE 在大样本下具备一致性与渐近有效性(渐近方差达到克拉美-罗下界 CRLB 的理论极限,完整推导见 附录 A)。需要注意,这是渐近性质,不等于在任意有限样本下 MLE 都无偏或方差最小。
2. 纯粹的代价:小样本边界估计与过拟合风险
当样本量充足且模型复杂度适中时,MLE 表现优良;但在样本稀少或模型相对数据过于灵活时,完全只看当前样本的 MLE 可能给出极端或不稳定的估计。
抛硬币的思想实验:
假设有一枚硬币,随手抛了 3 次,恰好 3 次全都是正面朝上(记为数据 )。 按照伯努利模型的 MLE 去估计正面朝上的概率 : 在参数域 上, 严格单调递增(导数 在 处为 $3 \ne 0$,并非导数为零的内部驻点),因此在右边界处取得最大值: (若把参数域限定为开区间 ,则似然只有上确界 ,不存在能达到该上确界的有限 MLE。)
这意味着什么? 仅凭 3 次正面, 这个点估计把反面出现的概率估成了 。(当然,在频率派推断中,点估计不等于断言“统计上已确证绝无反面”,配合置信区间仍可看出不确定性极大;但若直接把点估计拿来做下游预测,就会给出 100% 正面的极端结论。)
过拟合(Overfitting)的直观缩影: 当样本量很小或参数维度很高时,纯粹的 MLE 完全贴合眼前的有限样本,容易把偶然的抽样波动当成普适规律,导致预测泛化能力下降。
3. 贝叶斯的视角:最大后验估计 (MAP) —— 引入先验约束
为了缓解小样本或高维情形下 MLE 的不稳定,我们可以把先验分布(Prior)引入参数估计。
回忆贝叶斯定理:
- 似然 :给定参数 时观测数据 的概率(或条件概率密度)。
- 先验 :在看到数据之前,对参数 合理取值范围的分布假设。
- 后验 :结合观测数据与先验分布后,参数 的条件分布(或后验密度)。
由于分母 与待优化的参数 无关,在后验密度良定义且最大值存在时,寻找使后验密度最大的参数即最大后验估计(Maximum A Posteriori, MAP):
直观注记:为什么后验正比于“先验 × 似然”?(两轮漏斗筛选直觉:林中听鸟思想实验)
对公式中 的物理直觉,可通过一个离散假设下的“两轮漏斗筛选”思想实验来理解: 假设树林中有 1000 只鸟,其中麻雀有 990 只、金丝雀仅 10 只(这对应未见具体数据前的先验基数 )。 此时林中传来一声特定清脆的鸟鸣(观测数据 )。在生理特征上,每只麻雀发出该鸣叫的概率仅为 ,而每只金丝雀发出该鸣叫的概率高达 (这对应不同假设生成该数据的似然命中率 / 转化率 )。 那么听到这声叫声后,发声者更有可能是麻雀还是金丝雀?
- 实际发出该叫声的麻雀期望数量:$990 \times 1% \approx 10$ 只;
- 实际发出该叫声的金丝雀期望数量:$10 \times 90% = 9$ 只。
“先验基数 × 似然命中率 = 最终幸存的候选数”。后验概率(两者的相对优势之比约为 $10 : 9$)正比于二者的乘积,正是这种双重筛选机制的数学表达。若仅凭极大似然(MLE,只看各物种发声的似然命中率 ),就会直接判定为金丝雀——这正是认知心理学与统计推断中典型的基础比率谬误(Base Rate Fallacy)。先验在此处起到了锚定总体背景基数的关键约束作用。
两边取自然对数,乘法化为加法:
转换为机器学习习惯的“最小化目标函数”形式(取负对数):
核心认知与边界:
- 当经验损失恰好是负对数似然、且惩罚项能解释为某个先验分布的负对数密度时,“损失函数 + 正则化惩罚项”在数学上等价于 MAP 点估计——即数据拟合(MLE)与先验约束之间的加权折中。
- 三大理论边界与认识澄清: ① MAP 仍然是点估计:它只取后验密度的峰值(Mode),并非完整的贝叶斯推断(完整贝叶斯会对整个后验分布积分来求期望预测分布)。 ② 引入先验不自动消除边界估计:效果取决于选什么先验。例如前面 3 次正面的硬币,若选平坦先验 ,MAP 依然是 ;若选偏好对称的先验 ,后验为 ,MAP 才被拉回 (完整贝叶斯后验预测均值则为 )。 ③ MAP 与 MLE 的双重桥梁(何时等价与何时分野):
- 固定参数化下的平坦先验退化:在给定参数坐标系下,若取常数均匀先验 (或零均值高斯先验方差 ,即正则化强度 ),则负对数先验 退化为与 无关的常数,MAP 目标在数值上直接退化为 MLE。
- 大样本极限下的殊途同归:当独立同分布样本量 时,平均对数后验可表示为 。其中经验似然均值项保持 阶,而先验项 以 的速度快速衰减至 (在先验对真实参数邻域赋予正测度等正则条件下,即 Bernstein–von Mises 定理所刻画的渐近性质)。海量数据终将“淹没”先验,不同合理先验下的 MAP 与 MLE 渐近一致收敛至同一个真值。
- 为什么费雪强调 MLE 绝非“均匀先验的贝叶斯”?(重参数化不变性 vs 雅可比畸变):尽管在固定坐标系下平坦先验的 MAP 与 MLE 数值一致,但二者在变换性质上存在深刻分野。MLE 具备重参数化不变性(对任意单射或可逆变换均有 );而连续概率密度在坐标非线性变换 下必须乘以雅可比行列式 (例如边长 上的均匀先验变换到面积 后,先验密度变为 ,不再均匀,导致 MAP 众数随参数化形式发生物理偏移)。详细数学论证与反例见 附录 C:重参数化不变性 vs 雅可比畸变。
4. 概率与代数的桥接:不同先验如何导出 L2 与 L1 正则化?
这是统计学习中极具洞察力的统一视角之一:当损失是负对数似然时,在目标函数里加上不同的范数惩罚,对应于在 MAP 框架下为参数选择了不同的先验分布。
前置约定(特征尺度与截距):
- 尺度敏感性:“权重大小”的含义依赖于特征的量纲与尺度(若把某个特征的单位缩小 100 倍、对应权重放大 100 倍,预测完全不变,但 的惩罚值会剧变)。因此,对各维度权重施加同强度的独立同分布先验前,通常需先对特征做标准化。
- 截距(偏置 ):常规的 Ridge / Lasso 通常不惩罚截距 (或先对数据做中心化以分离截距);若把常数列直接并入 ,下述公式就会连截距一起向 0 收缩。下文为简洁,记 为不含截距(或已分离截距后)的特征权重向量。
4.1 信仰一:各维权重偏好较小取值,服从零均值高斯先验 L2 正则化(Ridge)
在固定特征尺度后,若我们不希望某些权重 过度膨胀,可以假设参数各分量独立同分布地服从零均值高斯先验 :
在 固定时,将它取负对数代入 MAP 目标中(丢弃与 无关的常数项):
以总负对数似然 作为 ,优化目标就写成:
这就是广泛使用的 L2 正则化(在线性回归中对应 Ridge 岭回归)!
- 的数值依赖 Loss 的归一化约定:本节以总负对数似然为 ,因此 ;而在附注 2.1 的高斯线性回归中,我们把目标同乘 改写为“未平均的残差平方和 ”,此时 (若以平均残差平方和 为 Loss,则 )。两处公式完全自洽,差别仅在于目标函数的整体缩放因子。
- L2 正则化 vs 权重衰减(Weight Decay):在标准 SGD 中,对 求梯度做一步更新为 ,经系数换算与每步直接按比例缩小权重的“权重衰减”等价;但在 Adam 等自适应学习率优化器中,L2 正则项的梯度会被历史梯度平方移动平均缩放,与直接对参数做衰减不再等价——这正是 AdamW(Loshchilov & Hutter, 2019)专门将权重衰减与梯度更新解耦(Decoupled Weight Decay)的原因。
4.2 信仰二:偏好稀疏参数,服从拉普拉斯先验 L1 正则化(Lasso)
如果我们认为许多候选特征是冗余的,希望优化得到的点估计是稀疏(Sparse)的(即不少权重分量为 0),该选什么先验?
高斯先验在 处光滑(导数为 0),对极小权重的惩罚随 迅速变弱;而拉普拉斯先验(Laplace Prior)在 处是不可导的尖峰,尾部比高斯更厚( 固定):
取负对数代入 MAP 目标(以总负对数似然为 ):
优化目标随之变为:
这就是著名的 L1 正则化(在线性回归中对应 Lasso)!
- 重要澄清:稀疏性是 MAP 点估计(优化解)由 在 处的尖角(次梯度区间 ,对应软阈值算子)带来的性质;并不是说“从连续的 Laplace 先验分布中随机抽样会有正概率抽到精确的 ”(连续分布单点概率恒为 0),而且若做完整贝叶斯推断,后验均值 一般也不是精确稀疏的。
5. 几何直觉:为什么 L1 更容易产生稀疏解,而 L2 通常不会?
在凸优化中,惩罚形式 在一定条件下可与约束形式 相互对应。从二维参数平面 上“损失等高线与范数约束区的相切位置”来看:
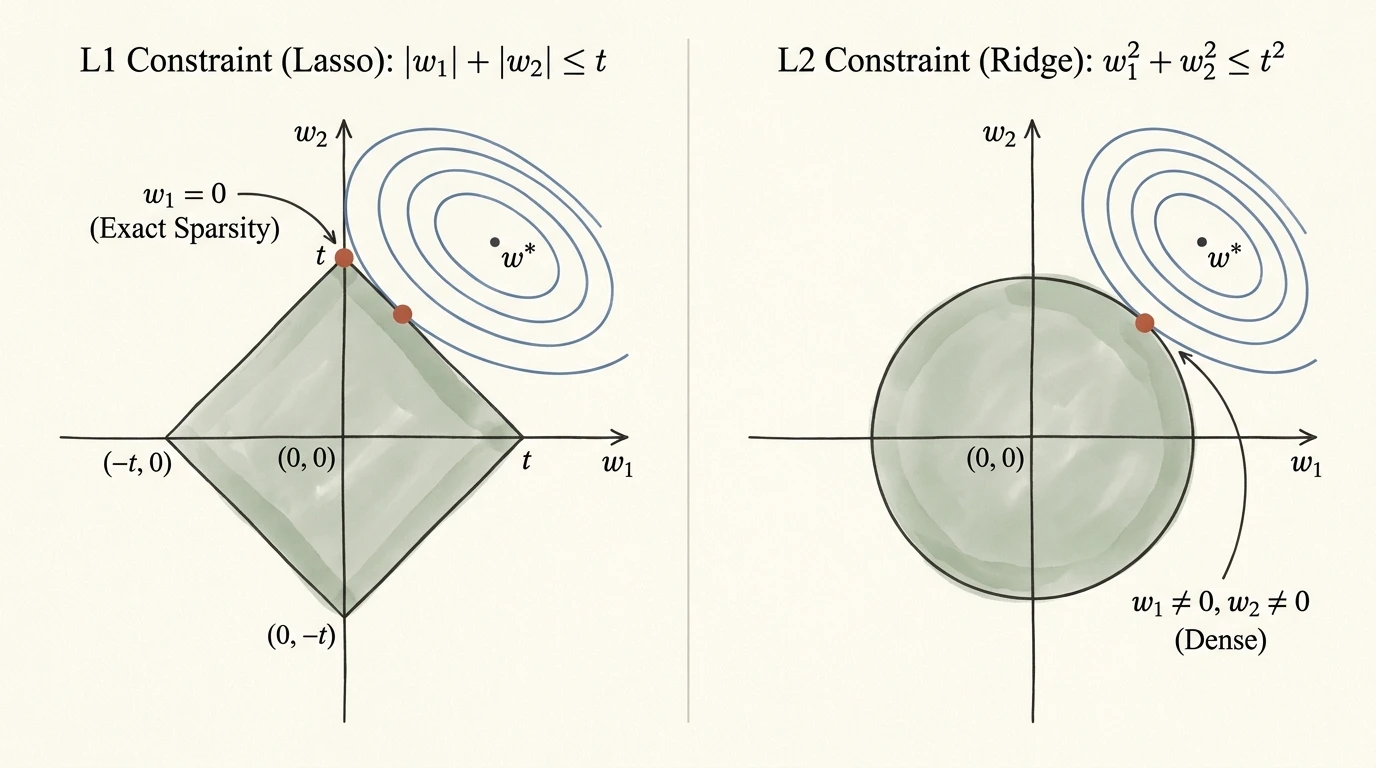 图:二维参数空间中经验损失等高线与范数约束球的相切几何对比——左图 L1 菱形约束区的四个尖角严格落在坐标轴上,等高线极易先撞击轴上顶点(如 )从而使对应权重精确归零();右图 L2 圆形约束区处处光滑,切点通常落在象限内部()
- L1 范数球():在二维平面是以 、 为顶点的斜置菱形(注意不是边与坐标轴平行的正方形,后者是 球 ),在更高维则是正轴体(多面体)。它的顶点和低维棱面恰好位于坐标轴或坐标子空间上。当损失函数的等高线从无约束最优点向外扩展并与菱形首次接触时,几何上有很大一簇梯度方向都会直接顶在坐标轴的尖角上,使对应维度的权重取到精确的 。(注:L1 并不“数学保证”相切点必落在顶点上,若等高线恰与斜边平行,最优点也可能落在斜边内部而不产生稀疏解,具体几何反例见 附录 B)。
- L2 范数球():是处处光滑的圆(超球体),在坐标轴上没有任何尖角。给定数据与损失函数后,相切点由几何关系唯一确定(并非在球面上随机均匀投点),除极特殊对齐情况外不会恰好落在坐标轴上,因此通常不会主动产生精确为零的系数。需要注意,L2 并非简单将每个坐标按同一比例均匀缩小,而是在设计矩阵 的特征主轴方向按 进行定向收缩,在强共线性下甚至可能使个别坐标绝对值反向增大(具体谱分解推导与数值反例见 附录 B)。
6. 统计学的核心权衡:偏差—方差权衡(Bias-Variance Tradeoff)
当我们通过引入先验(正则化)约束参数时,背后对应的统计学习核心概念是偏差与方差的权衡。
在平方损失回归(MSE)中,设真实条件期望为 ,观测满足 ,其中噪声满足 、同方差 ,训练集 与测试样本独立且相关二阶矩存在。则对固定测试点 (或对测试分布求期望后),模型 的期望测试均方误差可以严格分解为三项: (若噪声异方差,第三项应写为 或其关于 的期望;注意 0-1 分类错误率或交叉熵损失并不满足这一简单的三项加法分解。)
- 偏差(Bias):跨不同训练集 学出的平均预测 与真实回归函数 之间的系统性偏离。它受模型函数类、估计算法与正则化强度的共同影响。
- 偏差过大常表现为欠拟合(Underfitting),例如用线性模型去拟合强非线性规律,或正则化惩罚过重把系数压得接近 0。
- 方差(Variance):模型预测对具体训练集 抽样波动的敏感程度 。
- 方差过大常表现为过拟合(Overfitting):当样本量小、特征维度高或存在严重多重共线性时,无正则的 MLE 往往方差很大,训练集稍有变动,估计出的参数就剧烈摇摆。
- 不可约噪声(Irreducible Error):数据生成过程固有的条件方差 ,任何仅依赖 的预测器都无法消除。
正则化(先验)在偏差—方差权衡中的角色:
- 引入 的惩罚通常会引入或增大偏差,同时降低估计量的方差。当无正则模型的方差占主导时,适度的正则化可以用较小的偏差代价换取较大的方差下降,从而降低总体测试 MSE。
- 但这不是无条件保证:正则化不会“自动”把 降到最低。① 若 过大,偏差暴增会导致严重欠拟合;② 在某些情形下,任何 反而都会劣化测试风险(反例:单样本 的无噪声线性回归 ,真参数 ;OLS 解 方差为 、测试误差为 ,而加入 后岭解为 ,方差仍为 却凭空引入偏差,测试误差变为 )。因此在实践中,正则化强度 必须通过验证集或交叉验证来选择。
7. 从经典统计到现代深度学习 —— 先验演进与正则化实战抉择
在前述章节中,我们确立了从极大似然(MLE)到最大后验(MAP)的理论桥梁,并从对数先验与对偶切触几何视角剖析了 L2(高斯先验)与 L1(拉普拉斯先验)的本质差异。然而,当我们将经典统计推断理论推演至现代高维复杂特征工程以及动辄百亿、千亿参数的深度神经网络时,有两个核心问题构成了理论认知与工程落地的关键分水岭:
- 概念辨析:贝叶斯框架中的“先验(Prior)”,在算法执行中究竟等价于“初始化的起跑位置”,还是优化过程中贯穿始终的“势能橡皮筋拉力”?在无法人工指定先验分布的现代深度学习中,先验以何种形态隐式生效?
- 实战权衡:面对工业界真实高维特征体系中同时交织的“海量纯噪声指标”与“强多重共线性特征群”,应当如何严谨抉择 L1(Lasso)、L2(Ridge)与弹性网(Elastic Net)?
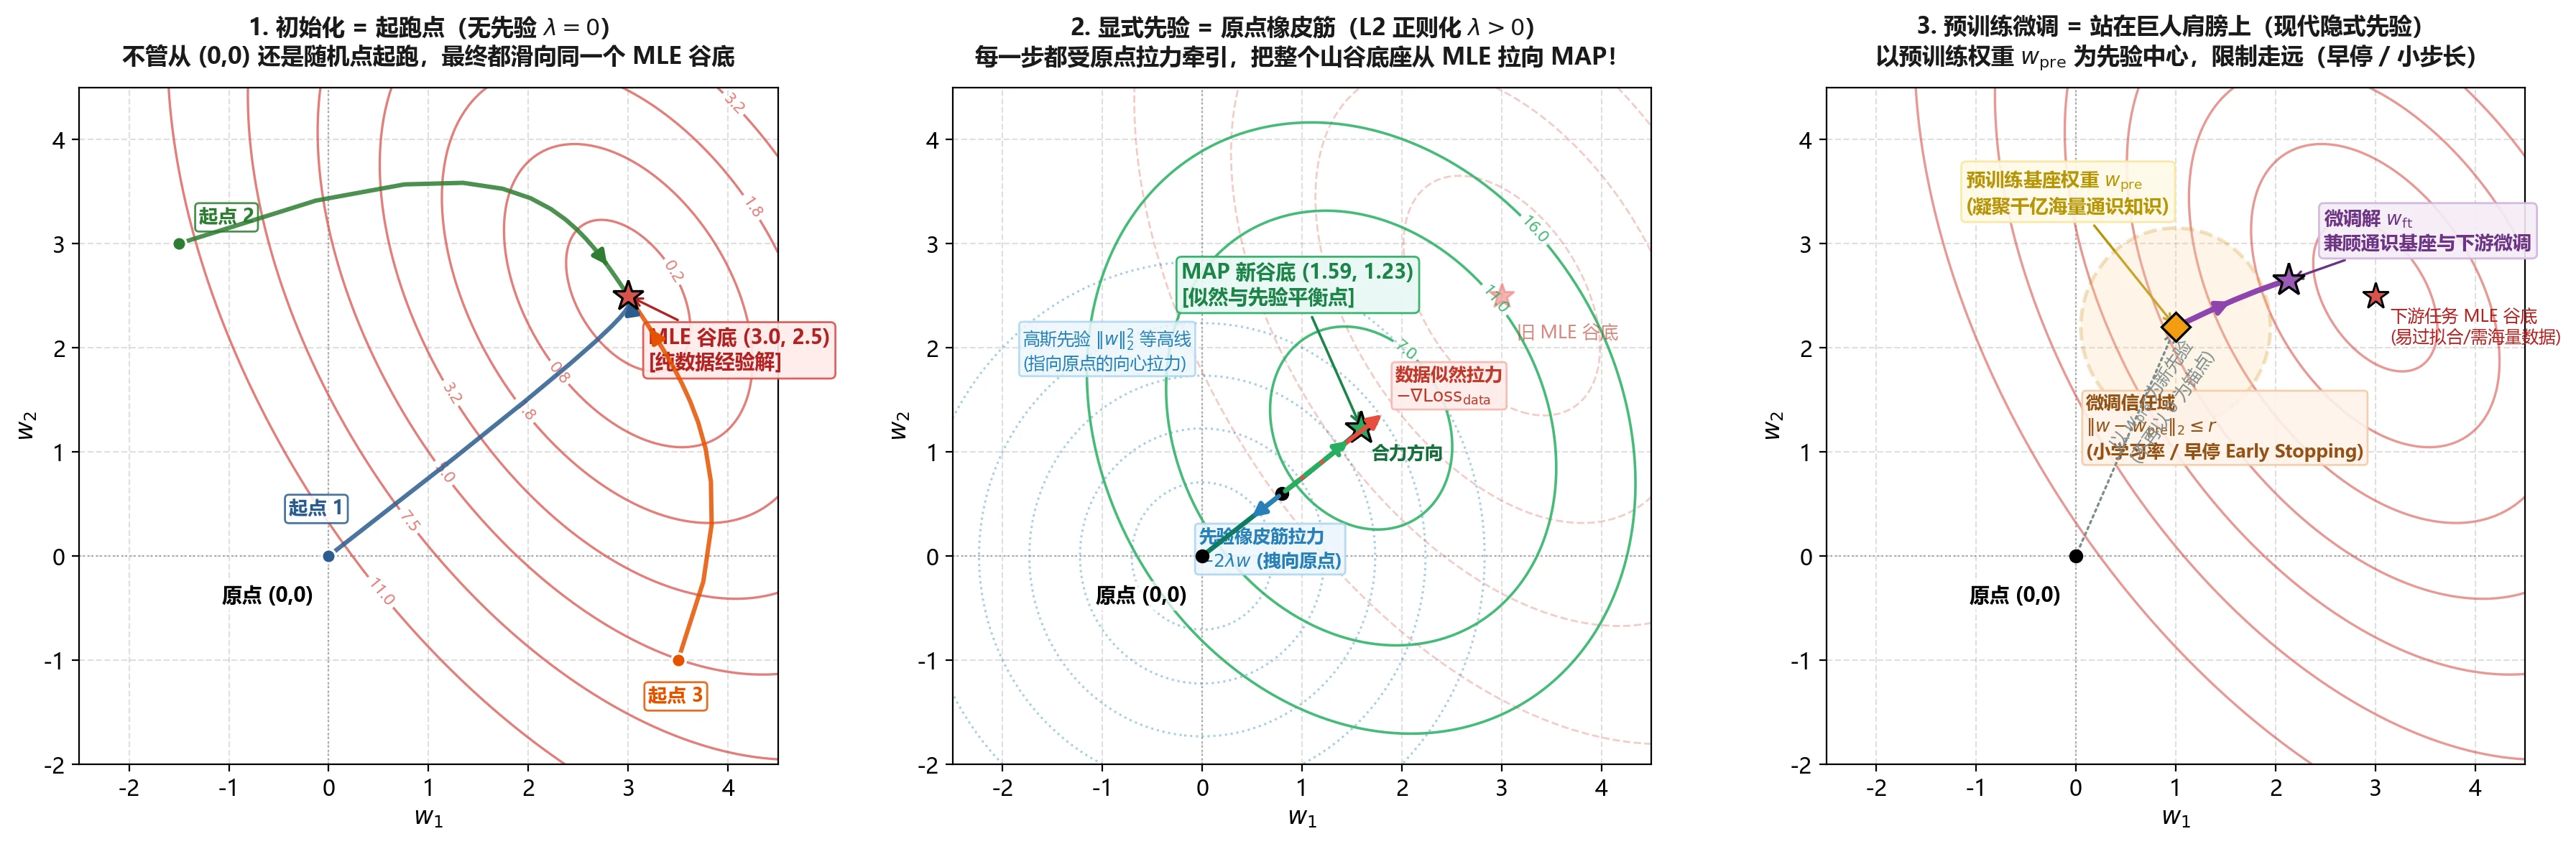 图:先验 vs 初始化的几何演化对比。从凸优化动力学(无先验全域收敛至 MLE vs 显式先验谷底整体平移)、多层非凸网络(全零对称锁死 vs 打破对称性初始化),到大模型后训练(预训练基座上锚定先验弹性缆绳)的三维演化图景。
7.1 概念辨析:先验(Prior)是“初始化起点”还是“橡皮筋拉力”?
在机器学习的工程实现与直觉理解中,极易产生一个认知误区:既然先验表达的是“在观察到数据之前的初始偏好”,那么将模型权重的初始值设为特定数值(例如将所有权重初始化为全零 ),是否就等价于施加了“零均值先验”?
核心结论:初始化起跑点(Optimization Initialization)与贝叶斯先验(Bayesian Prior)在数学定义与动力学本质上分属两个完全不同的范畴。
- 初始化起点:仅是迭代优化算法在参数流形上的起跑坐标 。
- 显式贝叶斯先验:是在整个参数空间上定义的概率势能场。转化为负对数惩罚后,它是优化全生命周期中每一步都持续作用于参数更新的向心弹性拉力。
上图从参数空间 的动力学演化清晰揭示了两者的本质差异与现代演进:
1. 凸优化动力学:殊途同归 vs 谷底整体平移(子图 1 vs 子图 2)
- 无先验纯数据驱动(,子图 1 ——“殊途同归”): 在严格凸经验损失曲面下,梯度更新规则为 。 从图中可见,无论优化算法是从原点 、随机点 A 还是随机点 B 起跑,初始位置的信息在梯度流的驱动下被持续擦除,所有轨迹最终全部汇聚于唯一的全局极小点 。初始化起跑点仅影响收敛所需的迭代步数,绝不改变最终的收敛极值。
- 显式零均值先验(,子图 2 ——“原点拴上橡皮筋,谷底搬家”): 当引入高斯先验(L2 正则化)后,MAP 的综合优化目标重塑为 。在优化的每一个瞬时状态点,参数更新受两个正交分力的合力矢量驱动: 显式先验并没有将参数“锁在原点”,而是像在坐标原点拴紧了一根弹性系数为 的高强橡皮筋。优化轨迹不再奔向 ,而是沿着合力梯度滑向似然拉力与先验拉力达成精确物理平衡的平衡点 。显式先验从根本上改写了损失地形,将整座山谷的稳态谷底向原点发生了物理平移。
2. 非凸神经网络的致命反例:“全零初始化”导致的对称性锁死
若误将“零均值先验”等同于“初始化为零”,在多层神经网络中将引发灾难性的对称性破缺失效(Symmetry Breaking Failure):
- 设全连接隐层的权重矩阵被初始化为全零 。在前向传播中,同层内每一个隐层神经元的线性加权输入均为 ,其非线性激活值完全同质:。
- 在反向传播计算梯度时,误差项对同层所有神经元输入权重的偏导数亦完全相同:。
- 其直接后果是:在任意优化步数下,同层的所有神经元以完全相同的梯度步长同步更新,网络陷入数学上的完全对称锁死,即便拥有上百个神经元,其实际表达能力仅退化为单一神经元。
- 正确实践范式:在现代深度学习中,必须在初始化起跑点采用打破对称性的随机分布(如 Xavier/Glorot 或 Kaiming/He 正态/均匀初始化),以确保神经元提取特征的多样性;而在损失函数中通过解耦权重衰减(Weight Decay / AdamW)持续施加 L2 显式先验,维持模型参数的向心正则化。
3. 现代深度学习的演化:站在巨人肩膀上的隐式先验与后训练对齐(子图 3)
在参数规模突破数百亿乃至数千亿的现代大语言模型(LLM)或跨模态基础模型时代,针对每个参数显式指定高斯先验分布 不仅极为粗糙,也无法承载任务语义。现代深度学习实现了先验形态的深层跃迁:
- 预训练与后训练(Post-training):从“起点与锚点分离”到“起点与先验合二为一”:
- 从头训练(From Scratch)的二元分离:在传统模型训练中,“随机初始化起跑点 ”与“原点先验锚点 ”是截然分离的——模型从某个打破对称性的随机分布出发,而范数惩罚项 始终像一根拴在原点 的橡皮筋向后拉拽。
- 大模型后训练的合二为一:在大语言模型后训练体系(Post-training,包括指令微调 SFT 与人类反馈强化学习 RLHF / PPO / DPO)中,“起始点”与“先验锚点”完成了深刻的合二为一。模型直接从凝聚了人类海量通用知识的预训练基座 出发,优化目标不再以原点为拉拽中心,而是将先验橡皮筋直接钉在起始点 上:
- 参数空间惩罚(SFT 阶段):通过权重偏离惩罚 或配合极小学习率与早停机制(隐式圈定局部信任域 ),防止微调过程剧烈破坏底座参数,从根本上遏制了灾难性遗忘(Catastrophic Forgetting);
- 策略分布空间惩罚(RLHF / 对齐阶段):优化目标直接以预训练参考策略 (即 )为先验基座,显式引入策略 KL 散度惩罚: 这里的 KL 散度惩罚在函数空间中扮演了最严厉的贝叶斯先验:它像一根无形的弹性缆绳将当前策略 紧紧拴在人类语言常识基准 处,确保模型在最大化奖励信号 时不至于走火入魔、胡言乱语,有效杜绝了奖励黑客(Reward Hacking)与策略坍塌(Policy Collapse)。预训练微调不再以冷冰冰的原点为中心,而是将先验的基准锚定在千亿参数所凝聚的“巨人肩膀”上。
- 架构层面的归纳偏置(Architectural Inductive Bias): 先验不仅表现为数值损失惩罚,更深度熔铸在神经网络的计算拓扑中。例如卷积神经网络(CNN)通过局部连接(Local Connectivity)与权值共享(Weight Sharing),对高维假设空间强制施加了平移等变性(Translation Equivariance)与空间局部性的强归纳偏置;自回归 Transformer 通过因果注意力掩码(Causal Mask)强制施加了时间因果单向性先验;图神经网络(GNN)内化了置换不变性(Permutation Invariance)。这些结构层面的先验约束极大地缩减了参数流形的有效搜索容积,其泛化保护效力远超单纯的范数正则。
7.2 实战权衡:面对“纯噪音指标”与“共线性双胞胎指标”,如何抉择 L1、L2 与 Elastic Net?
在工业界高维特征工程实践中(如量化多因子风控、高通量基因组学生物计算、推荐广告检索排序),数据科学家经常面对如下典型场景:
特征空间拥有数千乃至上万维已标准化的特征,其中交织着两类极端病态结构:
- 海量纯噪声特征:绝大部分特征与目标变量无内在因果关联,仅由抽样随机波动产生弱伪相关;
- 多重共线性特征组(“多胞胎特征”):数个特征源于相似业务统计口径,两两之间皮尔逊相关系数高达 。
在这一实战背景下,孤立选用 L1 或 L2 会遭遇不同的理论困境,唯有深刻理解其代数与几何根源,方能做出严谨权衡。
1. 面对纯噪声特征:L1 的次梯度“尖角硬清零”
- 数学机理: L1 惩罚项 在原点 处不可微,其一阶驻点由次梯度(Subgradient)定义: 在一维正交或弱相关设计矩阵下,L1 的 MAP 解析解直接展现为软阈值算子(Soft-thresholding Operator):
- 实战优势: 当纯噪声特征与目标的经验伪相关性较弱时(即 ),软阈值算子将该维度的权重精确截断为绝对的 0。因此,L1(Lasso)天然扮演了内嵌式特征选择器(Embedded Feature Selector)的角色,将成百上千个纯噪声维度从模型中剔除,不仅大幅压低了估计方差,更产出了极具业务可解释性的紧凑模型。
- 面对共线性的病态表现(随机抽奖现象): 设特征集中存在一对高度共线的“双胞胎特征” (例如标准化后 ),且真实模型需要其联合贡献 。 在第一象限()内,L1 惩罚项恒为: 此时在整条线段 上,L1 惩罚值完全相同!这导致目标函数曲面在这一方向上发生退化(平坦谷底)。优化算法在数值浮点扰动或抽样微扰下,将极度随机且武断地把全部权重 2 分配给其中一个特征,而将另一个置为 0(例如解可能在 与 之间剧烈摆动)。在下一次交叉验证或训练集轻度微调时,选入的特征会发生完全不可预测的反转,严重破坏了特征归因的业务信赖度。
2. 面对共线性特征组:L2 的二次强凸“均摊效应”
- 严格不等式推导与数值直觉:
面对同样的双胞胎约束 ,L2 惩罚项考察的是 。由柯西-施瓦茨不等式(或均值不等式):
等号成立的充分必要条件为两分量完全相等:。
- 数值反差对比:
- 若极端独宠单变量(类似 Lasso 行为):;
- 若两变量均匀平摊:!
- 若存在三个完全共线的“三胞胎特征”,独宠惩罚为 ,而均摊惩罚仅为 ,L2 惩罚幅度整整节约了 !
- 数值反差对比:
- 理论机理(Grouping Effect): L2 范数的导数为 ,这意味着单项权重的边缘惩罚代价随着数值的增大呈线性递增。因此,优化算法总是以最大的动力将相互替代的共线性特征紧密绑定在一起,迫使它们同生同死、均摊系数。在代数层面,岭回归通过在设计矩阵协方差中注入对角增量 ,直接抹除了共线性引起的病态奇异性(分母近零),从而将估计量的方差牢牢锁死在安全范围之内。
- 面对纯噪声的局限: L2 范数在原点处是光滑可微的,缺乏将弱信号权重硬压缩至 0 的能力。在面对海量纯噪声指标时,L2 会给每个噪声分配极小的微弱非零权重,导致模型冗余不堪、计算开销大且容易在测试集上累积噪声方差。
3. 组合最优解:弹性网(Elastic Net)的折中智慧
为了兼取 L1 的特征硬清零能力与 L2 的共线性组均摊稳定性,Zou & Hastie (2005) 提出了弹性网(Elastic Net),将两种惩罚项构筑为凸组合: 或常用标准参数化形式 。
- 协同效应(Synergy)机制:
- L1 项()充当“手术刀”:在坐标平面的多维尖角处,以硬软阈值机制将成百上千个弱信号纯噪声特征批量归零,实现高维参数稀疏化;
- L2 项()充当“稳定安全带”:凭借强凸二次曲率,使得具有高度相关性的特征组展现出严格的成组效应(Grouping Property)——相关特征被成批选入模型并自动平分权重,彻底根除了 Lasso 的随机跳跃病态;
- 突破维数瓶颈():对于样本量 但特征量 的典型微阵列基因或小样本金融场景,纯 Lasso 在理论上最多只能选入 个非零特征;而 Elastic Net 借助 L2 项引入的强凸正则性,能够突破这一上限,完整选入包含成组效应的高维特征群。
4. 工业界正则化选型决策矩阵(Decision Matrix)
| 业务场景特征 | 推荐首选方案 | 统计学机理与核心决策理由 |
|---|---|---|
| 特征维度适中,存在高度多重共线性,优先追求预测稳定性与方差控制 | L2 (Ridge / 岭回归) | 修正协方差矩阵条件数 ,二次强凸性使多胞胎特征权重均匀平摊,极大压缩参数方差。 |
| 高维海量特征,强可解释性诉求,明确需进行变量初筛与模型轻量化 | L1 (Lasso) | 菱形范数球尖角与软阈值算子天然将弱相关特征硬置为 0,提供内嵌式特征选择,产出高稀疏性解析模型。 |
| 超高维复杂数据,同时交织大量无用纯噪声与强共线性特征组(如量化多因子、基因表达谱) | Elastic Net (弹性网) | 兼备 L1 尖角的噪声剔除能力与 L2 的共线性成组均摊稳定性,并在 极端小样本下突破非零特征数量瓶颈。 |
| 超大规模深度神经网络(超参数化模型) | Weight Decay (解耦 L2) + 预训练权重 + 早停 | 采用打破对称性的随机初始化起步,以预训练通用知识 为信任域先验锚点,利用 AdamW 权重衰减与早停实现稳定向心收缩。 |
8. 本章核心总结与认知闭环
回顾本章的推导演进,我们完成了一次从费雪经典极大似然到贝叶斯最大后验、再到现代深度学习先验演进的认知升维。整个知识架构由五大核心支柱严密咬合:
| 演进环节 | 核心数学/统计工具 | 解决的关键问题与认知飞跃 |
|---|---|---|
| 1. 费雪 MLE 大一统 | 似然函数 + 得分函数与 Fisher 信息 + CRLB 渐近有效界 | 确立了参数估计的客观推断基石。厘清“固定参数看数据”的概率(必须积分为 1)与“固定数据看参数”的似然(衡量假说相对支持度)之本质分野;在充足样本与正规条件下,证明了 MLE 具备一致性与达到克拉美-罗下界的渐近有效性。 |
| 2. 小样本过拟合危机 | 边界驻点导数非零 + 抽样随机波动放大 | 揭示了纯粹 MLE 仅凭眼前有限样本极易陷入“抽样噪声绑架”:在 3 次正面抛硬币实验中导出正面率 100% 的极端点估计,暴露了无正则模型在样本匮乏或高维灵活参数空间中的泛化原罪。 |
| 3. 贝叶斯 MAP 救赎 | 后验 + 两轮漏斗筛选 + 负对数等价转换 | 建立了“经验损失 + 正则化惩罚”与 MAP 点估计的严格代数等价性;以林中听鸟直觉打破基础比率谬误;厘清了平坦先验数值退化与大样本 似然淹没先验的双重桥梁,同时揭示连续密度雅可比畸变导致 MAP 缺乏重参数化不变性。 |
| 4. 代数与几何双重视角 | 高斯先验 L2 光滑球(二次强凸) vs 拉普拉斯先验 L1 菱形球(次梯度硬清零) Elastic Net | 统一概率假设与优化几何:高斯光滑圆以连续递增的边际代价逼迫共线性特征均摊权重,拉普拉斯轴上尖角与软阈值算子砍除纯噪声实现内嵌特征选择;弹性网则兼取两者,在 极端小样本下突破非零特征瓶颈。 |
| 5. 统计权衡与现代先验演进 | 偏差-方差分解 + 优化起跑点 vs 势能橡皮筋 + Post-training 锚点与起点合一 | 明确了正则化用可控偏差换取大幅方差压制的统计本质;在深度学习中厘清非凸对称性随机初始化起跑点与向心正则拉力的本质差异;揭示现代大模型后训练(Post-training / SFT / RLHF)直接将先验橡皮筋( 与 )锚定在基座起点的全新范式。 |
从本章迈向下一站:本章看到 正则化通过约束权重范数 ,不仅在贝叶斯视角下对应高斯先验,更在统计上起到了平滑损失曲面、压制方差的作用。如果我们进一步切换视角,不再追求全样本的概率折中,而是希望在样本空间中撑开一条对未知微扰最稳健、分类几何间隔最大(Maximum Margin)的安全走廊,又该如何构建优化目标并借助核技巧突破线性不可分?这正是第三站“支持向量机与核技巧”的核心命题。
📖 深度附录(数学与理论底座)
本附录提供正文主干所依赖的严密数学证明、历史溯源与理论边界推导,供需要严格求证的读者查阅。
附录 A:MLE 的一致性、渐近正态性与渐近有效性(CRLB)推导
设观测样本 , 为真实参数。记单样本对数似然为 ,其一阶导数 称为得分函数(Score Function)。
在适当正则条件(模型正确指定、参数可识别、 位于参数空间内部、对数似然三阶可微且微分与积分可交换、Fisher 信息非退化)下,MLE 的核心渐近性质可由以下四步导出:
-
得分函数的零均值性质与 Fisher 信息恒等式: 因为概率密度积分恒为 ,即 ,两边对 求导并交换微分与积分顺序: 在真参数 处,真值是让期望对数似然梯度为零的驻点。再对恒等式求一次导,可得 Fisher 信息量 的等价形式(标量情形):
- 几何直觉: 衡量对数似然曲线在真值附近的期望曲率(陡峭程度)。曲率越大,真值附近的峰越尖锐,数据锁死真值的能力就越强。
-
一致性(Consistency:): 由大数定律(LLN),样本平均对数似然在每个 上依概率收敛到总体期望: 而期望差满足吉布斯不等式(KL 散度非负性): 当模型可识别时,唯有 时 ,即真参数 是极限目标函数的唯一全局最大值点。配合一致收敛条件(如紧集或局部凹性),经验最大值点必然依概率收敛到真值:。
-
渐近正态性与渐近有效性(Asymptotic Normality & Efficiency): 当 位于内部时,它满足一阶驻点方程 。在真值 处做一阶泰勒展开: 移项并乘以 ,将参数误差表示为分子与分母之比:
- 分子(由中心极限定理 CLT):由于 、方差为 ,故 ;
- 分母(由大数定律 LLN):经验负二阶导依概率收敛到 Fisher 信息量:。 由 Slutsky 定理,分子除以分母的极限分布为 ,即: 在大样本下, 的渐近方差为 ,恰好达到克拉美-罗下界(Cramér–Rao Lower Bound, CRLB)——即任何无偏(或正规渐近无偏)估计量的方差理论极限。
-
边界与反例提醒:
- 有限样本下不必无偏:例如正态方差 的 MLE 为 ,其期望为 ,在有限样本下存在向下偏差,仅当 时渐近无偏。
- 正则条件失效时的反例:均匀分布 的支撑集边界依赖参数 (不满足微分与积分可交换条件),其 的收敛速度是 而非 ,极限分布是 Weibull/指数型分布而非正态分布。
附录 B:从概率到代数与谱分析 —— 高斯 MAP 到岭回归的对数推导、主轴收缩机理与典型反例
本附录为正文第 4 节与第 5 节提供严密的代数推导、特征谱收缩分析以及关于 L1 与 L2 几何收缩特性的严格数值反例。
1. 高斯先验到岭回归(Ridge)目标的严格对数推导
考虑无截距(或已中心化分离截距)的线性回归模型:给定特征矩阵 ,设各样本条件独立,;参数先验独立于 且服从各向同性高斯分布 ,其中 为固定常数。 条件后验密度满足: 对 取负对数(由于 对 固定,对数归一化项合并为与 无关的常数 ): 两边同乘正常数 ,最小化点不变: 令 ,正好对应以残差平方和(RSS)为损失的岭回归(Ridge Regression)目标函数!
- 物理含义:在这一归一化下,正则化系数 是观测噪声方差 与 参数先验方差 的比值。当观测噪声很大( 大,数据不太可信),或先验认为权重应当很小( 小)时, 增大,模型更倾向于向先验均值 收缩。
2. L2 岭回归的谱分解机理:主轴收缩而非坐标等比例缩小
岭回归解析解为 。设设计矩阵 的奇异值分解(SVD)为 ,其中 为特征协方差矩阵 的正交特征向量矩阵, 为奇异值(满足 )。 无正则化的普通最小二乘(OLS)解可展开为: 代入岭回归求解公式:
- 核心数学性质:岭回归是在 的正交主轴(特征向量 )方向上,将 OLS 坐标投影严格按因子 进行定向收缩:
- 大奇异值方向(主信号分量,):收缩因子接近 ,原始参数信息几乎完整保留;
- 小奇异值方向(弱信号、高频噪声或多重共线性方向,):收缩因子接近 ,参数估计的剧烈波动被强力压制。
3. 常见几何与代数认知误区的严格反例
反例 1:L2 并非简单将每个原始特征坐标按同一比例缩小
唯有当特征矩阵满足严格正交且尺度相等()时,特征向量 才与标准坐标轴完全重合,此时各原始坐标才等比例缩放。只要特征间存在不同尺度或相关性,各坐标收缩比例截然不同。
- 数值验证:设 ,OLS 解为 。 在目标 中取 ,则 。 由于 ,求得岭解为: 第一维权重被压缩了 ,而第二维权重仅被压缩了 ,缩放幅度明显不同。
反例 2:高度共线性下,L2 正则化可能使个别坐标绝对值反而增大
在存在强多重共线性时,由于特征之间存在复杂的代数抵消与补偿,加入 L2 正则项后,某个分量的权重完全可能不仅不缩小,反而从 0 增大为显著非零值。
- 数值验证:设特征高度相关,协方差矩阵为 。 假设 OLS 解恰为 ,对应的数据投影为 。 取正则化强度 ,则: 其行列式为 。逆矩阵为: 代入求解岭回归解: 结论:在加入 L2 惩罚后,第一维分量从 OLS 的精确 反而增长到了 ! 这是因为原本 将拟合负担全压在第二维上,而在两特征高度共线()且 L2 强烈偏好“均摊二次项”(见正文第 7.2 节)的驱动下,优化器主动把部分权重匀给了第一维,从而以两维协同分担的方式换取更小的总 L2 范数()。
反例 3:L1 并不“数学保证”相切点必落在坐标轴顶点上(非稀疏解反例)
虽然几何上 L1 菱形的尖角极易捕获等高线,但若损失函数的等高线对称轴或长短轴恰好与菱形斜边完全平行,切点完全可能落在斜边内部,此时所有特征权重均非零。
- 数值验证:考虑目标函数 ,范数约束为 。 未加约束的无条件最优解为 ,损失等高线是以 为圆心的严格同心圆。 在第一象限,范数球边界为线段 (),法向量为 。 同心圆从 向外扩张时,圆心到边界的最短距离正投影点恰好落在斜边的中点: 此时切点严格位于菱形斜边内部,两个分量均等于 $0.5 \ne 0$。这表明 L1 产生稀疏解是一种高概率的几何偏好,而非在任意病态或对称损失曲面下的绝对代数必然。
附录 C:重参数化不变性 vs 雅可比畸变 —— 为什么费雪强调 MLE 绝非“均匀先验的贝叶斯”?
在现代统计学史中,拉普拉斯等学者曾借助“无充分理由原则(Principle of Insufficient Reason)”,在缺乏先验信息时假定参数服从平坦的均匀先验。费雪(Ronald A. Fisher)对这一做法提出了极为尖锐的批评:对未知参数的“无知”,无法在所有非线性变换下同时保持“均匀”。理解这一批评的核心在于分清:似然函数的值域比较性质与连续概率密度的测度变换法则。
1. 极大似然估计的重参数化不变性(Functional Invariance)
设模型参数为 。若引入可逆单调变换(或任意可微单射),参数空间映射为 。 由于似然函数定义为在固定观测数据 下、关于待选参数假说的函数: 当 时,对于任意可逆单调变换 ,最大值点必然满足:
- 统计学意义:MLE 衡量的是不同假设对数据的相对支持度高低,求解过程只涉及数值排序,不涉及参数空间上的测度积分。无论研究者使用方差 、标准差 还是精度 作为模型参数进行估计,得到的 MLE 点估计在物理实际上完全等价,具备内在的坐标系客观性。
2. 连续先验密度在非线性换元下的雅可比畸变(Jacobian Distortion)
与似然函数不同,先验 是一个概率密度函数(PDF)。概率的本质是区间上的积分测度。为了保证在任意子集上的概率质量在变量替换下保持不变(即 ): 当参数经历非线性平滑单调变换 (反函数记为 )时,微分区间满足 ,因此先验密度的变换法则必须乘以导数绝对值(一维雅可比):
3. 经典几何反例:正方形边长与面积的“无知”悖论
假设我们面对一个正方形未知工件,先验仅知其边长 。
- 若在边长坐标系下选用均匀先验: 在边长坐标下, 为常数,MAP 目标完全退化为最大化似然:。
- 改用面积 建模: 反解得 ,其一阶导数绝对值为 。 由密度换元法则,面积 的诱导先验密度必须为: 注意: 绝不再是均匀分布! 它在 处达到最大值 ,在 处单调下降至约 。
- 导致的 MAP 众数漂移: 若另一位研究者在面积空间直接求解 MAP: 非线性惩罚项 会系统性地将面积的后验众数往较小数值方向拉扯,导致: MAP 点估计破坏了重参数化不变性——它依赖于研究者主观挑选的参数坐标系。
4. 总结与现代贝叶斯的解法
费雪借此深刻指明:拉普拉斯所谓的“均匀平坦先验”完全依赖于特定坐标系的人为选取,并不代表真正中立客观的“无知状态”。
拓展阅读:Jeffreys 先验 现代客观贝叶斯学派(Harold Jeffreys)为了克服这一缺陷,提出利用 Fisher 信息量构造在坐标变换下保持不变的非信息先验:。由 Fisher 信息的变换性质 ,开方后的 恰好吸纳了雅可比因子 ,从而保证了先验形式在重参数化下的几何一致性。但在高维多参数模型中,Jeffreys 先验常引发不正规性(Improper Prior)及反直觉的边缘化悖论,实践中常转向具有明确正则化语义的注入式先验。
附录 D:这与下一站的 SVM(支持向量机)有何关联?
理解了“通过控制 来约束模型容量”之后,可以自然衔接下一站的 SVM(支持向量机):
- 对标签取 且训练数据线性可分的二分类问题,硬间隔(Hard-margin)SVM 将函数间隔归一化为 ,并最大化几何间隔 ,从而导出原始凸二次规划问题: 注意这里必须配合约束 才有“最大间隔”的几何意义(若不固定函数间隔下界而单纯缩小 ,超平面本身并不会改变)。
- 当数据线性不可分(例如存在噪声或重叠样本)时,硬间隔约束无解,此时需引入松弛变量 得到软间隔(Soft-margin)SVM,其无约束等价形式正是 Hinge 损失 + L2 正则化: 这为我们提供了将几何间隔最大化与 L2 正则化联系起来的统一视角。
💡 深度延伸思考题:
在完成本站的学习与探讨(详见正文第 7 节对先验本质与高维正则化选型的深入解答)后,你可以继续沿着现代机器学习的前沿理论,思考以下进阶课题:
- 隐式正则化与双重下降(Double Descent): 在参数量远超样本量的现代过参数化(Over-parameterized)深度模型中,即便完全不添加显式的范数正则项,随机梯度下降(SGD)本身也会表现出对“最小范数插值解”的隐式偏好。这种由优化动力学带来的隐式正则化(Implicit Regularization),是如何在经典“偏差-方差权衡”失效的超插值区域(Over-parameterized regime)驱动测试风险实现二次下降的?
- 生成模型与潜空间的先验选择: 在变分自编码器(VAE)与生成扩散模型(Diffusion Models)中,模型通常默认假定潜在变量服从各向同性标准高斯先验 。结合 附录 C 中关于非线性换元与雅可比度量畸变的论证,这种在潜空间人为强加简单先验的做法,会对复杂流形的数据生成带来怎样的拓扑瓶颈(如后验坍塌或流形空洞)?现代几何深度学习是如何尝试化解这一冲突的?