本文写于 2026-09-21
memU的技术架构
先简单介绍一下memU是个什么项目,项目地址是https://github.com/NevaMind-AI/memU,这个项目是一个开源记忆层,主要是给 Agent 提供 memory 组件。
 图:memU 仓库首页,定位"Personal memory, stored as Wiki",曾登顶 GitHub 日榜第一
1. 定位轻巧,走 embedding-only 路线
相较于mem0这种偏向于云端的记忆方案,memU 定位是非常轻巧的,其服务端只做数学计算,不调用 LLM 做理解。
原话见 memU-repo/AGENTS.md :
memU is embedding-only. No LLM/chat call happens anywhere in the service; do not add one.
我们过一遍整体的项目架构:
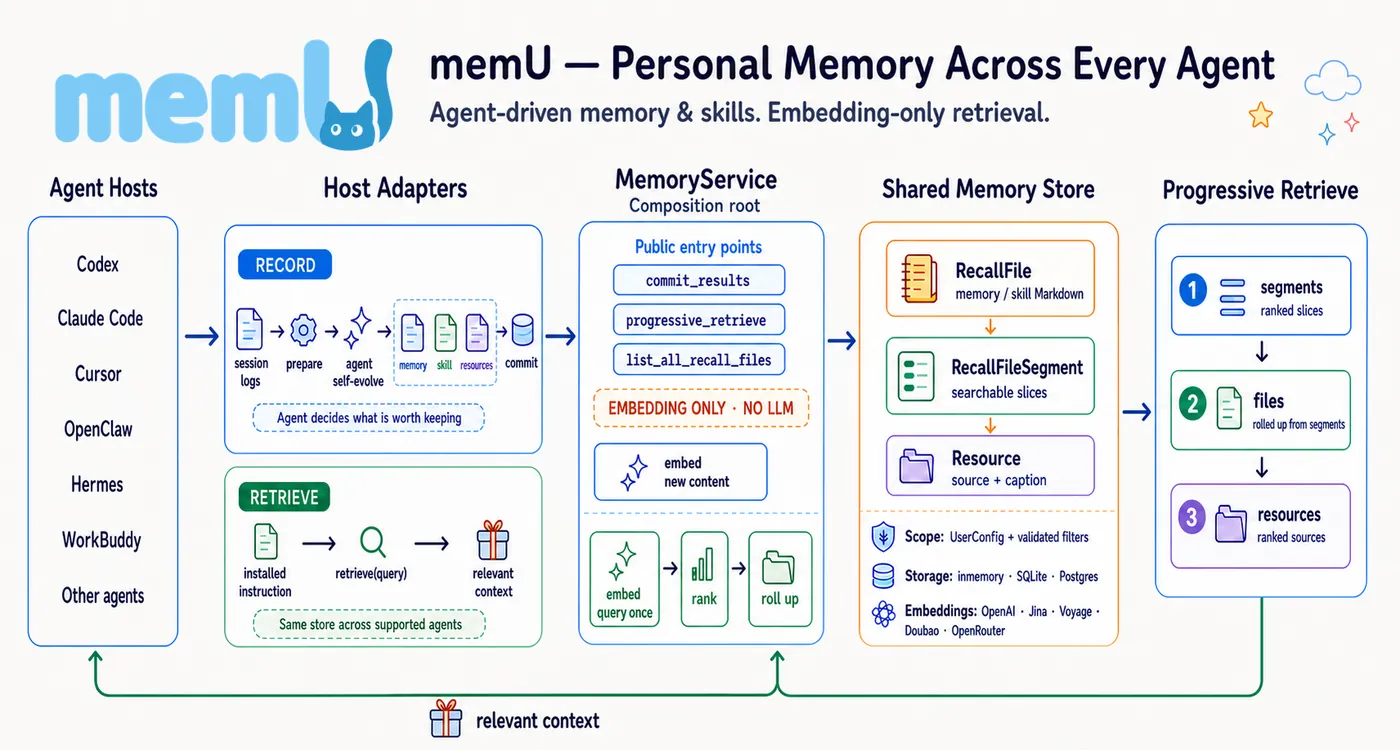 图:memU 整体架构,蓝色为写(RECORD)、绿色为读(检索)两条路线(来源:memU 官方仓库)
简单理解一下上面这张图:写和读在图上分别用蓝色和绿色表示。我们从“写”这条蓝色路线开始,左边各种 Agent 把会话交进来,走“RECORD”这个流程——Agent 自己决定留什么,写进记忆服务端,所有 Agent 共用同一份记忆。读是绿的那条:各家按装好的指令来查,查完拿相关上下文回去干活。
宿主机这边负责推理(Host Adapters),“写”拆成三步,前后是代码、中间是 Agent:
- 准备(prepare):只读
state.db(mode=ro,不动活库),按 per-host 游标(.session_manifest.*.pending)找出上次之后的新 turns,切出三类 jobs,全程不调模型。三类是:memory job(读N.jsonl对话)、skill job(读N_full.jsonl含 tool calls 的完整轨迹)、resource job(读 touched-file 记录)。 - 自进化(agent self-evolve):全流程唯一调模型的一步。读本段 transcript → 先读已有 mirror 文件名 → 三选一:nothing(啥也不干)、patch(修改旧文)、create(新建)。
- 提交(commit):纯代码,把 Agent 写好的 markdown 落盘 + 切片 embed + 更新 hash 快照和游标。本地 mirror 留着当下次对照的底;cloud 模式再多一步送云端。
服务端不调用LLM,只做数学计算(memory service & Retrieve):
- 嵌入(embed):把一段文本变成向量。接口是
EmbeddingClient.embed(inputs) -> vectors,实现在src/memu/embedding/,支持官方 SDK 和 raw HTTP 两套 transport,可换模型。注意,这里不调 chat / completion、不做摘要、不做抽取,只做嵌入。项目专门把 embedding 从 chat client 里剥离成独立能力包(memu.embedding),把“向量化”和“理解”在代码层面切开。 - 存储(store):把向量 + 原文指针按 L0 / L1 / L2 存进 sqlite / postgres / inmemory。sqlite 是 CLI / host 本地默认选项(单文件持久化,如
./data/memu.sqlite3,库级别默认是 inmemory);postgres 是量大 / 多用户 / 服务端形态(向量走 pgvector 索引);inmemory 一般跑测试使用。(注:就算选 cloud 模式,本地仍然保留 mirror 作为工作区——prepare 从云端拉取,本地 commit 送回云端。这和 mem0 的 platform 模式(本地无存档)区别很大。) - 排序(rank):检索(Retrieve)设计是 single-pass hybrid——embedding cosine + BM25 融合、单遍排序,命中后 roll-up 回文件。(注:现状是 ADR 0007(07-01,Proposed)写了 hybrid,但截止到 clone 的 08e1ed4(09-10),代码里只有 cosine(
cosine_topk),BM25 还未实现——文档跑在了代码前面,当前实现 = 纯 cosine + max roll-up。)
我们以记忆一个 skill 作为例子:
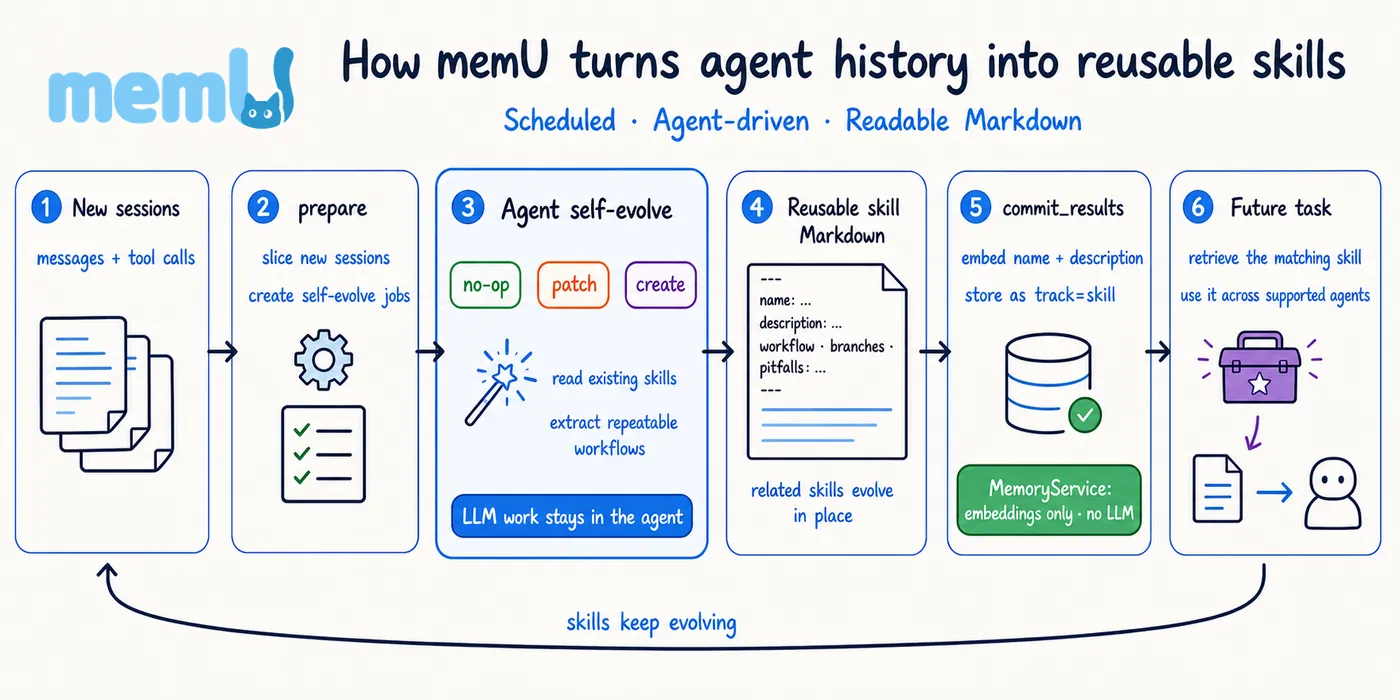 图:以 skill 自进化为例,新轨迹经切分、Agent 蒸馏后入库复用(来源:memU 官方仓库)
这张图拿 skill evolve 举例:新会话的轨迹进来被 “prepare” 切成 job,Agent 把有用的部分写成新文档或者优化旧文档,入库后下次接着用,越用越多,形成 skill 的自迭代。
花模型 token 的步骤主要是 Agent 看稿子做判断的这一步,所以 memU 服务端省掉的推理成本转嫁到了 host 侧,这一步 token 量是比较大的。反过来说,这也意味着 memU 的服务端本身是很便宜的——推理成本已经由用户自己承担了,云端做到低价甚至免费都不难。
总结起来:embedding-only 定位轻巧,memU 只提供了一个 memory 的处理框架,它把“reasoning”这个步骤外包给了 host Agent。服务端只做嵌入、存储和排序,文本质量依赖于 host 端的数据和推理质量。
2. 召回设计:单遍混合检索 + 层级聚合,不引入 graph
在召回算法设计上,memU 先是认真考虑过 wiki-graph(L1 互链、entity 互引、backlinks / traverse / multi-hop),但后续并未采用(注:相关细节见 ADR 0007(07-01,Proposed)),而是使用single pass + hybrid retrieval + roll up 的设计,具体来说:
- memory / skill / project 三条线共享一个 layered kernel,每条线的结构都是 L0 → L1 → L2 派生,其中:
- L0 = 原始来源(transcript 原文 / 文件正文,不入库或只存指针)
- L1 = 人类可读文档(markdown 正本,人能直接打开改)
- L2 = 切片 embed 单元(排序算法真正打分的对象)
- 召回算法是单遍 hybrid 后 roll-up:query 只 embed 一次,在 L2 上融合 embedding cosine + BM25(各自 min-max 归一化,BM25 是设计口径,详见下面的注),top items 按“指向它的 segments 的 max 分”滚回 L1 文件。这样的好处是,只要 L1 里面有一段很符合就得分高(理论上这种算法让长文件占便宜,但实测下来 L1 都不算长,所以这个偏差可接受),返回给 agent 的是位置 + 摘要,整篇 content 按需读取,符合渐进式披露原则。由于没有引入 graph 设计,所以无 item-item 边、无 entity 索引、无遍历、无多跳。
为什么暂时不上 graph 呢?给了四条理由:
- embedding search 和 graph 可分,前者是页面上的扁平能力,后者是额外加的边和遍历;
- 三线需求不同,skill 是“当前任务适配哪个 skill”的扁平 top-k,上 graph 只加成本几乎零价值,kernel 既然三线共享就不为一条线配 graph machinery;
- 没有多跳遍历,entity 索引只是 ranking feature,“不配 graph machinery”,hybrid 已同时覆盖语义和精确词匹配;
- 量级和成本不支持——sqlite 存 embedding JSON 文本暴力 cosine,pgvector 只在 postgres 档才有,进程内 kernel、无外部 DB、无检索侧 LLM,上 graph 意味着边存储 + entity 抽取 + 遍历延迟全加上,却没有 benchmark 佐证上 graph 表现显著更优。
按 ADR 0007 的口径,graph 不是不能加,是门槛很高——必须拿 benchmark 证明有显著增益才能加。说人话就是:个人量级下,图那点召回增益,盖不住它在边存储、entity 抽取、遍历延迟、边维护的成本。真到单遍稳定漏检的那天,也是先把 entity 加回来当第三个加分项,多跳遍历成本太高,之后再考虑。
那么缺点是什么呢——由于三条线之间没有边的存在,同一 trajectory 的三种投影(三种 treatment),各存各的 L1 文档 + L2 切片,并且相互之间不能跨线链接,workspace 内部的关联也只认现成的结构——文件层级、显式引用这种,不做语义上“聪明”的链接。
当然三线解耦也是有好处的,一是独立触发,chat 改了只重建 chat,不再重新合成 skills;二是把原来 memorize / retrieve 里各 ~1500 行的大 mixin 拆开,三条线各管各的。
3. trajectory 是唯一主源:三种投影,两道接缝
前面两节我们写完了主要的技术架构——解决怎么存、怎么排的问题。这一节写“源”的问题,以什么数据来作为源数据,才能让 Agent 提取到最有价值的信息呢?这是 ADR 0008 处理的问题。
在 0008 之前,要进入到蒸馏的这一步,需要人(或者照着 SKILL.md 走的 Agent)手动跑 CLI,对着一个整理好的文件夹做后续处理,这时候的源是被放进 chat/ 或者 agent/ 文件夹里的东西,所以这里用户实际上同时处理了两个问题,一是 data 问题——用户决定放什么源数据进去;二是分类问题——用户还需要将这些 data 分类到对应的目录文件夹中。
这个设计当然是有缺陷的,所以在 0008 时,memU 选择使用 trajectory 当唯一源,两个好处:
- 一是固定了 data 来源,保证 data 质量。trajectory 本身就是高质量上下文——用户消息、Agent 推理过程、工具调用都在这里面了,还有明显的时序关系,非常适合作为源数据(不过 memU 实际只取了其中两类,下面会说)。
- 二是固定了 data 源之后,记忆分类问题就可以被相对稳定地解决了。trajectory 本身是一对多的,同一段轨迹里面同时包含用户是谁、agent 怎么把事办成的、项目现在处于什么状态等重要信息。
举个例子,用户花二十分钟排查一次发布失败,这二十分钟里可以提炼出“用户在意发布链路的可靠性”(一条 user fact)、“下次遇到这类报错按这几步查”(一个 skill)、“站点配置现在是什么状态”(一次 project 更新)等等信息,信息量是足够的,我们基于轨迹数据的特点,再去设计目录分类,这样尽管每个 user 的轨迹数据天差地别,但本质不变,生产结果会更稳定(如果 data 本身是什么都不知道,企图找到一个通用适配的目录设计往往是徒劳的)。
在目前的设计里面,三条线的 L0 是同一条 trajectory 的三种投影:
| 线 | L0 取这条 trajectory 的哪一部分 | L1 | L2 |
|---|---|---|---|
| memory | 只有用户提问与 Agent 回答,不含工具痕迹 | 摘要出来的 memory 文档 | 文档切片 |
| skill | 完整轨迹,turns + 工具调用 | 合成出来的 skill | skill 的 description |
| project | 轨迹中被触碰文件的内容 | 文件内容的摘要 | 摘要切片 |
这张表落到代码上,就是实测里看到的三种 job:memory job 读 N.jsonl(干净对话),skill job 读 N_full.jsonl(带 tool calls 的完整轨迹),resource job 读 touched-file 记录。同一段会话切三次,每次只取自己要的那个投影,注意投影这一步是纯代码,不花任何模型成本:_split() 遍历每条 record,role 是 tool 的只进 _full.jsonl,user / assistant 的两份都进,其余(session 元数据、reasoning traces)直接丢掉。实际跑一次大概是这样:10 个 session 进去,切出 21 个 job——10 个 memory、10 个 skill,外加 1 个全局的 resource job,秒级完成。
成本其实都压在下一步。Agent 只在 L0 → L1 这里出现一次,对着某条线的投影,读一遍已有文档,决定 nothing / patch / create,再把 markdown 写出来,所以 token 消耗是跟“会话数 × 线数”线性增长,而且相当一部分调用的正确答案本来就是 no-op——你得先付钱,才知道这段不值得记。质量也从这一步开始依赖 Agent 的判断:该不该写、写成什么、要不要去动已有的文件。
这 21 个 job 跑下来,三条路径都走到了:有的 patch 已有文档,有的发现前一个 job 写错了直接合并修正,只有一个判断“已有内容已经覆盖”、什么也没写。但 1/21 的 no-op 率不能当常态读——这批会话全是实事会话,本来就该有产出;真按定时每小时跑,水聊占多数,大部分钱买回来的会是“什么也别记”。判断不稳的痕迹也看得到:两个并行的 job 先后写了同一个文件,另外两个产出的内容轻微重叠——都看着同一批事实,也都判断“该写”。可见这一步更像是判断,而不是机械执行,换个模型或者换个时机,结果是会不一样的。
从架构上看,L0 是三个平行的投影,但从实现细节上看,实际上三条线拿到的材料仍有较大差异,这里单独说明两个点:
一是思维链数据被丢掉了。 classify() 只认 MESSAGE 和 TOOL 两种,其余一律归 OTHER 丢弃,除了思维链数据外,这里面还有 session 元数据、ai-title 自动标题、<environment_context> 注入这类 harness 产生的数据。memU 的判断是“这不算发生过的事”——如果用人类来对比,那么 tool call 是我们做出的动作,message 是我们说出的语言,而思维链只是我们的思考,属于“草稿”(而且这个草稿里往往大半是自己提出又自己否决的路线)。
我们知道思维链数据在模型蒸馏中很重要,一定程度上 LLM 厂商可以通过 CoT 结果反向拟合某个模型的参数分布。但对于个人用户来说,也许这个取舍是对的,对 memory 质量损害有限(毕竟这里只记录对话),而且还有防守价值——因为思维链是整条日志里噪音密度最高、措辞却又最自信的部分,“用户应该是想要 X”“这里先简单处理一下”都是以肯定句写的临时判断,在蒸馏过程中喂给一个要决定“什么值得长期记住”的 LLM 时,很容易诱导 LLM 把临时情境固化成长期 memory。
但反过来说,对于 skill 线,也许是实打实的缺口:LLM 拿到了完整动作序列却没有对应意图,只能从“调了什么工具、什么顺序”这个数据里面提炼出一套工作流程,对于使用这个 skill 的 Agent 来说,如果不出问题还好,一出问题它就得反推每一步为什么这么做,这时候把“为什么”记录下来也许是重要的。
(注:不清楚是不是嫌 CoT 太长。但整条路径上我们没有观察到任何截断或预算逻辑,而且真要省体积,第一个该砍的是 tool 输出:本机 Hermes 的会话库里,tool 记录占了全部消息的将近一半。)
二是 project 线的 L0 不由 prepare 产生,它要等 skill job 跑完才存在。 memory 和 skill 的投影是 prepare 当场从 state.db 里切好落盘的,纯代码;project 线不一样——“这段会话碰过哪些文件”这份清单没有任何代码去算(实际上也做不到),而是 skill job 的 Agent 干完自己的活之后,顺手把本段创建或修改过的文件路径 echo >> 追加进一个日志(skill job 指令的 Step 4,不管前面选了 nothing 还是 create 都要执行)。
换句话说,project 线的原料是 skill 线的副产品。memU 自己清楚这个依赖,把 resource job 的编号钉死成 2 * num_sessions + 1——10 个 session 就是第 21 号,排在 10 个 memory 和 10 个 skill 之后收尾。另外 prepare 每次开跑会先把这个日志删掉,因为它是 per-run 的,留着会跨轮累积,而 verify 只取前 N 条,旧路径会把本轮真正碰过的文件挤出去。
这个设计的脆弱处也就很明显了:如果 skill job 的 Agent 漏了 Step 4,或者 job 没按编号顺序跑,那么 project 线就是空的——而且不报错,verify-resources 就回你一句 0 resource(s)。我们撞到的就是后一种:resource job 被提前跑了,读到的是 prepare 刚清空的日志。
另外 cloud 后端还有一层限制,doctor 自己会写明 resources accepted but not currently persisted by memU Cloud——所以 project 线的完全体只能走 local。
主源定了,剩下的问题是什么时候抽、什么时候读。这里 memU 面对一个很实际的麻烦:每个宿主的 hook 系统都不一样,Claude Code 是 settings.json 里的事件,Codex、OpenClaw、Hermes 各有各的一套。“直接用 hooks 不就行了”听着简单,但那其实不是一个集成,是 N 个集成。
memU 的解法是往上抽一层:定义一份契约,只留两道接缝,每个宿主写一个薄薄的 adapter,把自己的原生事件映射上来。
| 接缝 | 什么时候触发 | 干什么 | 怎么执行 |
|---|---|---|---|
on_turn |
一轮结束后(用户消息 + Agent 轨迹都齐了) | 追加这一轮的原始轨迹,触发 memorize | 异步、后台、不阻塞 |
on_prompt |
Agent 生成之前 | 拿当前 prompt 去检索,命中拼进上下文 | 同步,在关键路径上 |
新接一个宿主 = 写一个 adapter,kernel 和 CLI 都不用动。这里还有条硬规矩:hook 不许加引擎——adapter 能做的任何事,都必须能用底层那对命令表达出来,它只是编排,不是第二个引擎。这样才有可能用一套机制同时服务两种人:想开箱即用、一行代码都不改的普通用户,和要自己控制时机与批次、直接调 API 的开发者。两边写进同一个 store,混用也不会分叉。
on_turn 是异步的。 记录这件事不影响当前这一轮的输出,晚几分钟甚至晚一小时都不改变正确性,所以它可以进入队列后台跑,会话该怎么继续怎么继续。好处是记录这一步本身很重——蒸馏一段轨迹要读旧文档、要判断是 patch 还是新建,时间很长,这些动作放在关键路径上是不可接受的,放在后台就无所谓。代价是刚结束的这几轮对话,在紧接着的下一个 prompt 上可能还检索不到,时间上有一些取舍。
on_prompt 是同步的。 记忆要影响这一轮的输出,就必须赶在这一轮生成之前到位,所以时效性很重要,它受三条约束:一是时间约束,不调 LLM,只做单发检索(就是上一节说的 query embed 一次、排 L2、roll-up 回 L1),因为每轮都要跑,重路由根本跑不起;二是 token 预算约束,命中再多也得截断,不能无穷无尽;三是 fail-open——没命中、超时、store 是空的,一律注入空集,这一轮照常进行,记忆层挂不会让 Agent 一起挂。
这两道缝之间还有一条不能违反的约束(ADR 0009):record 和 inject 必须指向同一个 store、同一个 embedding 空间。因为 inject 时 query 要被 embed,拿去和 record 时写进去的向量比大小,两边的 DSN 或者 embedding 模型只要有一处不一致,比较就没有意义——检索会安静地返回空,不报错,就是什么都查不到。memU 的处理是让两条接缝共用同一个 config loader,必需配置缺失时直接抛异常,绝不回退默认值;一旦回退,某个入口悄悄用了默认的 ./data/memu.sqlite3,而 bridging 写去了配置好的 DSN,整套东西会“成功运行”且永远查不到任何东西。
还有一个坑是,蒸馏会话本身也是一个会话,不拦住的话,“整理记忆”这个过程会被当成新素材再整理一遍,所以要对蒸馏会话做标记,在蒸馏时把这些会话排除出去。(注 ADR 0015:身份来自宿主的环境变量,gate 放在启动侧而不是命令侧,扫到自己的会话直接跳过;而认不出身份的一律当人处理——只许多记,不许丢。)这个坑我们实际踩到了一次,不过也是预期之中。我把那 21 个 job 直接通过 hermes 派给子 Agent 跑,而在 hermes 端,每个子 Agent 都会开一个属于自己的会话;跑完之后回头查库,二十多个 worker 会话全部没有打上身份标签,所以下一次 prepare 会把它们当成最新的人类会话切出来整蒸馏。原因主要是有两条:一是身份来自环境变量而 gate 在启动侧,手动跑没带那个变量,整条 bridging 就不认为自己是 bridging;二是子 Agent 会话是平行独立 id,没有嵌套归属关系,就算父会话标记了自己,这个身份也传不到子 Agent 开出来的会话上。
对 memU 和 memory 的一些想法
前面的技术架构部分就先写这么多,接下来是对 memU 和 memory 的一些想法。
1. memory 的本质是帮助 Agent 更好完成任务
我对开源记忆系统最初始的研究其实主要是 mem0,memU 是最近才仔细看这个项目的,在日常使用 hermes 的过程中,也尝试加上了 mem0 或者 memU 作为额外的“记忆层”(其实 hermes 本身是有 memory 层的),但我自己的感受是 memU 和 mem0 帮助十分有限,实际运行过程中,几乎不怎么改变 Agent 的动作和状态。
回到本质,我们为什么希望 Agent 有 memory ?其实我们是希望 Agent 知道所需的上下文信息,帮助它更好地完成任务,无需人类多轮交互不断补充细节,所以评价的标准本质应该是“任务导向”的,比如新会话能否直接接住进度、能否避免重复踩已知的坑等等,我们把任务的完成度、耗时、token用量和维护成本放在一起看,才能综合得出一个评价,但现在关于 memory 的一些 benchmark 其实是不够的,大部分 benchmark 还是偏向于“记住”和“召回”本身,考验“记不记得”,但“记得”本身如何影响 Agent 的动作空间,能不能帮助 Agent 做出更正确的判断,就没办法测算了。
事实上,“抽取多少 fact、生成多少 skill、整理多少 memory” 本身只是“memory 有效”的低维映射——由于条件有限,我们只能通过观察这些代理变量来推断 memory 对我们是有用的,有一定道理,但有时候也是一种心理安慰。
2. memU 这个方案真的非常重
第二个想法是感慨 memU 这方案表面上看起来挺“轻巧”的,但实际上非常“重”。首先是每一段会话都要拆为 job 过一遍模型,而这笔 token 是 host 这一侧出的,其次是还得考虑部署、定时调用和重复蒸馏问题,小坑不少。最后,相当一部分对话其实记了也没用,但我们还是得先跑任务才知道这段值不值得记。
它也没有定期整理的机制,L1 那些文档迟早还是要人自己去合并和清理。再加上它对 Agent 的约束是软性的 ,检索这件事是靠提示词要求 Agent 每轮自觉调用的,能不能用起来还取决于 host Agent 老不老实执行。
这个复杂度我觉得大部分个人用户是承担不了的,而且也没必要承担,主要是也没啥用。个人一天的会话量本来就撑不起这套 pipline,蒸出来几十个文件之后呢,还得自己判断哪些重复了、哪些过期了、哪两篇该合成一篇,很麻烦。memU 把这些判断如实地留给了用户和宿主,从工程角度说没问题,但从产品角度来看,一个面向用户的产品,把复杂度暴露出来这么高,潜在用户群体就太小了。
对比之下,mem0 为什么更受欢迎就好理解了。它把复杂度内化在了服务端,LLM 抽取、存储、检索都在它那边,用户侧只剩 add 和 search 两个动作,装上就能用(整个 key 就搞了)。代价是抽出来的东西碎且黑盒子,条件、因果、时间顺序和完成状态在拆分的时候就丢了,召回的时候也很难重新组织回来。
但对大多数人来说,其实也不 care 碎不碎,碎一点但不用维护,可能比整齐但要自己维护更容易接受。所以 mem0 赢的也许不是记忆质量,而是心智负担这一层。
3. skill 自进化是特点,但撞车 hermes
memU 三条线里最有特点的是 skill 自进化,把轨迹蒸成可复用的流程文档,越用越多,形成迭代。这个想法我是认同的,确实抓住了很多小白用户的核心痛点——不会写 skill。
我们姑且不讨论 skill 自进化的成本是啥、收益是啥,只讨论撞车 hermes 这个事情。Hermes 自己就有这套东西,而且我觉得这恰恰是它的核心优势之一——它有自己形成 skill、优化 skill 的机制,是有设计在里面的,纠正和工作经验会被整理进 memory 或者 skill,整个过程留在回路内,由正在干活的那个 Agent 当场完成。
memU 则是事后离线蒸馏,差别就出在时机和位置上。当场的那个 Agent 其实是最知道该怎么改 skill 的,它清楚这一步为什么要这么做、哪里卡住了、用户是怎么纠正它的,而事后蒸馏的 job 拿到的只是一份文本轨迹,更麻烦的是,前面说过思维链在投影那一步就被丢掉了,它连意图都看不到,只能从“调了什么工具、什么顺序”去反推这个流程该怎么写。所以 memU 在一个信息更少的位置上,做主 Agent 本来就在做、条件还更好的事情。
所以工具越充分地接入主 Agent,外挂记忆层靠“汇总信息”能提供的增量就越小。如果是个人用户使用,只使用一个 Agent(比如我用了 hermes),那么 memU 在缺少信息的情况下,要证明自己比 host Agent 整理方式更有效,其实是不太现实的。
4. 记忆腐化是大问题——坏记忆比没有记忆更糟
做 memory 系统,其实“存”是最简单的,无脑存东西最容易了,但存进去之后怎么处理 memory 之间的关系,让 memory 不出现腐化问题是困难的。memU 在这块也做了很多处理,比如写前先读再三选一(最实用的一道,patch 和 no-op 都是它给的)、内容 hash 快照(只感知变化,不做判断)、源删除级联(ADR 0007 宣称有),外加半道检索侧的时效排序,旧的会沉底,但不会被删。
但归根到底,还是只解决了“存哪些”的问题,没有做 TTL、矛盾检测和定期重整,底层约束在于单个 job 的上下文太窄了,它只看得见当下的 mirror 和自己这一段轨迹,看不见谁已经过期了,这是没办法的事情。比如一条“某方案待验证”的条目,验完之后没有任何机制回来把它划掉,写它的那个 job 早就结束了,而验证发生在另一段轨迹里,那一段的 job 也不会去翻自己没读过的文件,于是这两个东西就独立地“存”在了 memory 里面。
理论上我们可以添加各种外挂型治理方法,比如定时重整(prune / merge / refresh,带行数预算)、人工审阅 L1(自动化只许 add,delete 和 merge 收归人工)、时间敏感的条目写明有效期等等,但这又是后话了,这些多少都带点“缝缝补补”的意思。
我还想强调一点,记忆腐化不是零收益,而是负收益。一条过期的约束被召回之后,Agent 是会当真去遵守的,而且它比我们更容易相信这条记忆——因为理论上,它是个“全新”的 Agent ,我们人不一样,也许我们回忆一下,能想起来那是半年前写的。坏的记忆会把 Agent 带偏,而且带得相当隐蔽(毕竟人很难知道 Agent 被注入了什么)。
5. 复杂的记忆层一定更好用吗
这里讲一些反例:Claude Code、Codex 这些公认最能干活的 Agent,都没有上复杂的记忆层——没有向量检索,没有多线蒸馏,常驻记忆的预算也都压得很小。
Claude Code 的自动记忆就是一个索引文件,加载前 200 行或 25KB,详细内容放在独立主题文件里按需读取;Hermes 虽然有自己的 skill 机制,但默认的 MEMORY.md 也只有 2200 字符、USER.md 1375 字符;Codex 干脆就在开工前读一下项目的 AGENTS.md,最近才上了轻量的 memory。
但其实也不耽误干活,memory 轻量并不代表信息一定会丢失,详细资料留在外面当个外挂知识库,需要的时候再读就行了。Agent 每次都得带着的上下文,可能确实没有我们人类想象中需要的那么多,就像一个项目十万行代码,也不意味着要提炼出几千条 fact 才能继续开发,实际上读一部分相关的就行了。
再往下想一层,如果 repo 和 session 都还在,很多 memory 其实只是一份省重建成本的摘要,还额外承担了压缩失真的代价。repo 记录当前实现,session 记录讨论和探索,Git 记录变化。而且模型能力是个递增函数,旧模型当时删掉的细节,恰恰可能是新模型用得上的依据,只留下旧摘要,某种程度上等于提前替未来的模型决定了哪些信息永远不值得看。
所以 memory 的价值很大程度上放在了减少 “reasoning” 成本上——在有限预算下让有效信息用得更好更快。当我们的预算放宽之后,它的必要性就下降了,这几个 Agent 框架的克制其实也是有权衡的。
6. 少数 Agent 的世界里,通用记忆层还剩多少位置
最后总结一下,如果未来是少数几个 Agent 框架承担大部分任务,那通用记忆层的处境确实会比较尴尬,它拿到的和主 Agent 是同一份会话记录,却可能比主 Agent 更晚知道变化。用户当然越来越需要“你记得我们做到哪、别再犯同样的错”,但他们多半是期待自己正在用的那个 Agent 直接做到,而不是再装一层 memory。事实上,一个 Agent 不好用,用户一般不会换 memory 这种组件(毕竟harness还是难做的),而是直接换 Agent,或者就等技术进步。
这样看起来,从商业模式上说,这条路挺难跑通的,独立的 memory 团队得回答一个艰难的问题:在同样的模型、工具、历史记录和成本预算下,接入之后究竟哪类任务能持续做得更好?是真的能稳定减少失误,或者显著降低长程任务的处理成本才算数;如果主要成果是多抽了些 fact、多生成了几个 skill、多整理了几层目录,那只能找benchmark证明自己了。
但有一个方向确实是有意义的,就是组织的通用记忆资产。个人用户大多不跨 Agent,组织却一定是跨的,不同的人、不同的 Agent、不同的工具,一个项目的关键上下文散落在聊天、文档、会议和实际操作里,任何一个 Agent 单独都看不全。这时候共享记忆层就不只是在汇总信息了,它承担的是组织记忆的角色,要解决的是跨人协作中的信息损耗,和单个 Agent 的上下文问题其实是两件事,这个方面通用记忆层的确是有增量价值的。
不过这里又有一个更大的不确定:我们的组织形态真的不会变吗?如果大量执行工作都交给 Agent 了,超大型组织的协作方式本身可能就不是今天这个样子,那么组织记忆要服务的对象是谁、边界划在哪,现在恐怕也没人说得清,看不到终局。
最后回到 memU 本身。它的设计其实是克制且自洽的,服务端不做理解、trajectory 当唯一主源、两道接缝都 fail-open,这些判断我大体都认同,有很多设计值得借鉴。但场景其实很重要,工程化之后还需要产品化——整条链路似乎卡在这里了,个人用户不需要,企业用户又有其他更好的解决方案(尽管重一些,比如 mem0),所以 memU 似乎也是前路未卜。