本篇导读:在进入云服务与 AI Agent 工程架构的深水区时,
进程(Process)、虚拟机(VM)、Docker 容器(Container)、沙箱(Sandbox)以及V8 Isolate是绕不开的基石概念。对于习惯了严谨公理化体系的数学背景学习者而言,计算机工程界层出不穷的名词往往显得杂乱无章;但若抽离掉表层的工程黑话,这些技术本质上都在用代数与集合论的手段回答同一个底层数学问题:当多个状态转移算子(程序)作用在同一个物理全集(硬件)上时,如何构造互不干涉的商空间投影(隔离性)与自包含的环境闭包(可复现性)? 本篇讲义从一台裸机的底层权力结构出发,围绕五个核心问题,将操作系统内核、Docker 与现代 AI 沙箱架构还原为一套清晰的几何与逻辑图景。
问题一:为什么代码不能直接指挥硬件?—— 计算机的“双层权力结构”与数学映射
如果你写了一段简单的 Python 代码:open("report.pdf")(读取硬盘上的文件),或者发起一次网络请求调用大模型 API,你可能会直觉地以为:是你的 Python 程序直接命令硬盘磁头去读数据、命令网卡把数据包发出去的。
在真实的计算机架构中,这是绝对被禁止的。如果允许任何一个普通程序直接操作物理内存地址或硬盘扇区,会发生两场灾难:
- 状态互相踩踏:你一边开着浏览器看网页,一边跑着一段 Python 脚本,Python 脚本算错了一个内存指针,直接把浏览器正在使用的内存区域覆盖掉了,整台电脑瞬间蓝屏死机。
- 毫无安全边界:任何一个恶意的第三方软件都可以直接读取硬盘上所有其他软件的密码文件。
为了解决这个根本矛盾,现代计算机在硬件(CPU)与操作系统层面,设计了一套极其森严的“双层权力结构”——将计算空间一刀切为 内核态(Kernel Space) 与 用户态(User Space):
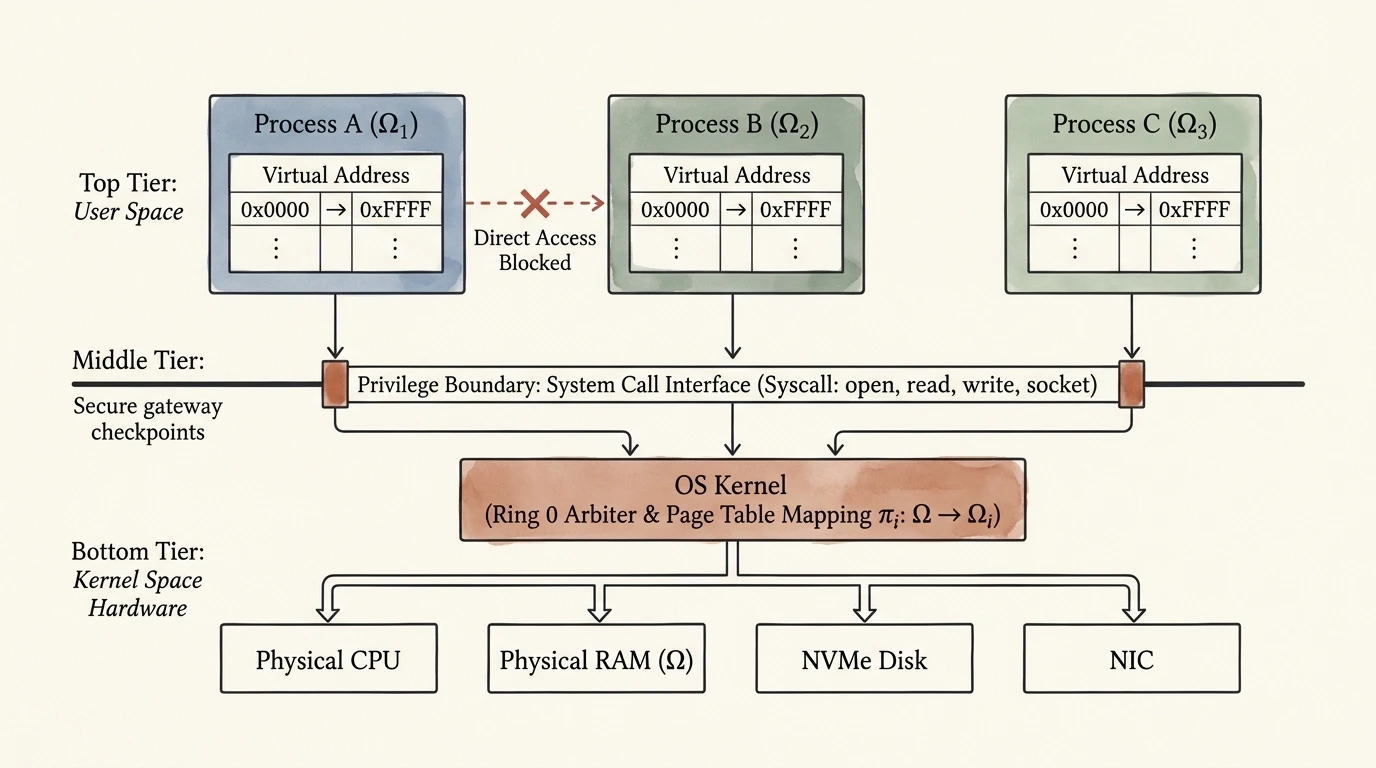 图:计算机“用户态(User Space)— 内核态(Kernel Space)”双层权力结构的几何映射。上方用户态中的每个进程(Process A/B/C)都活在由内核页表投影算子 构造的独立局部虚拟地址空间(
0x0000 0xFFFF)中,进程间的横向直接访问与对底层硬件的直接触碰均被硬件级拦截(红色虚线叉号);任何外部读写操作必须严格通过中间唯一的特权边界——系统调用接口(Syscall),由下方处于 Ring 0 最高特权级的操作系统内核(OS Kernel)验权后代为操作物理硬件全集 。
1. 四个核心底座概念的数学与现实映射
| 核心概念 | 工程定义 | 数学直觉映射 | 现实生活隐喻 |
|---|---|---|---|
| 硬件(Hardware) | CPU、物理内存条(RAM)、硬盘、网卡等真实硅片设备。 | 底层物理全集 :所有计算状态真实寄宿的基底流形。 | 银行地底下的金库与印钞机。 |
| 操作系统内核(OS Kernel) | 电脑开机后第一个加载、常驻内存最底层、唯一拥有 CPU 最高特权级(Ring 0)的核心程序。 | 全局测度分配器与坐标映射算子 :负责把物理全集 切分成互不重叠的子集,并校验一切跨界操作。 | 银行柜台后面的总行金库管理员(全行只有他能进金库碰真钱)。 |
| 进程(Process) | 一个正在运行中的程序实例(例如你敲下 node server.js 后跑起来的那个任务)。 |
局部坐标系下的状态转移算子 :内核给它分配了一个独立的虚拟地址空间 ,通过双射页表 映射到物理内存。 | 站在防弹玻璃柜台外办业务的储户。 |
| 系统调用(Syscall) | 用户态进程向内核请求硬件服务(读写文件、发网络包、申请内存)的唯一标准函数接口(约 300 多个)。 | 受控边界算子:进程不能直接修改外部世界,只能向内核提交参数向量,由内核判定合法性后代为执行。 | 从防弹玻璃底下的小槽递进去的《取款申请单》。 |
[!IMPORTANT] 理解后续一切容器与沙箱的第一把钥匙:任何程序想要“干坏事”或“影响外界”,都必须经过
Syscall(系统调用)这道关口! 无论一段代码是用 Python、JavaScript 还是 C 语言写的,只要它运行在用户态,它本身就是一个“手无寸铁的数学计算器”(只能在自己的局部内存里做加减乘除)。一旦它想碰硬盘上的一个文件、或者往外发一个网络包,它必须调用操作系统的Syscall(向柜台递申请单)。后文要讲的 Docker 与各类 Sandbox,本质上全都是在“柜台申请单(Syscall)”和“局部坐标系映射”上做文章。
问题二:到底什么是 Docker?—— 用数学的“环境闭包(Closure)”终结工程乱象
1. 为什么“直接传代码”在工程上会频频翻车?
用数学语言来描述:初学者往往以为自己写的代码 app.py 是一个纯函数(Pure Function) ——只要输入相同的请求 ,无论在哪台电脑上跑,都应该得出相同的输出 。
但在真实的计算机里,你的代码根本不是一个封闭函数,而是一个带有大量隐式自由变量(Free Variables)的开公式(Open Formula):
这里的环境向量 包括:
- :操作系统的系统级动态链接库版本(如 Linux 的
glibc 2.35还是2.28); - :编程语言运行时版本(如
Node.js 22还是Node.js 16); - :电脑上额外安装的二进制命令行工具(例如在知识库检索服务中用于毫秒级全文扫描的
ripgrep(rg)); - :操作系统的文件路径格式与系统字库(例如用 Python 画图时服务器缺少中文字体导致乱码)。
当你在自己的电脑(环境为 )上调试通过,把代码发给同事或部署到云服务器(环境为 )上时,一旦 (比如云服务器上没装 rg 命令,或者装的 Python 版本不对),函数求值就会立刻报错崩溃。这就是困扰了软件工程界几十年的经典噩梦:“在我电脑上明明是好的!(It works on my machine!)”
2. Docker 的本质:构造一个自包含的“环境闭包(Closure)”
在数学与逻辑学中,如何把一个依赖外部自由变量 的开公式 变成一个在任何地方都能独立求值的闭项(Closed Term)?答案是把函数 与它所依赖的具体环境取值 打包绑定成一个整体元组(即闭包 Closure):
Docker 所做的事情,在数学上与构造闭包完全同构:
它不再让你只把薄薄的几页业务代码 传给服务器,而是把 “你的业务代码 + 运行所需的语言环境 + 第三方库 + ripgrep 等系统工具 + 一套极简的 Linux 目录结构 ” 严丝合缝地封印进一个不可变的标准化集装箱——这个集装箱的静态文件包就叫 Docker 镜像(Image),把它在服务器上启动运行起来就叫 Docker 容器(Container)。
3. 灵魂追问:既然要连环境一起打包,Docker 容器和传统虚拟机(VM)有什么区别?
这是理解现代云原生架构最关键的分水岭。既然都要把“代码 + 运行环境”装进盒子里,第一代技术(虚拟机 Virtual Machine) 和 第二代技术(Docker 容器 Container) 采用了截然不同的几何切分层级:
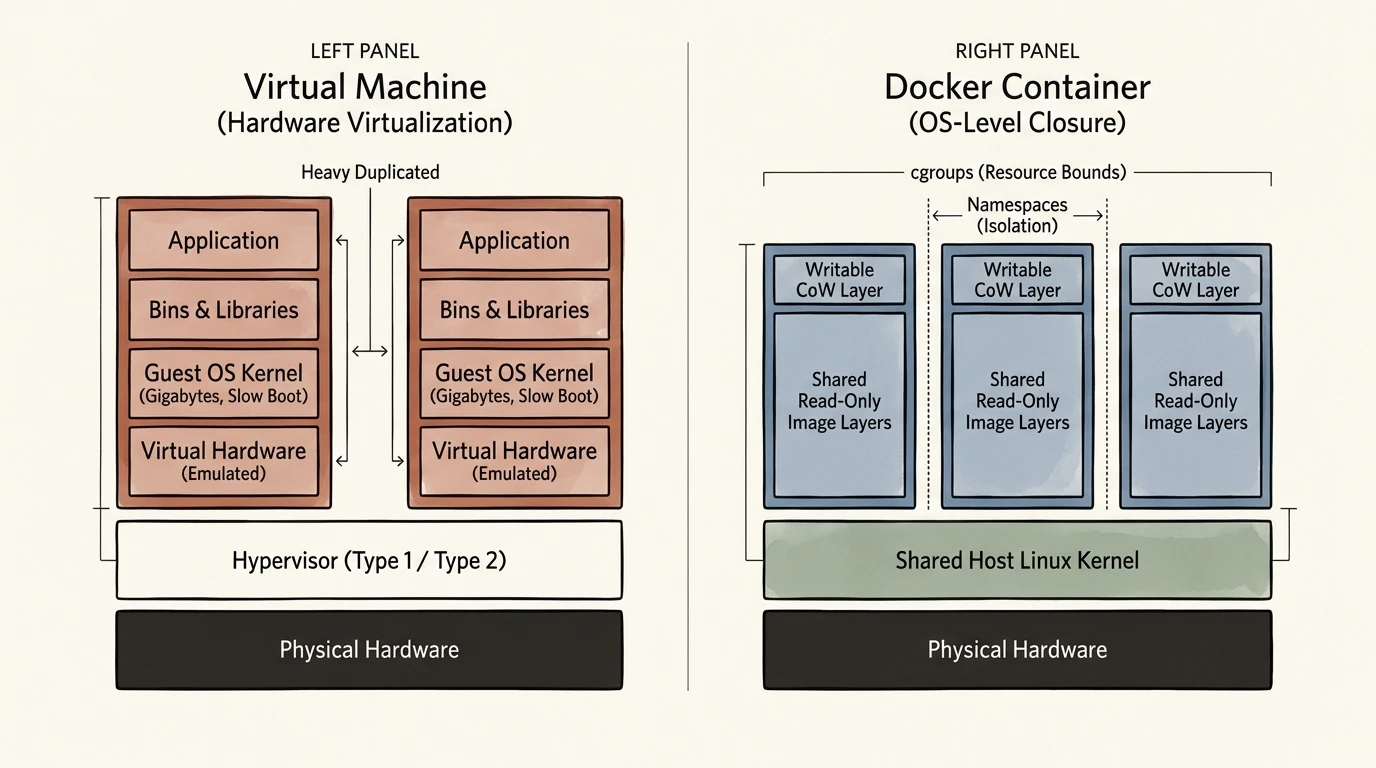 图:传统虚拟机(左)与 Docker 容器(右)的几何切分层级对比。左图(Virtual Machine):在 Hypervisor 之上为每个应用重复伪造整套虚拟硬件(Virtual HW)并启动独立的沉重操作系统内核(Guest OS Kernel,占数 GB 内存、开机需 60 秒);右图(Docker Container):所有容器直接共享宿主机唯一的真实 Linux 内核(绿色基底),仅通过
Namespaces(局部坐标投影 )、cgroups(资源上界约束)与 UnionFS(底层共享只读镜像层 叠加顶层极薄可写层 )切分出轻量化环境闭包 ,实现毫秒/秒级启动。
- 传统虚拟机(VM)= 在大楼里“再盖一栋带独立地基的假别墅” 为了隔离两个程序,虚拟机用软件(Hypervisor)硬生生模拟出一套假的 CPU、假的硬盘、假的网卡,然后在上面从头开机安装一套完整的 Linux 操作系统内核。哪怕你的代码只有 10KB,为了跑它也得先启动一个占 2GB 内存、开机要等 1 分钟的庞大操作系统。
- Docker 容器(Container)= 共用同一栋大楼的真实地基(共享内核),只用“三道数学障眼法”切出独立精装公寓 Docker 发现了一个惊人的事实:同一台服务器上的不同程序,根本不需要各自拥有一套独立的操作系统内核!它们完全可以共用宿主机那唯一一个真实的 Linux 内核,只要内核在给每个容器办理业务时,施展三道原生算子即可:
| Linux 内核的三道隔离算子 | 数学本质 | 它对容器里的程序做了什么? |
|---|---|---|
| 1. Namespace(命名空间) | 局部坐标投影 (修改观察视图) | 障眼法:给容器戴上一副“VR 眼镜”。容器里的 Node.js 进程查自己的进程号,看到的是 PID = 1(以为这台电脑上只有它一个程序);看硬盘根目录 /,看到的只是宿主机某个子文件夹下的文件。它根本看不见隔壁容器的存在。 |
| 2. cgroups(控制组) | 有界测度约束 (施加上确界) | 限流阀:因为大家共用真硬件,万一容器 A 写了个死循环怎么办?内核用 cgroups 死死卡住不等式:容器 A 最多只能用 0.5 核 CPU 和 512MB 内存,一旦超标直接掐断,绝不连累整栋大楼。 |
| 3. UnionFS(联合文件系统) | 不可变基向量 差分增量叠加 | 千层饼叠图:如果你起 10 个都用 Debian + Node 22 的容器,硬盘上绝不会复制 10 份 Node 22。大家底层共享同一份只读的基础图层 ,每个容器只在最顶上铺一张薄薄的“透明可写塑料膜 (写时复制 Copy-on-Write)”。 |
4. 一眼看懂 Docker 的三个日常名词:Dockerfile、Image(镜像) 与 Container(容器)
用数学与编程概念来对应,这三者的关系清楚得不能再清楚:
Dockerfile(配方公式 / 构造公理):一份纯文本清单,仅有十几行,写明“底层基于什么系统、要装什么软件、把哪些代码拷进去、启动时敲什么命令”。Docker Image(镜像 = 不可变的静态集合 / 类定义 Class):按照Dockerfile配方打包压缩出来的只读文件包。你可以把它上传到云端仓库(如 Google Artifact Registry 或 Docker Hub),在任何电脑上拉取下来都一模一样。Docker Container(容器 = 运行中的动态算子 / 实例 Instance):把静态的Image启动起来,在顶层加上一层可写内存空间 ,变成宿主机上的一个受控进程。同一个Image可以瞬间复印启动出 100 个Container。
[!TIP] 实战直觉:为什么混合了语言运行时与系统二进制工具的 AI 服务必须容器化? 以典型的结构化知识库问答服务为例,它不仅包含 TypeScript 业务代码,还强依赖系统级的
ripgrep(rg命令)来毫秒级检索文档,以及 SQLite 来存储多轮会话状态。如果直接把源码发给运维团队部署,目标服务器上万一没装rg或者二进制路径不一致,服务就会当场报错。 而只要在项目根目录下放一份 10 行的Dockerfile(见文末附录 B),把Node 22 + ripgrep + 源码 + 知识库打包成一个标准 Docker 镜像,无论部署到企业内网服务器,还是推上 GCP Cloud Run,敲一行命令就能 100% 原样跑起来,彻底告别环境配置!
问题三:到底什么是 Sandbox(沙箱/沙盒)?—— 它跟 Docker 是同一个东西吗?
在讨论 AI Agent 和云服务时,人们经常一会儿说“装进 Docker 容器里”,一会儿又说“放进 Sandbox(沙箱)里执行”。既然 Docker 已经把程序隔离开了,为什么还需要“沙箱(Sandbox)”这个概念?它们到底有什么区别?
答案只有一句话:Docker 解决的是“工程一致性(防外乱内)”,而 Sandbox 解决的是“零信任安全边界(防内乱外)”。
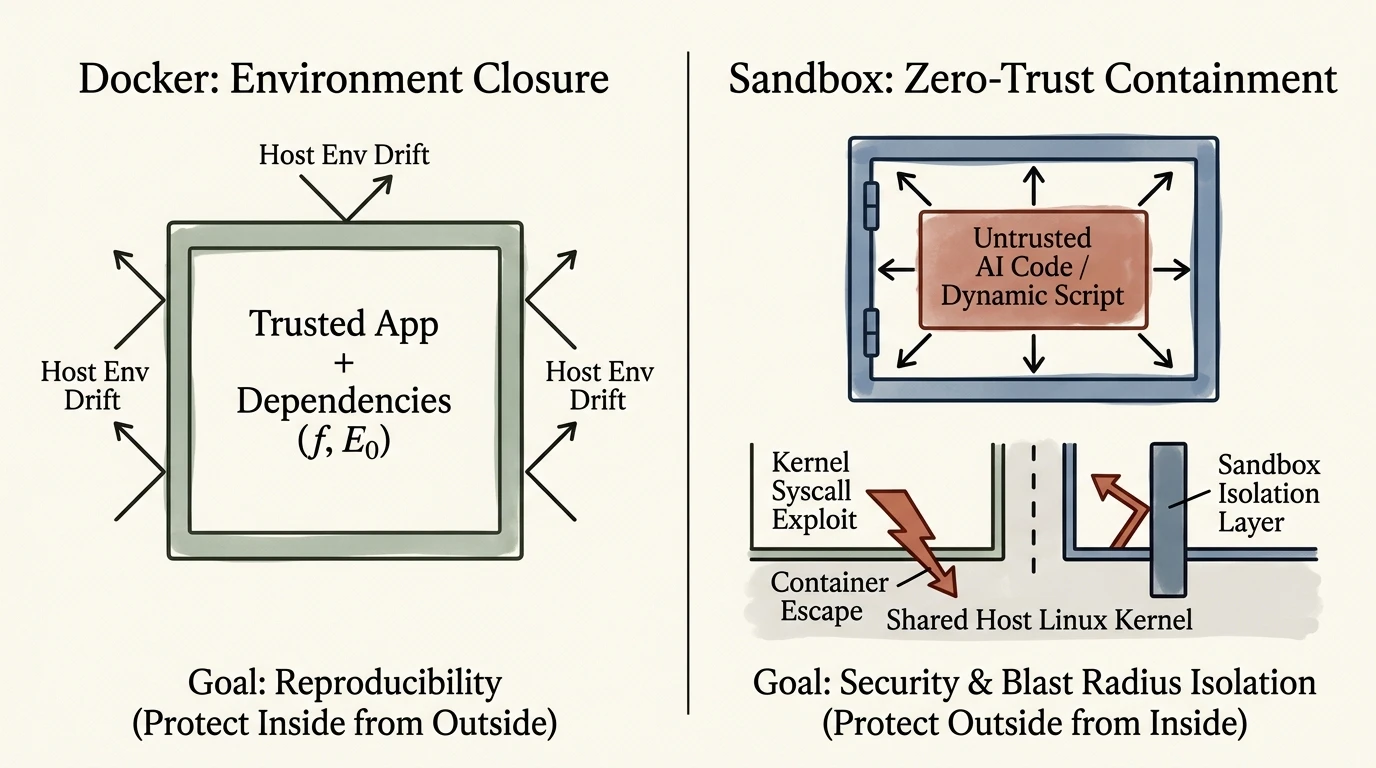 图:Docker 容器与安全沙箱(Sandbox)的威胁模型对立及“容器逃逸(Container Escape)”机理。左图(Docker 视角):核心目标是构造环境闭包 ,将外部宿主机的环境漂移与依赖缺失挡在门外,保护内部受信任代码的可复现性;右图(Sandbox 视角):核心目标是零信任围堵,关住内部不可信的 AI 动态生成代码。右下角揭示了为什么普通 Docker 不等于强安全沙箱:由于普通容器与宿主机共享同一个 Linux 内核,恶意代码可通过构造畸形系统调用触发内核漏洞(红色闪电
Kernel Syscall Exploit),直接凿穿地板夺取宿主机控制权。
1. 核心意图与威胁模型(Threat Model)的根本对立
| 对比维度 | Docker 容器(Container) | 沙箱(Sandbox) |
|---|---|---|
| 一句话隐喻 | 无菌保鲜盒(防止外面的脏空气污染里面的饭菜) | 防爆排弹罐 / 猛兽铁笼(防止里面的炸弹炸毁外面的大楼) |
| 里面跑的代码是谁写的? | 你自己或团队写的业务代码(默认是善良、受信任的)。 | 陌生人提交的代码、或大模型(LLM)实时生成的代码(默认可能是恶意的、产生幻觉的、极具破坏性的)。 |
| 核心诉求 | 可复现性(Reproducibility)与轻量化部署。 | 绝对隔离性(Security Isolation):就算里面的代码执行 rm -rf /(删光硬盘)或试图偷取机密文件,也伤不到外面分毫。 |
2. 为什么“普通 Docker 容器”不能直接当成绝对安全的 AI 沙箱?
这是计算机底层架构中一个极其深刻的事实:因为普通 Docker 容器和宿主机共享同一个操作系统内核(Linux Kernel)!
回到我们在问题一建立的“银行柜台模型”:
- 普通 Docker 容器只是用
Namespace给里面的程序戴了一副 VR 眼镜,但它并没有给容器配一个独立的内核。容器里的程序每次做文件读写或网络操作,依然是在向宿主机那个唯一的真 Linux 内核发起系统调用(Syscall)。 - Linux 内核有超过 300 个系统调用接口、数千万行 C 语言代码。如果你让一个 AI Agent 在普通 Docker 容器里随便写 C 语言或 Python 代码并执行,一旦黑客通过 Prompt 注入诱导 AI 生成了一段专门针对某个生僻系统调用的攻击代码,触发了宿主机 Linux 内核的一个漏洞,容器里的程序就能直接攻破内核(即把银行柜台后面的总管理员打晕),瞬间拿到整台物理服务器和隔壁所有容器的最高控制权!
- 在网络安全领域,这种突破容器边界攻陷宿主机的行为,就叫做 “容器逃逸(Container Escape)”。
因此,Docker 是一种优秀的打包与进程隔离工具,但默认配置的 Docker 并不是一个强安全沙箱。
问题四:AI 时代的“四级沙箱防御光谱”—— 从解耦与原子化看沙箱演进
如果从更高维的数学视角审视云服务的演进史,会发现整部云计算史就是一个不断“解耦(Decoupling)”与“原子化(Atomization)”的过程:
- 第一代(虚拟机 VM):解耦了物理硬件,但每个实例依然背负着沉重的独立操作系统内核;
- 第二代(Docker 容器):解耦了操作系统内核,只把用户态文件系统与依赖打包成闭包;
- 第三代(V8 Isolate):连操作系统用户态都一并剥离,只留下最纯粹的语言内存堆与状态转移函数。
而在安全防御维度上,按照“在哪个数学层级上做截断与隔离”,现代沙箱技术从最轻到最重,同样形成了一条严密的四级防御光谱:
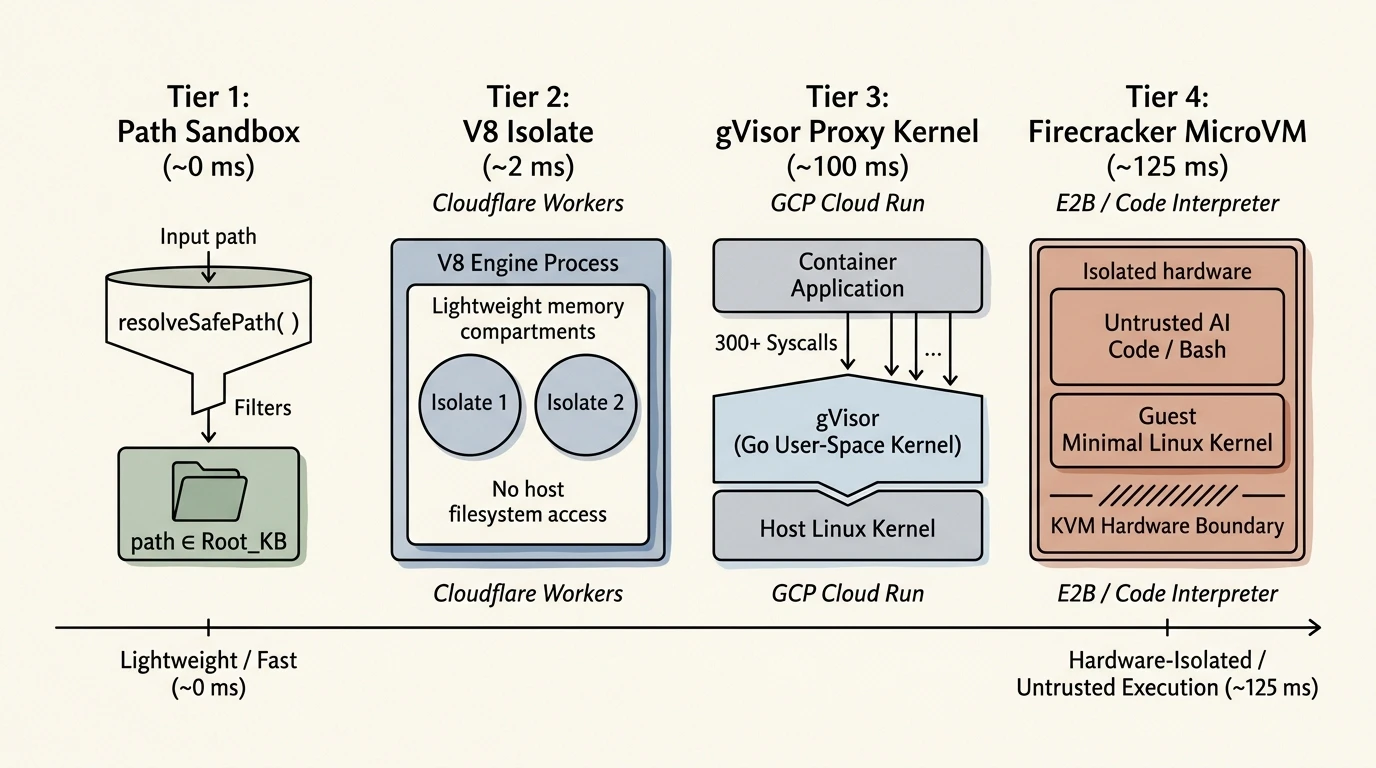 图:AI 时代的四级沙箱(Sandbox)隔离光谱演进。从左至右隔离深度递增:Tier 1(
~0 ms)在应用层通过 resolveSafePath() 限制文件路径子集包含关系 (如受控知识库问答 Agent);Tier 2(~2 ms)在单个 V8 引擎进程内切分无底层操作系统接口的独立内存堆 Isolate(如 Cloudflare Workers 上的全栈应用);Tier 3(~100 ms)在容器与真内核之间嵌入用 Go 编写的替身内核 gVisor,拦截过滤全部 300+ 个系统调用(如 GCP Cloud Run);Tier 4(~125 ms)通过 KVM 硬件虚拟化与极简独立内核构造 Firecracker MicroVM,专为运行完全不可信的 AI 动态代码而生(如 E2B / Code Interpreter)。
第 1 级:应用层路径沙箱(Application-Level Sandbox)
- 典型架构对应:受控知识库问答 Agent 中的只读文件工具层。
- 数学与架构原理:大模型本身在远端,它只能通过返回 JSON 请求服务端程序代为调用工具。系统根本不向大模型暴露
bash(任意命令行)工具,只提供定义域极窄的四个只读函数:ls、find、grep、read。并且,在每个函数执行的第一行,都经过一道严格的集合包含校验算子resolveSafePath(inputPath): 哪怕大模型中了黑客的提示词注入攻击,试图传入../../../../etc/passwd或../../../../Windows/System32/cmd.exe(目录穿越攻击),只要解析后的绝对路径落在知识库子集之外,函数立刻抛出异常拒绝执行。 - 优缺点:零性能损耗、极度可控;但局限是 AI 只能按预设的几个固定动作查文件,不能自己写一段 Python 脚本去算一笔复杂账目。
第 2 级:语言虚拟机微沙箱(V8 Isolate / WebAssembly)
- 典型架构对应:运行在全球边缘节点上的 Cloudflare Workers。
- 为什么 Cloudflare 能让全球几百万开发者的代码跑在同一批服务器上,既不用笨重的虚拟机、也不用启动慢的 Docker,还能做到毫秒级唤醒且互不偷看数据? 秘密就在于 Google Chrome 浏览器背后的核心引擎——V8 Isolate(V8 隔离实例)。
- 数学与架构原理:
想一想平时用 Chrome 浏览器同时打开 20 个网页标签页(比如标签页 1 是网银,标签页 2 是一个来路不明的小游戏网站)。为什么小游戏网站里的 JavaScript 代码偷不走隔壁网银标签页里的存款数据,也删不掉电脑桌面上的文件?
因为 Chrome 的 V8 引擎为每个标签页在内存里画出了一个完全独立的变量与堆内存空间(Isolate)——它们之间没有任何内存指针可以互通,而且 V8 引擎从根源上就没有提供“直接读写电脑本地硬盘”或“直接调用操作系统
Syscall”的语法! Cloudflare 把浏览器的这项技术搬到了云端服务器上:不再为每个用户的代码起一个 Docker 容器,而是在同一个大型 V8 宿主进程里,花 2 毫秒切出一个只占 3MB 内存的V8 Isolate沙箱来运行业务代码。 - 优缺点:启动速度人类最快(0 冷启动感)、成本极低;代价是沙箱里没有完整的 Linux 操作系统,不能在里面调用本地 C++ 编译的复杂科学计算软件或任意命令行工具。
第 3 级:拦截型内核沙箱(User-Space Kernel Sandbox,以 Google gVisor 为代表)
- 典型架构对应:GCP Cloud Run(Google 云无服务器容器平台)。
- 数学与架构原理:
既然在问题三里发现:普通 Docker 容器最大的安全隐患是“直接向宿主机的真 Linux 内核递交
Syscall申请单”,那怎么把这个漏洞堵死,同时又保持 Docker 的轻快? Google 的工程师设计了一层精妙的架构——gVisor(替身内核 / 保镖内核): 当在 Google Cloud Run 上部署一个 Docker 容器时,容器发出的所有系统调用,根本碰不到底层物理机的真 Linux 内核,而是全部被中间这层用 Go 语言编写的gVisor替身内核(代号Sentry)拦了下来!gVisor自己接管并模拟了文件与网络系统,把 300 多个危险接口消化掉,只用极少数安全指令与底层真内核通信。 - 灵魂追问:既然只是加了一层“替身保镖”,怎么保证黑客不会把保镖和底层真内核一枪一起穿透?
这正是
gVisor在安全工程上最精彩的三重正交防线:- 语言级降维打击(内存安全的 Go vs. 裸指针 C 语言):真 Linux 内核是用 C 语言写的(超 3000 万行代码),历史上 70% 以上的内核逃逸漏洞都源于 C 语言缺乏内存边界检查(缓冲区溢出、悬垂指针)。而
gVisor是用 Go 语言从头写的——Go 语言自带强类型与数组边界检查,一旦发生越界访问,只会触发当前gVisor进程安全崩溃(panic),在物理机制上直接消灭了“通过内存溢出篡改指令流”的攻击路径。 - 保镖自身只是普通用户态进程(Ring 3),且被收缴了 80% 的武器:在宿主机真内核眼里,
gVisor保镖根本不是特权级神明(Ring 0),它只是一个一容器一专属的普通用户态进程。更绝的是,在gVisor启动的一瞬间,真内核就用seccomp过滤器把gVisor自己的手脚捆住了——严禁gVisor调用open(打开文件)或socket(建网络连接)等高危系统调用,只允许它调用约 50 个最基础的内存读写接口。因此,即便黑客万分侥幸攻破了gVisor,他夺舍的也只是一个“连打开新文件权力都没有的残疾进程”。 - 独立小概率事件相乘:想要穿透两层,攻击者必须先在内存安全的 Go 代码里找到一个逻辑漏洞,再在仅剩的 50 个受限基础接口里同时找到一个 C 语言真内核的 0-day 漏洞——两个极小概率正交事件相乘(),在工程上构成了极强的安全壁垒。
- 语言级降维打击(内存安全的 Go vs. 裸指针 C 语言):真 Linux 内核是用 C 语言写的(超 3000 万行代码),历史上 70% 以上的内核逃逸漏洞都源于 C 语言缺乏内存边界检查(缓冲区溢出、悬垂指针)。而
第 4 级:微虚拟机硬件沙箱(MicroVM,以 AWS Firecracker / E2B 为代表)
- 典型架构对应:ChatGPT 的 Code Interpreter(数据分析沙箱)、Claude 的 Analysis Tool、以及专门给 AI Agent 提供代码执行环境的云端沙箱服务(如 E2B、Modal、Cloudflare Sandbox)。
- 数学与架构原理:
如果要打造一个真正的“全能通用 Agent”,允许大模型遇到问题时当场自己写一段 Python 代码、自己
pip install第三方库、自己在终端敲任意 Bash 命令执行、画完图把结果拿回来——这时,代码完全是动态生成且不可预测的,甚至可能包含死循环或破坏性系统指令。 面对这种极端场景,最彻底的物理隔离依然是硬件级虚拟化(每个沙箱拥有自己独立的 Linux 内核)。但传统虚拟机开机要 1 分钟,用户问 AI 一句话怎么可能等 1 分钟? 为此,亚马逊 AWS 发明了震动云计算界的开源技术——Firecracker(微虚拟机 MicroVM):- 它利用 CPU 硬件虚拟化指令(KVM),为每个沙箱提供真正的硬件级铁壁隔离和独立内核;
- 但它做了一次残酷的“极简主义减法”:传统虚拟机之所以慢,是因为开机时要模拟老掉牙的 BIOS 自检、虚拟显卡、虚拟声卡、虚拟软驱、USB 控制器……
Firecracker把这些对云端跑代码毫无意义的模拟设备全部砍光,只留下最纯粹的极简 CPU + 内存 + 一块虚拟网卡 + 一块虚拟块设备。 - 结果是:它既有传统虚拟机的绝对安全隔离(连内核都是独立的),又把开机启动时间从 60 秒压缩到了惊人的 125 毫秒(0.125 秒),内存开销压到了 5MB!AI 每次需要跑代码时,云端瞬间点亮一个 MicroVM 沙箱,跑完 3 秒钟拿到结果后,原地销毁,灰飞烟灭。
问题五:全景决策框架——作为 AI 产品构建者,什么时候该用哪一层?
把上面所有的底层概念串联起来,当设计任何 AI 产品或云端系统时,不再需要被天花乱坠的名词迷惑,只需顺着“运行环境复杂度”与“代码信任边界”这两个正交维度,即可在 10 秒内拍板技术底座:
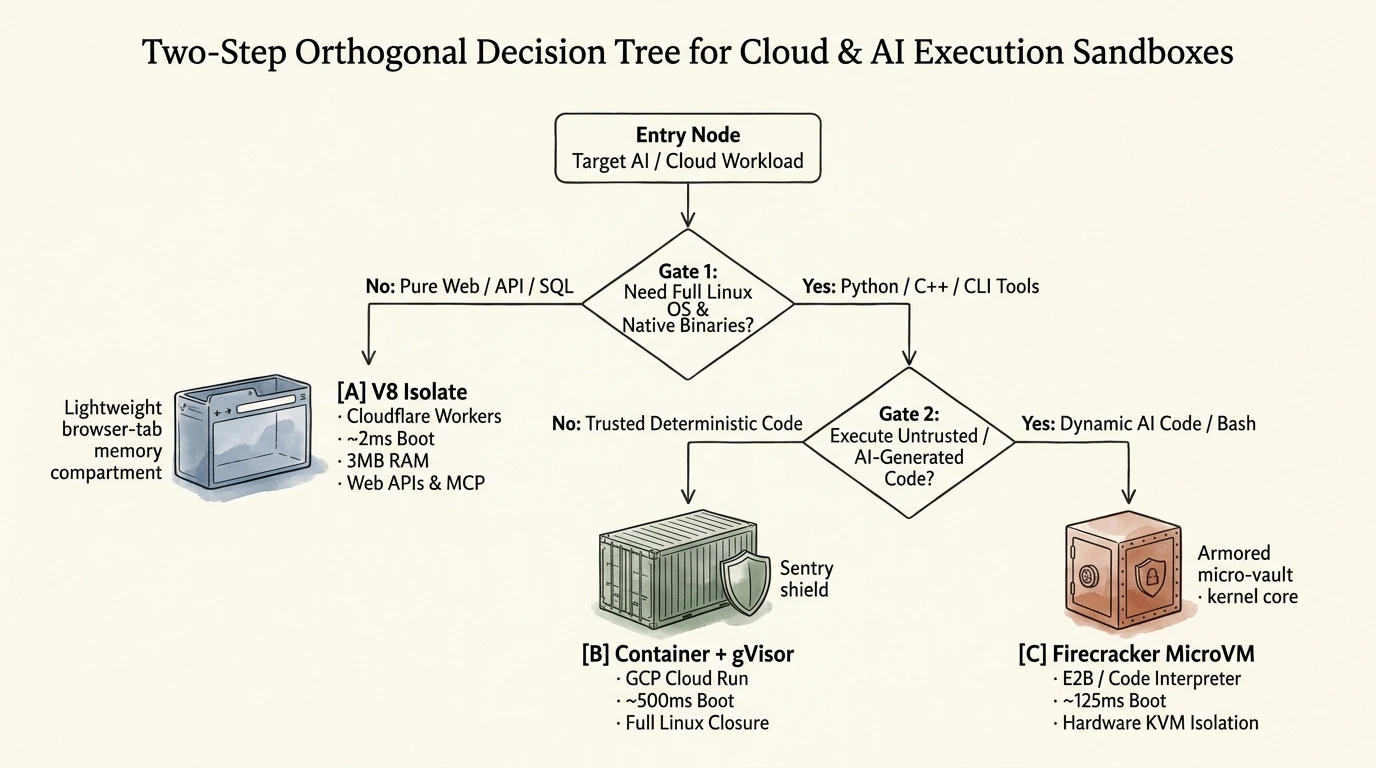 图:AI 与云端系统技术底座两步正交决策树(Two-Step Orthogonal Decision Tree)。第一步(
Gate 1: Need Full Linux OS & Native Binaries?)沿“环境闭包复杂度”切分:仅需纯 Web 路由、API 调用与轻量 SQL 的场景(No)直接落入左下方冷钢蓝浏览器标签页微仓 [A] V8 Isolate(代表平台:Cloudflare Workers,~2 ms 唤醒、3 MB 内存开销,适用于全栈看板、API 网关与远程 MCP 服务端);需要完整 Linux 目录与 Python/C++/CLI 工具链的场景(Yes)进入第二步(Gate 2: Execute Untrusted / AI-Generated Code?),沿“代码信任边界”切分:预先编写的确定性受信任服务端代码(No)落入中间灰绿集装箱加保镖盾牌 [B] Container + gVisor(代表平台:GCP Cloud Run,~500 ms 启动,适用于企业知识库问答后端与确定性数据流水线),而允许 AI 动态生成并自由执行任意 Python / Bash 脚本的场景(Yes)则落入右下方陶土红装甲微金库 [C] Firecracker MicroVM(代表平台:E2B / Code Interpreter,~125 ms 独立内核硬件级隔离、用完即焚)。
四大核心概念终极对照表
| 概念名称 | 解决的核心矛盾 | 隔离边界在哪一层? | 启动耗时量级 | 内存额外开销 | 典型工程坐标 |
|---|---|---|---|---|---|
| 传统虚拟机(VM) | 把一台物理服务器切成多台独立电脑出租 | 硬件层(模拟全套硬件 + 独立 OS 内核) | GCP Compute Engine(整租常驻服务器) |
||
| Docker 容器(Container) | 消灭“环境不一致”,把代码与依赖打包成标准闭包 | 操作系统视图层(共享内核,Namespace 隔离视图) |
生产服务交付的标准集装箱 | ||
| V8 微沙箱(Isolate) | 极致轻量的多租户无服务器函数执行 | 语言虚拟机内存层(同一进程内划分独立堆空间) | Cloudflare Workers 边缘计算引擎 | ||
| AI 安全沙箱(Sandbox / MicroVM) | 关住不可信代码与 AI 幻觉操作,保护宿主系统安全 | 应用路径层 / 替身内核层(gVisor) / 极简硬件层(Firecracker) | (路径级)至 (MicroVM) | 至 | 从 resolveSafePath 只读锁死,到云端 Code Interpreter |
附录 A:隔离性、环境闭包与镜像分层的形式化数学模型
为了用最严谨的数学语言将上述工程概念彻底内化,我们将进程隔离、Docker 打包与沙箱安全形式化为两个紧凑的代数命题。
A.1 状态空间投影与无干涉性(Non-Interference)
设物理服务器的全局硬件状态空间为 (包含所有物理内存地址、磁盘扇区与网络端口)。一个未加隔离的裸机程序本质上是全局空间上的自映射 。当两个程序 并发执行时,若它们的写入值域(写集 )与对方的读取依赖域(读集 )存在非空交集:
系统即发生状态干涉(State Collision / Race Condition)。
操作系统内核(Kernel)与虚拟化机制的数学本质,是构造一族正交局部投影映射 及其局部逆嵌入 ,使得对于不同的隔离实例 ,其像集在物理空间中除只读共享基底 外完全不相交:
在此构造下,每个容器或进程 仅在局部商空间 内进行内部演化 ,从而在代数结构上严格保证了多租户之间的无干涉性(Non-Interference)。特别地,当多个用户请求共享同一个容器实例 但所有请求均为只读查询(即 )时,单容器即可无冲突地承载高并发请求;反之,若任意用户请求允许动态修改环境或写入私有文件(),则必须为每个会话分配正交的容器或微虚拟机实例 。
A.2 Docker 镜像的分层合成算子与写时复制(Copy-on-Write)
Docker 镜像(Image)并非一个扁平的巨型压缩包,而是由一系列不可变(Immutable)的只读目录层 通过非交换覆盖算子 构成的有序序列。
对于任意文件路径 ,设层 是一个部分映射(Partial Function)(其中 为文件内容字节流, 为删除标记 whiteout)。两层叠加 定义为“上层覆盖下层”:
- 静态镜像(Image):即只读合成映射 。
- 动态容器(Container):当以镜像 启动第 个容器实例时,内核完全不需要复制底层的 ,只需在最顶层挂载一个初始为空的可写差分层 : 这就是著名的写时复制(Copy-on-Write, CoW):只有当容器 试图修改某个底层文件 时,系统才把 复制到顶层 中进行修改;一旦容器销毁,只需丢弃极小的 ,底层镜像 纤尘不染。
附录 B:工程实战解剖——用 10 行 Dockerfile 打包知识库问答服务
为了直观呈现 Docker 的工程形态,我们以包含 Node.js 运行时与原生二进制检索工具的知识库问答服务为例,拆解如何用一份标准的 Dockerfile 将其封装为可在任何云服务器上秒级启动的容器闭包。
在项目根目录下新建一个名为 Dockerfile 的文件,其全部内容仅需以下几行:
# 第 1 层 (L1):选定地基——直接借用官方打包好的轻量级 Linux (Debian) + Node.js 22 环境
FROM node:22-slim

# 第 2 层 (L2):安装系统级外挂二进制工具——在容器内的 Linux 里安装 ripgrep (rg 命令)
RUN apt-get update && apt-get install -y ripgrep && rm -rf /var/lib/apt/lists/*

# 第 3 层 (L3):设定容器内部的工作目录坐标系
WORKDIR /app

# 第 4 层 (L4):先把依赖清单拷进去并安装第三方库(利用 Docker 分层缓存机制加速构建)
COPY package.json package-lock.json ./
RUN npm ci --omit=dev

# 第 5 层 (L5):把你的业务源码、前端网页和 Markdown 知识库装进盒子
COPY src ./src
COPY public ./public
COPY data/knowledge ./data/knowledge

# 声明盒子对外暴露的网络端口号
EXPOSE 3000

# 规定当盒子被通电启动为“容器”时,默认执行的第一条命令
CMD ["node", "--import", "tsx", "src/server.ts"]
为什么第 4 层要把 package.json 单独拎出来先 COPY,而不是直接和源码一起拷?
这里藏着一个直接应用了附录 A.2 镜像分层定理的经典工程技巧:
- Docker 在构建镜像时是从上往下逐层缓存的:如果某一层的文件内容跟上次相比没有发生任何变化(哈希值一致),Docker 就会直接秒级复用上次建好的层,绝不重新执行。
- 在日常开发中,你几乎每天都会修改
src/里的业务代码,但很少每天去改package.json(新增第三方库)。 - 如果把
COPY package.json放在第 4 层、把COPY src放在第 5 层:当你改了一行代码重新打包时,Docker 发现前 4 层(Linux 底包、ripgrep、npm ci下载的几百兆依赖包)全都未曾改变,会在 0.1 秒内直接跳过前 4 层,只花 1 秒钟重新更新第 5 层源码!这就是数学上的“不变量提取”在软件工程中的直接体现。