本篇导读:在《第一讲》建立起现代云端算力、存储与单 Worker 全栈底座之后,本篇讲义正式进入 AI Agent 系统的架构设计核心。围绕五个层层递进的工程问题,我们将彻底厘清:大模型的推理循环究竟应该放在客户端还是服务端?让人眼花缭乱的 Native Tool、MCP、Skill 与 Plugin 四者如何在架构上咬合?MCP(模型上下文协议)在代码底层是如何用几十行 JSON-RPC 逻辑实现握手与客户端懒加载的?暴露在公网上的远程接口如何通过边缘零信任门禁实现代码级零鉴权负担? 以及在构建内置大脑问答服务时,如何用结构化
Agentic Search取代传统切片 RAG 并消除网络链路上的延迟刺客。
问题一:AI 系统的“大脑”究竟该放哪?—— 两种基本架构范式与混编法则
在动手设计任何与 AI 相关的软件系统时,架构师面临的第一个顶层分野是:大语言模型(LLM)的推理与工具调用循环,究竟应该留在客户端,还是封装进云端服务器?
根据目标用户与交互场景的不同,现代 AI 工程清晰地分化为两种基本架构范式:“外置大脑型(Tool-Server 范式)”与“内置大脑型(Agent-Runtime 范式)”。
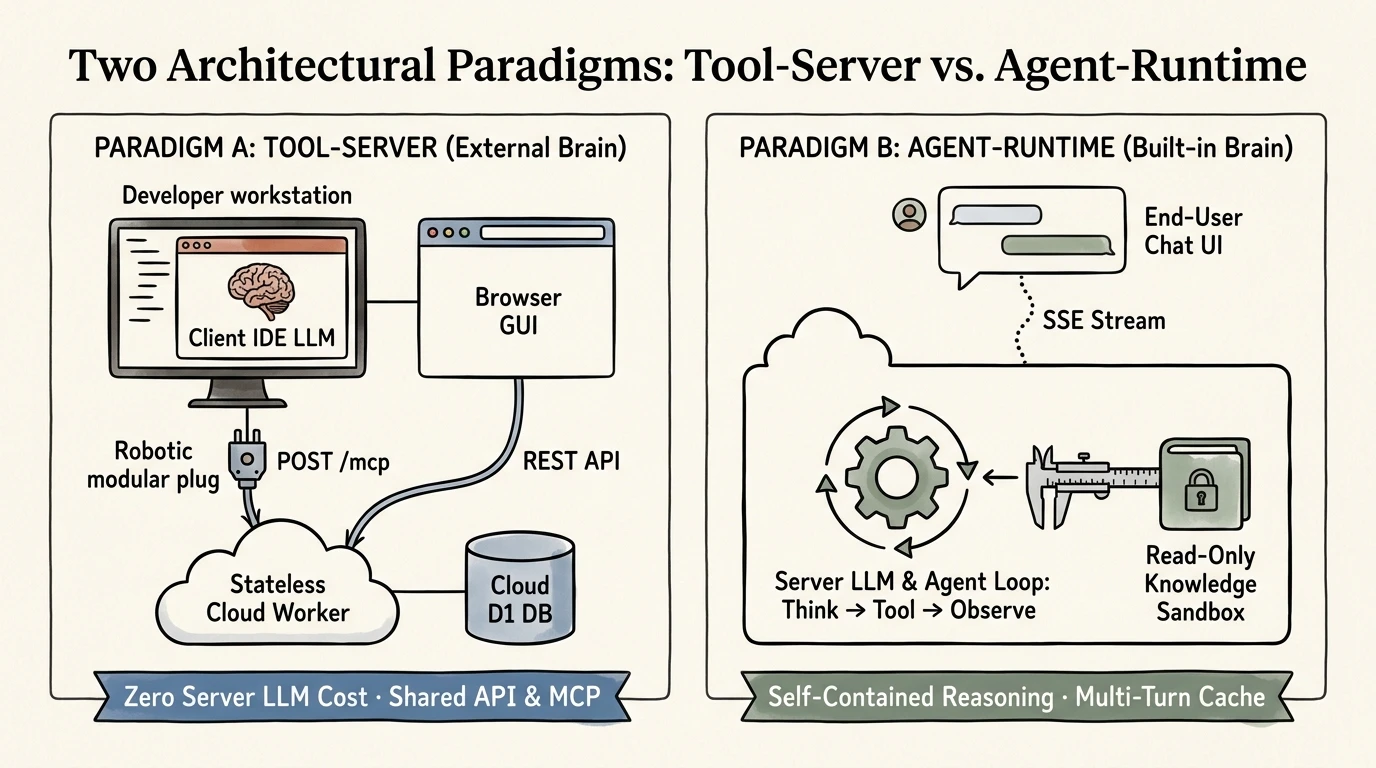 图:AI 系统的两种顶层架构范式对比。左图(
Paradigm A: Tool-Server,外置大脑型):大模型推理留在开发者本地的工作站(Client IDE LLM)中,云端无状态服务(Stateless Cloud Worker)一行调用大模型的代码都不写,仅同时暴露给浏览器看板点按的 REST API 与给 AI 远程调用的 POST /mcp 机械臂插口以读写 Cloud D1 DB,实现服务端大模型零成本(Zero Server LLM Cost);右图(Paradigm B: Agent-Runtime,内置大脑型):面向终端用户(End-User Chat UI)通过 SSE Stream 流式对话,服务端内部封装完整的会话管理与自主推理循环(Think -> Tool -> Observe),并在受控只读路径沙箱(Read-Only Knowledge Sandbox)内精准检索结构化知识库。
1. 外置大脑 vs. 内置大脑的选型边界
| 决策维度 | 范式 A:外置大脑型 (Tool-Server 范式) |
范式 B:内置大脑型 (Agent-Runtime 范式) |
|---|---|---|
| 终端使用者是谁? | 构建者本人或技术团队(日常本就运行着强大的本地 AI IDE / CLI 客户端,并用浏览器查看可视化看板)。 | 外部客户或非技术业务人员(他们本地没有编程 Agent,只能通过网页聊天窗或企微/飞书窗口提问)。 |
| 大模型放在哪里? | 留在客户端 IDE 内。云端服务不持有任何 LLM API Key,纯粹作为“结构化账本管家 + 远程执行机械臂”。 | 封装在云端服务端内部。服务端独立持有模型密钥,自行维护 System Prompt、多轮会话状态与工具调用循环。 |
| 日常交互主通道 | 90% 确定性 GUI 看板 + 10% 自然语言批处理(日常浏览与单条修改直接在网页点按;复杂批量分析才唤起本地 Agent 调 /mcp)。 |
100% 自然语言多轮对话(用户提问千变万化,须由服务端大模型实时理解意图、检索文档并组织回复)。 |
| 服务端 Token 成本 | $0 / 月(云端只跑极轻的 SQL 读写与定时数据同步,推理由本地已订阅的客户端承担)。 | 按实际对客问答量消耗服务端 API Token(需精细设计上下文前缀缓存 Prompt Caching 与并发限流)。 |
[!IMPORTANT] 架构克制原则:不要在每个内部工具里都重复造一个聊天框! 许多开发者在构建数据看板、资产管理或任务系统时,习惯性地在网页角落再手写一个“AI 聊天窗口”,自己去接大模型 API、写流式渲染与历史会话存储。这在个人或内部工具中往往是典型的过度设计——只要让云端后端暴露一个标准的
/mcp端点,你日常使用的主力 Agent 客户端就能瞬间接管这套系统的全部读写能力,既省去了开发聊天 UI 的冗余工作,又直接复用了顶级客户端的推理与多工具协同能力。
2. 服务端编排黄金法则:“外层确定性 Workflow + 内层特种兵 Agent”
即便在需要云端后台自动运转的场景下,成熟的工程系统也极少让一个纯自治 Agent 接管端到端全流程,而是采用“外层确定性工作流(Workflow)+ 内层无头智能体(Headless Agent)”的混编架构:
- 固定流程交给确定性 Workflow(代码硬编码):几点几分由 Cron 定时唤醒、从哪个数据源拉取清单、最终将结构化结果写入哪张数据库表、推送到哪个通知群——这些主干骨架必须是 100% 确定、零 Token 消耗、绝不跑偏的。
- 非标脏活交给内层无头 Agent(受控自治循环):仅在流水线中间遇到非结构化难题(如“抓取多源异构网页并交叉核实某项指标”或“将杂乱文本清洗为标准 JSON Schema”)时,才将该子任务单独交给无头 Agent,在限定步数内完成
思考 -> 调工具 -> 自愈纠错 -> 输出结构化 JSON的收敛循环。
问题二:Native Tool、MCP、Skill 与 Plugin 到底是什么关系?
在构建或扩展 Agent 能力时,工程界最常出现四个高频概念:Native Tool(原生工具)、MCP(模型上下文协议)、Skill(技能包)与 Plugin(插件)。它们并非互相替代的竞品,而是处于四个正交的架构层级,各司其职:
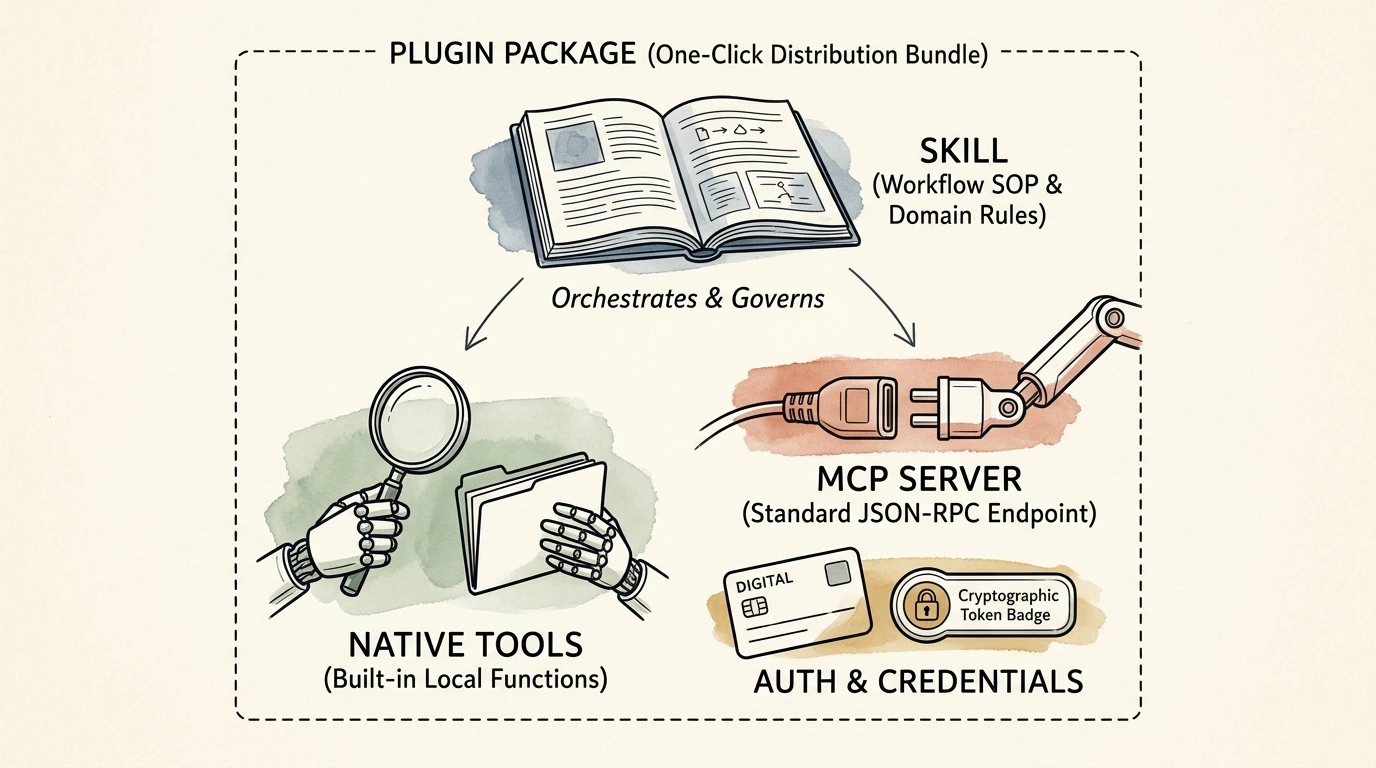 图:AI Agent 能力体系的四层咬合解剖图。最外层虚线框代表一键分发的打包单元
PLUGIN PACKAGE;顶层冷钢蓝模块 SKILL(Workflow SOP & Domain Rules) 是一本打开的标准作业指导书,负责在认知层定义办事流程与判断标准,并向下统筹指挥(Orchestrates & Governs)两类执行手脚:左侧灰绿模块 NATIVE TOOLS 是直接焊死在 Agent 宿主内部的原生机械手(如本地文件读写与极速检索),右侧陶土红模块 MCP SERVER 则是通过标准化插头外接的远程或跨进程工具机械臂;最下方暖金模块 AUTH & CREDENTIALS 为外接服务提供安全令牌与权限凭证。
四层能力组件全景对照表
| 架构层级 | Native Tool(原生工具) | MCP(模型上下文协议) | Skill(技能包) | Plugin(插件套装) |
|---|---|---|---|---|
| 核心隐喻 | 长在躯干上的原生手脚 | USB-C 标准接口的外接机械臂 | 《岗位 SOP 标准作业指导书》 | 《新员工入职工具箱》 |
| 物理形态 | 直接写在 Agent 运行时源码内部的函数(如内置的 ls、grep、read、edit)。 |
独立运行的云端 HTTP 端点(/mcp)或本地后台子进程(stdio)。 |
本地文件夹,核心是一份 Markdown 规范文档(SKILL.md)及配套辅助脚本。 |
市场中的一键安装分发包(内含配置清单、MCP 端点、Skills 与登录器)。 |
| 解决的核心痛点 | 为宿主 Agent 提供延迟最低、控制最严密的底层原生操作能力。 | 跨客户端复用手脚:写一次服务端接口,任何支持 MCP 的客户端插上即用。 | 给大脑立规矩:光有读写数据库的手脚不够,Skill 规定按什么业务口径、分哪几步操作。 | 消灭配置摩擦:免去手动编辑 JSON 配置文件与拷贝目录的繁琐步骤。 |
[!TIP] 工程选型判准:什么时候写
Skill,什么时候写MCP?
- 写
Skill(认知与流程层):当你想让 Agent “学会一套特定的做事流程、审美标准或调用现成命令的步骤”(例如:按统一色板绘制科学手账配图、按固定排版规则发布文章、或按标准模板审查代码)——只需编写一份SKILL.md,零服务端维护成本,改完即刻生效。- 写
MCP(外部状态与手脚层):当你有一套“活在云端或外部系统中的业务数据与状态”(例如:云端 D1 里的业务数据库、企业内部的工单接口、IoT 设备的控制端点),希望任何 Agent 都能按受控参数安全读写它——暴露一个标准的/mcp接口。- 黄金组合(
Skill + MCP联合作战):用 MCP 暴露读写云端数据库的 6 个原子函数(提供手脚),再编写一份薄薄的月度复盘 Skill(提供脑子里的 SOP),指导 Agent 按固定分析框架依次调用这些 MCP 工具并生成结构化报告。
问题三:MCP 协议在代码底层是怎么运作的?—— 握手、无状态降级与懒加载
在概念宣传中,MCP(Model Context Protocol) 常被描绘得颇为神秘;但如果剥离掉厚重的官方 SDK,直接在 Serverless Worker 中手写一个远程 MCP 服务端,你会发现它的核心路由逻辑甚至不需要安装任何第三方依赖,不到 100 行标准代码即可完整跑通。
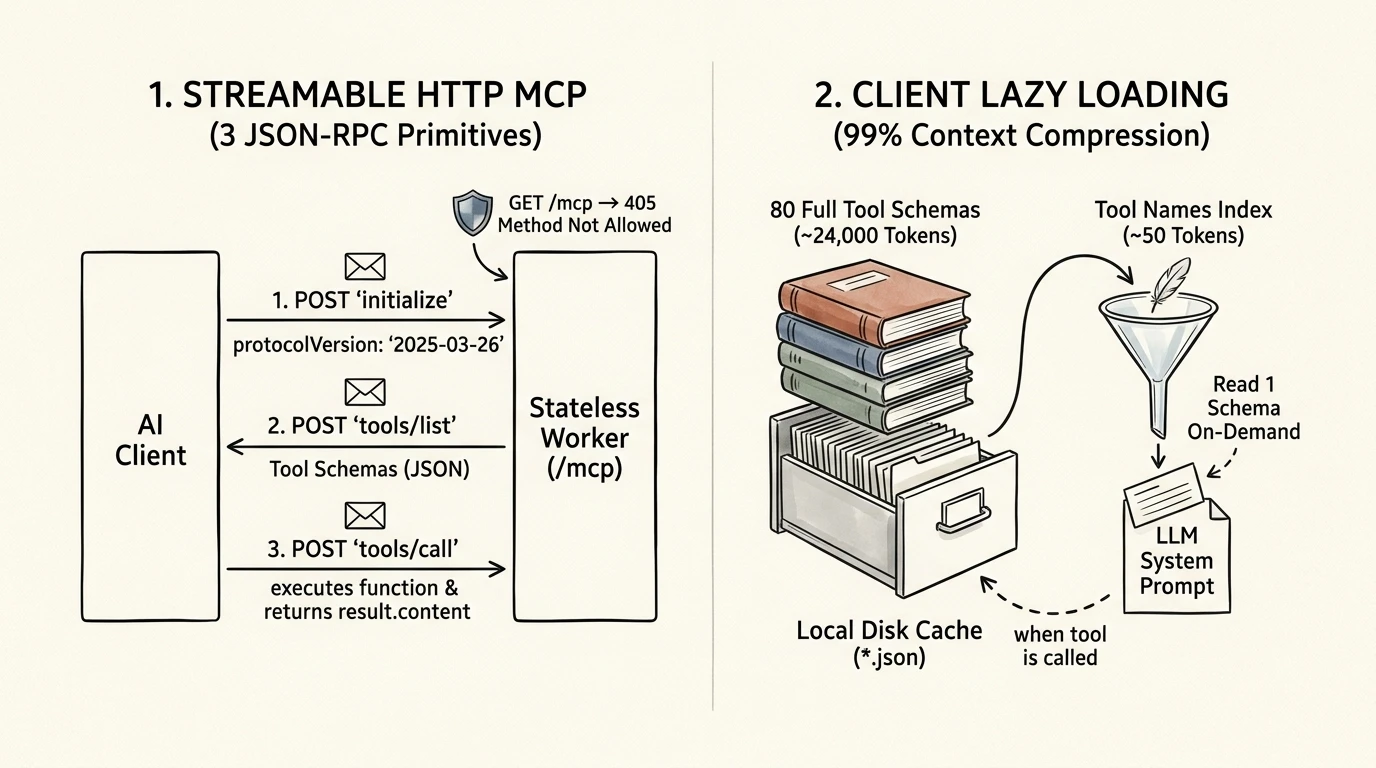 图:MCP 协议底层通信与客户端上下文压缩机制。左栏(
1. STREAMABLE HTTP MCP):展示客户端(AI Client)与无状态服务端(Stateless Worker /mcp)基于 HTTP POST 的三步 JSON-RPC 2.0 标准原语交互(initialize 协商版本 tools/list 拉取工具 Schema 清单 tools/call 执行具体业务函数),顶部盾牌展示对 GET /mcp 返回 405 Method Not Allowed 以触发纯无状态模式;右栏(2. CLIENT LAZY LOADING):展示现代 AI 客户端将拉取回来的 80 个完整工具说明书(~24,000 Tokens)存入本地磁盘缓存(Local Disk Cache *.json),平时仅通过漏斗向 LLM System Prompt 注入 ~50 Tokens 的极简工具名索引,仅在触发调用时按需读取单个 Schema,节省 99% 上下文开销。
1. 协议底牌:把“函数调用”翻译成三句标准的 JSON-RPC 2.0 暗号
在没有 MCP 之前,要让三个不同的 AI 客户端调用你的云端数据库,必须按照各家私有的插件格式写三套适配接口。MCP 的本质极其朴素:规定所有客户端与工具服务端之间,统一通过 HTTP POST 发送遵循 JSON-RPC 2.0 格式的三句标准原语。
以下是一段可直接运行在 Cloudflare Worker(Hono 框架)上的极简远程 MCP 服务端骨架:
// 1. 关键细节:显式拒绝 GET 请求,告知客户端本服务采用纯无状态 POST 模式
app.get('/mcp', (c) => c.text('Method Not Allowed', 405));

// 2. 统一处理 JSON-RPC 2.0 POST 请求
app.post('/mcp', async (c) => {
  const { id, method, params } = await c.req.json();

  // 暗号一:握手亮身份 (initialize)
  if (method === 'initialize') {
    return c.json({
      jsonrpc: '2.0', id,
      result: {
        protocolVersion: '2025-03-26',
        serverInfo: { name: 'cloud-ledger-mcp', version: '1.0.0' },
        capabilities: { tools: {} }
      }
    });
  }

  // 暗号二:索要工具说明书清单 (tools/list)
  if (method === 'tools/list') {
    return c.json({
      jsonrpc: '2.0', id,
      result: {
        tools: [{
          name: 'query_records',
          description: '按条件查询云端数据库中的结构化记录',
          inputSchema: {
            type: 'object',
            properties: { category: { type: 'string' } },
            required: ['category']
          }
        }]
      }
    });
  }

  // 暗号三:点菜执行 (tools/call) —— 直接复用已有的底层数据库函数!
  if (method === 'tools/call') {
    const data = await queryDatabaseRecords(c.env.DB, params.arguments);
    return c.json({
      jsonrpc: '2.0', id,
      result: { content: [{ type: 'text', text: JSON.stringify(data) }] }
    });
  }

  return c.body(null, 202); // 处理 notifications/initialized 等无需回复的通知
});
从上述代码可以直观看到:所谓“把服务打包成 MCP”,根本不需要重写任何业务逻辑。无论是前端网页请求 GET /api/records,还是 AI 客户端通过 POST /mcp 调用 query_records,它们在 Worker 内部调用的都是同一个底层函数 queryDatabaseRecords(c.env.DB, ...),MCP 路由只是在最外层套上了一个不到百行的 JSON-RPC 信封翻译壳。
2. 为什么代码第 1 行专门写了一句 GET /mcp -> 405?—— 协议演进与 Serverless 救星
仔细观察上面代码的第一行:app.get('/mcp', (c) => c.text('Method Not Allowed', 405))。为什么明明只用 POST 通信,却必须给 GET 请求专门写一行返回 405 的代码?这背后对应着 MCP 远程传输协议从第一代向第二代的重大架构演进:
| 协议代际 | 传输机制名称 | 通信方式与对云端架构的要求 | 对 Serverless 架构的影响 |
|---|---|---|---|
| 第一代远程协议 ( 2024-11-05) |
HTTP + SSE (双通道长连接) |
强制要求客户端先发起 GET /sse 建立一条永不断开的服务器推送长连接,再向另一端点发送 POST /messages。 |
Serverless 的噩梦:无状态函数的设计哲学是“毫秒级一问一答后立即销毁”,无法在不同请求间免费维持永久存活的 SSE 管道。 |
| 第二代远程协议 ( 2025-03-26) |
Streamable HTTP (流式单端点) |
统一收敛至单个 /mcp 端点,支持服务端退化为 100% 纯无状态的 HTTP POST 一问一答。 |
Serverless 的救星:客户端连接时会试探性发送 GET /mcp 询问“是否支持长连接主动推送?”;按官方规范,服务端只需明确返回 405 Method Not Allowed,客户端便立即切换为纯无状态 POST 模式! |
如果漏掉了这行显式的 405,试探性的 GET /mcp 请求一旦落入底部静态网页的兜底路由(返回 200 HTML 或 404),严格的 MCP 客户端就会判定协议握手失败而拒绝连接。
3. 本地 Stdio vs. 远程 Streamable HTTP 与客户端懒加载(Lazy Loading)
理解了协议握手后,MCP 在物理部署与客户端调度上的两个关键设计便迎刃而解:
- 两种物理部署形态:
- 本地进程管道(
Stdio):客户端在本地电脑后台悄悄拉起一个 Node.js 或 Python 子进程,通过内存中的标准输入输出(stdin / stdout)收发那三句 JSON-RPC 暗号。适合操作本地文件或本地浏览器,但强依赖本机环境且无法跨设备共享状态。 - 远程无状态端点(
Streamable HTTP):代码与数据 100% 运行在云端 Worker,对外仅暴露一个 HTTPS URL。本地电脑零环境依赖、零常驻进程,任何多端设备填上 URL 即可直接调用。
- 本地进程管道(
- 客户端工具懒加载(
Lazy Tool Loading,见上图右栏): 如果一位开发者挂载了 5 个 MCP 服务、共计 80 个工具,每个工具的 JSON Schema(参数定义与长篇说明)平均占 300 Tokens,全量塞入 System Prompt 将平白消耗 24,000 Tokens! 现代 AI 客户端在启动同步(Boot Sync)时,会将tools/list拉回来的完整 Schema 拆包落盘为本地缓存文件(*.json),平时对话仅向大模型注入一行占~50 Tokens的极简工具名目录;只有当模型在推理中决定需要使用某个具体工具时,才按需读取对应的单个 JSON Schema 并发起tools/call,实现 99% 以上的上下文体积压缩。
问题四:暴露在公网的远程端点如何保障安全?—— 边缘零信任门禁(Edge Zero Trust)
MCP 核心协议只定义了客户端与服务端之间的“对话语法”,协议本身并不内置身份鉴权。一旦将 /mcp 或业务看板部署到公网域名上,如何防止外部爬虫或未授权用户直接调用接口篡改数据?
最优雅的云原生解法不是在业务代码里到处写 if (token !== secret),而是采用 “业务代码与安全门禁彻底解耦(Edge Zero Trust)” 架构。
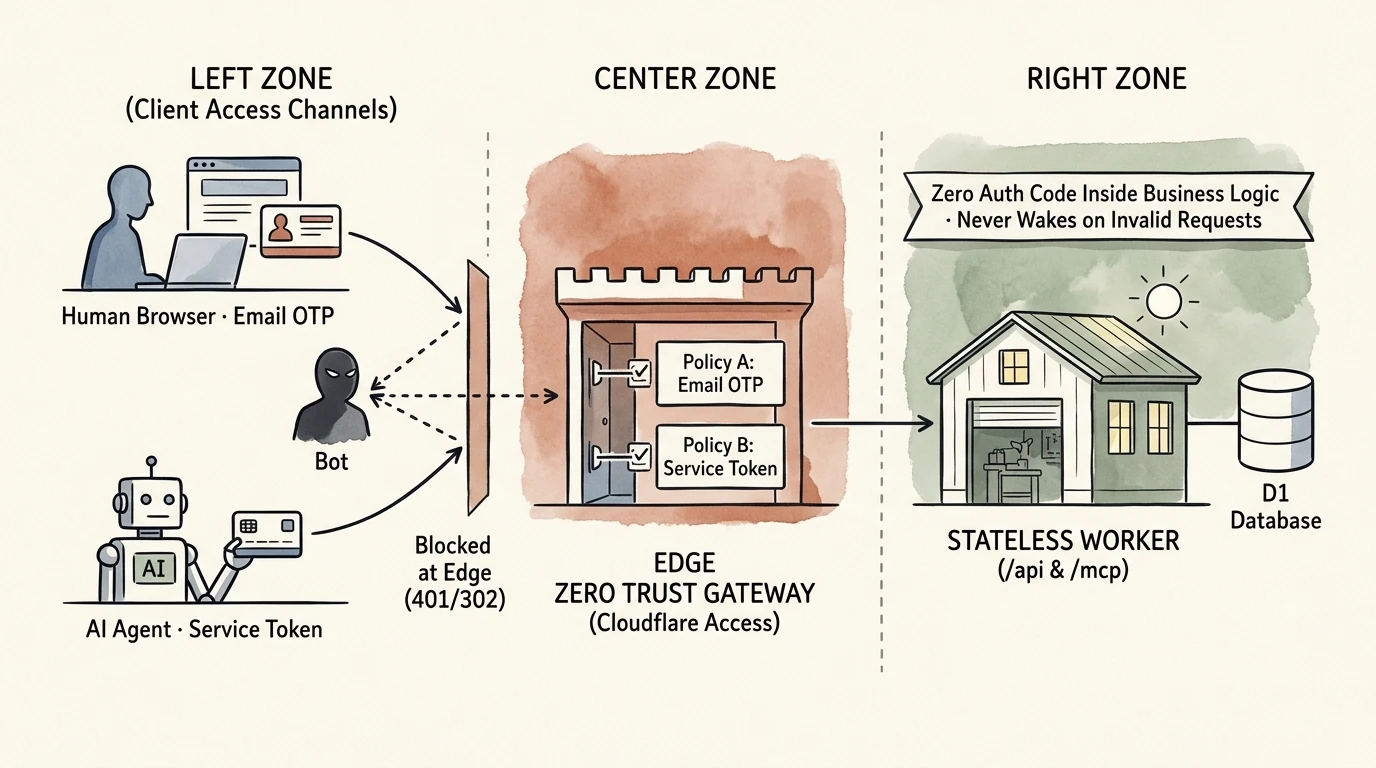 图:边缘零信任(
Edge Zero Trust)安全解耦架构。左侧客户端接入层(LEFT ZONE)包含两条合法通道:人类通过浏览器携带邮箱验证码登录后的 Email OTP 凭证访问看板,AI 客户端携带机器令牌(Service Token)访问 /mcp,而中间的未授权爬虫(Bot)在触及业务代码前即被直接弹回;中间陶土红城门(CENTER ZONE: Cloudflare Access)驻扎在边缘节点门外,按双策略验票,未授权请求直接在边缘层以 401 / 302 拒绝;右侧灰绿工坊(RIGHT ZONE: Stateless Worker)内部保持零鉴权代码(Zero Auth Code),且非法请求绝不会唤醒 Worker 实例消耗算力额度。
1. 为什么把门禁建在“边缘网关”优于写在“业务代码”里?
- 传统应用内鉴权(保安站在自家客厅里):攻击者的恶意请求已经穿透网络、唤醒了你的 Serverless 容器或 Worker(消耗了你的请求配额与 CPU 时间),代码才在第一行检查 Header 并返回
401 Unauthorized。 - 边缘零信任门禁(保安驻扎在小区大门外):利用 Cloudflare Access 等边缘反向代理网关,任何发往该域名的请求在尚未触达 Worker 之前,先在距离用户最近的边缘节点完成验票:
- 人机双轨放行:人类用浏览器打开网页时,触发白名单邮箱一次性验证码(OTP)校验并下发长期加密 Cookie;AI 客户端调用
/mcp时,则在 HTTP 请求头中附带机器专用的CF-Access-Client-Id与CF-Access-Client-Secret(或 Bearer Token)直接静默过闸。 - 零算力消耗与代码纯净:未通过验票的扫描流量直接在边缘节点被拦截,后端的 Worker 甚至不会被唤醒;而进入
src/index.ts的流量则 100% 已验明正身,业务代码无需掺杂任何鉴权模板代码。
- 人机双轨放行:人类用浏览器打开网页时,触发白名单邮箱一次性验证码(OTP)校验并下发长期加密 Cookie;AI 客户端调用
[!NOTE] 适用边界:内部零信任门禁(50 人席位)vs. 面向公众的应用层鉴权
- 个人构建者或 50 人以内团队内部工具:Cloudflare Zero Trust 免费提供 50 个自然人席位(且
Service Token机器调用完全不占席位),直接开启边缘门禁即可零代码获得企业级防护。- 面向公众用户的开放产品:不应使用企业内部闸机,而应在 Worker 内部通过轻量中间件(如 Hono Auth 中间件配合 OAuth / Session Cookie)实现应用层用户鉴权。
2. 远程 MCP 接入鉴权的四种工程模式对比
当本地 AI 客户端需要携带凭证连接受保护的远程 /mcp 端点时,可根据客户端能力与跨设备(Windows + macOS)协同需求,在以下四种模式中做取舍:
| 接入模式 | 核心实现机制 | 核心优势 | 局限与代价 | 适用场景判准 |
|---|---|---|---|---|
| 1. 原生 HTTP Header 直连 (多设备协同首选 ⭐️) |
在本地客户端的 MCP 配置文件(不纳入 Git 提交)中直接配置 url 与 headers(填入 Service Token 或 Bearer Key)。 |
零本地脚本、100% 跨平台:Windows 与 Mac 直接复用同一段 6 行 JSON 配置,无任何本地转发进程。 | 本地私有配置文件中存有静态令牌(在个人独享设备上实际风险极低)。 | 个人或小团队跨设备(Win + Mac)日常主力方案,维护摩擦最小。 |
| 2. 高熵路径/查询密钥直连 (极致兼容兜底) |
针对不支持配置自定义 HTTP Header 的客户端,放行 /mcp/<高熵随机密钥> 路径,由 Worker 校验路径密钥。 |
兼容一切仅提供单个 URL 输入框的客户端(含移动端与网页端连接器)。 | 密钥包含在完整 URL 中,需避免在公开录屏或截图中暴露地址栏。 | 客户端 UI 仅允许填写单个 URL、不支持自定义请求头时的极简破局方案。 |
| 3. 跨平台 Node 环境变量桥接 (旧版 Stdio 客户端兼容) |
使用一个 30 行的纯 Node.js 脚本从系统环境变量读取密钥,将本地 Stdio 管道转发为远端 HTTPS 请求。 |
兼容仅支持本地 Stdio 的老旧客户端,同时保持 Win / Mac 命令一致。 |
本机需安装 Node.js 运行时,且每次调用多一层本地进程转发。 | 必须使用仅支持 Stdio 的旧版桌面客户端且需双系统同步时。 |
| 4. 操作系统硬件级加密桥接 (高敏受控主机专用) |
调用系统原生加密接口(如 Windows DPAPI Export-Clixml 或 macOS Keychain)加密存盘,启动时内存解密并阅后即焚。 |
主机防泄密天花板:磁盘上绝无明文密钥,文件被拷走亦无法在其他机器解密。 | 强绑定单一操作系统,破坏跨平台可移植性,配置链路较重。 | 多人共用的企业跳板机、或合规严禁磁盘出现任何明文凭证的受控终端。 |
问题五:内置大脑如何实现高精度、低延迟问答?—— 结构化 Agentic Search 与延迟拆解
当架构切入第二种范式——内置大脑型(Agent-Runtime,如面向客户或内部坐席的专业知识库问答服务)时,工程上面临的核心挑战立刻变为:如何让大模型做到“回答 100% 忠于严谨文档、绝不张冠李戴”,同时把首字响应时间(TTFT)压进 1 秒以内?
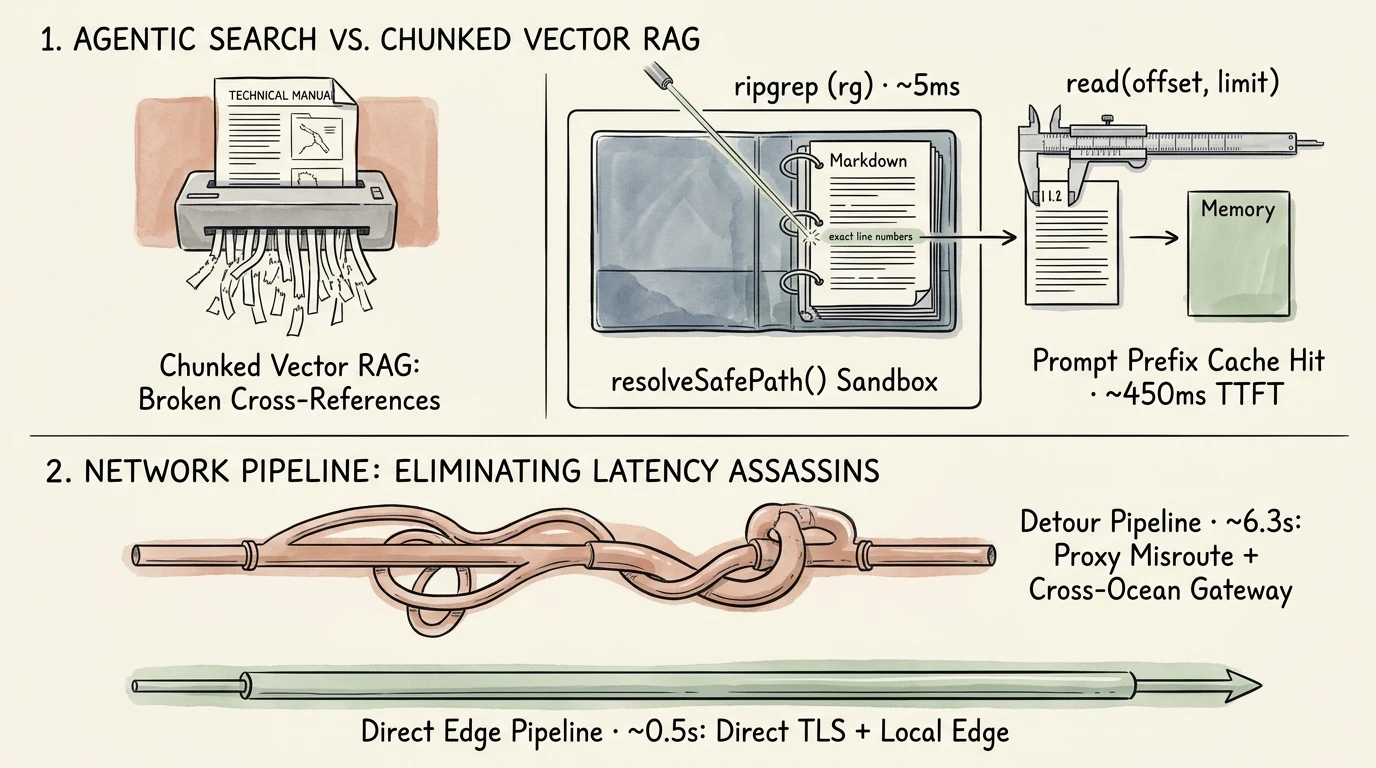 图:内置大脑问答系统的检索范式升级(上)与网络链路延迟拆解(下)。上半部分对比两种检索机制:左侧传统切片向量检索(
Chunked Vector RAG)如同将严谨的技术手册送入碎纸机,极易导致跨段落上下文断裂与型号张冠李戴;右侧 Agentic Search 将结构化 Markdown 手册置于受控只读路径沙箱(resolveSafePath() Sandbox)中,先由 ripgrep (rg) 在 ~5ms 内激光定位精确行号,再用 read(offset, limit) 像游标卡尺一样完整提取对应章节,并在多轮追问中直接命中模型端前缀缓存(Prompt Prefix Cache Hit · ~450ms TTFT)。下半部分对比网络链路:上方陶土红打结管道(Detour Pipeline · ~6.3s)因代理误判与跨洋网关折返导致延迟翻倍,下方灰绿直通管道(Direct Edge Pipeline · ~0.5s)通过本地直连分流、就近边缘接入与监控旁路采集实现极速响应。
1. 为什么在严谨知识库场景下,Agentic Search (grep + read) 能全面超越传统切片 RAG?
过去两年,构建知识库问答的套路往往是搭建一条沉重的切片向量流水线(Chunked Vector RAG):将文档按固定字数切碎 转成 Embedding 向量入库 提问时按余弦相似度捞出 Top-K 碎片拼接回答。
然而,在面对高度结构化的产品说明书、法规条文、排障手册或代码库时,传统切片 RAG 存在两大先天缺陷:
- 碎片化导致的上下文断裂:一份说明书中,“操作步骤”在第 40 行,“注意事项”在第 85 行,“适用型号边界”在章节标题。一旦按 500 字机械切碎,极易丢失前置条件,甚至把 A 型号的参数張冠李戴到 B 型号上。
- 高昂的同步维护成本:源文档每修订一句话,都必须重新触发切片与向量化管道。
对于规模在数万行至百万字以内的结构化文档库,“同构 Markdown 目录树 + 受控只读工具(ls / grep / read)+ 前缀缓存”的 Agentic Search 范式在准确率与工程简洁度上均展现出压倒性优势:
- 应用层只读路径沙箱(
resolveSafePath):服务端不暴露任意命令行(bash),仅提供ls、grep、read三个只读函数,并在入口处强制校验realpath(input) ⊆ KnowledgeRoot,从根源封死../../目录穿越攻击。 - 毫秒级精准定位(
ripgrep)+ 完整章节读取(read):模型先通过 System Prompt 中的极简目录索引定位文件,调用底层基于 Rust 的ripgrep (rg)在1ms ~ 15ms内扫描出关键词所在行号,再用read(offset, limit)完整读取整个逻辑小节,保持 100% 原始语境。 - 多轮会话的前缀缓存红利(Prompt Prefix Caching):首轮读取的完整章节留在会话历史前缀中;当用户在第 2、3 轮围绕该章节继续追问细节时,模型无需再次调用工具,且请求直接命中云端大模型的
cachedTokens(前缀缓存命中),读取成本降低 75%~90%,首字响应时间(TTFT)直接压降至400ms ~ 550ms。
2. 揪出拖慢 Agent 响应速度的三个“隐形延迟刺客”
在实际生产部署中,许多团队发现模型本身推理很快,但端到端体感却动辄卡顿 5~8 秒。通过对 DNS 解析、TLS 握手(tTls)与首字节到达时间(TTFB)进行分段抓包,可以定位并消除三个最常见的架构延迟刺客:
- 刺客一:本地网络代理对
.com域名的误判绕行 许多国产大模型或国内边缘网关同样使用.com顶级域名(如api.deepseek.com)。若本地开发环境或客户端开启了代理规则,极易将其误判为海外站点送入跨国代理隧道,仅 TLS 握手即白白损耗1.5s ~ 2.8s。在路由分流规则中将目标 API 域名显式锁定为DIRECT直连是必做检查项。 - 刺客二:API 中转网关的“跨洋折返放大效应”
若企业内部 API 网关部署在海外核心机房(如 AWS 美东
us-east-1),国内发出的请求需先跨太平洋完成鉴权转发,单次网络往返基底延迟高达2.5s以上。更致命的是,Agent 的一次工具调用包含“模型决定调工具”与“拿到工具结果再生成最终回答”两次串行模型请求,网关的物理延迟会被直接乘以 ()。将网关迁移至就近边缘节点或采用直连端点,可立竿见影削去 70% 以上的等待时间。 - 刺客三:台前回答与幕后遥测(Telemetry)职责耦合
早期设计常在 Prompt 中要求模型在回答末尾额外输出一段
【引用来源与核对依据】,既拖慢了前台流式输出速度,又浪费了高昂的输出 Token。标准的工程解耦做法是:让大模型只管干净利落地输出对客回答;至于“本次命中了哪个文件的哪几行(sources)”、“调用了哪几个工具、各自耗时多少毫秒(steps)”,则完全由后端的会话管理器在工具执行的事件流(Event Stream)中旁路静默采集,通过独立字段异步推送给监控面板。