本篇导读:在《云与 Agent 架构》系列中,我们从宏观视角拆解了操作系统内核、Docker 容器与 V8 沙箱的外部边界。然而一旦推开门走进进程内部,初学者与 AI 工程构建者往往会撞上另一组高频黑话:
CPU 寄存器、栈(Stack)与堆(Heap)、栈溢出与内存泄漏、进程与线程、以及现代 Agent 最核心的底座——单线程异步与事件循环(Event Loop)。若抽离掉琐碎的语法细节,这一整套机制其实只围绕着两个核心数学与物理矛盾展开:第一,在有限且线性的内存地址空间里,如何同时安放“生命周期严格嵌套的临时计算”与“大小和寿命均不可知的动态数据”?第二,当 CPU 的纳秒级计算速度撞上网络 I/O(如等待大模型吐 Token)的秒级龟速时,如何用 1 个线程干出 1000 个并发的吞吐量而不卡死? 本篇作为《计算机底层原理》系列的第一讲,围绕五个递进问题,把一段代码从硬盘通电上内存、到高并发异步调度与 AI Infra 算力喂饭的完整物理过程拆解得清清楚楚。
问题一:代码躺在硬盘里和跑在内存里有什么区别?—— 冯·诺依曼指令流与进程的“四层户型图”
当你写好一份代码文件 agent.js(或 main.py)保存在硬盘上时,它只是一个死的字符串序列,就像一本合上放在书架里的菜谱,自己绝不会炒出一盘菜。
当你敲下回车运行它、操作系统内核为它创建一个进程(Process)时,内核会分给它一套独立的虚拟内存地址空间(你可以把它想象成一套从 0x0000 号房间排到 0xFFFF 号房间的超长单排公寓)。为了不让屋里的东西乱成一团,这套内存公寓从下往上被极其默契地切成了四个功能分区:
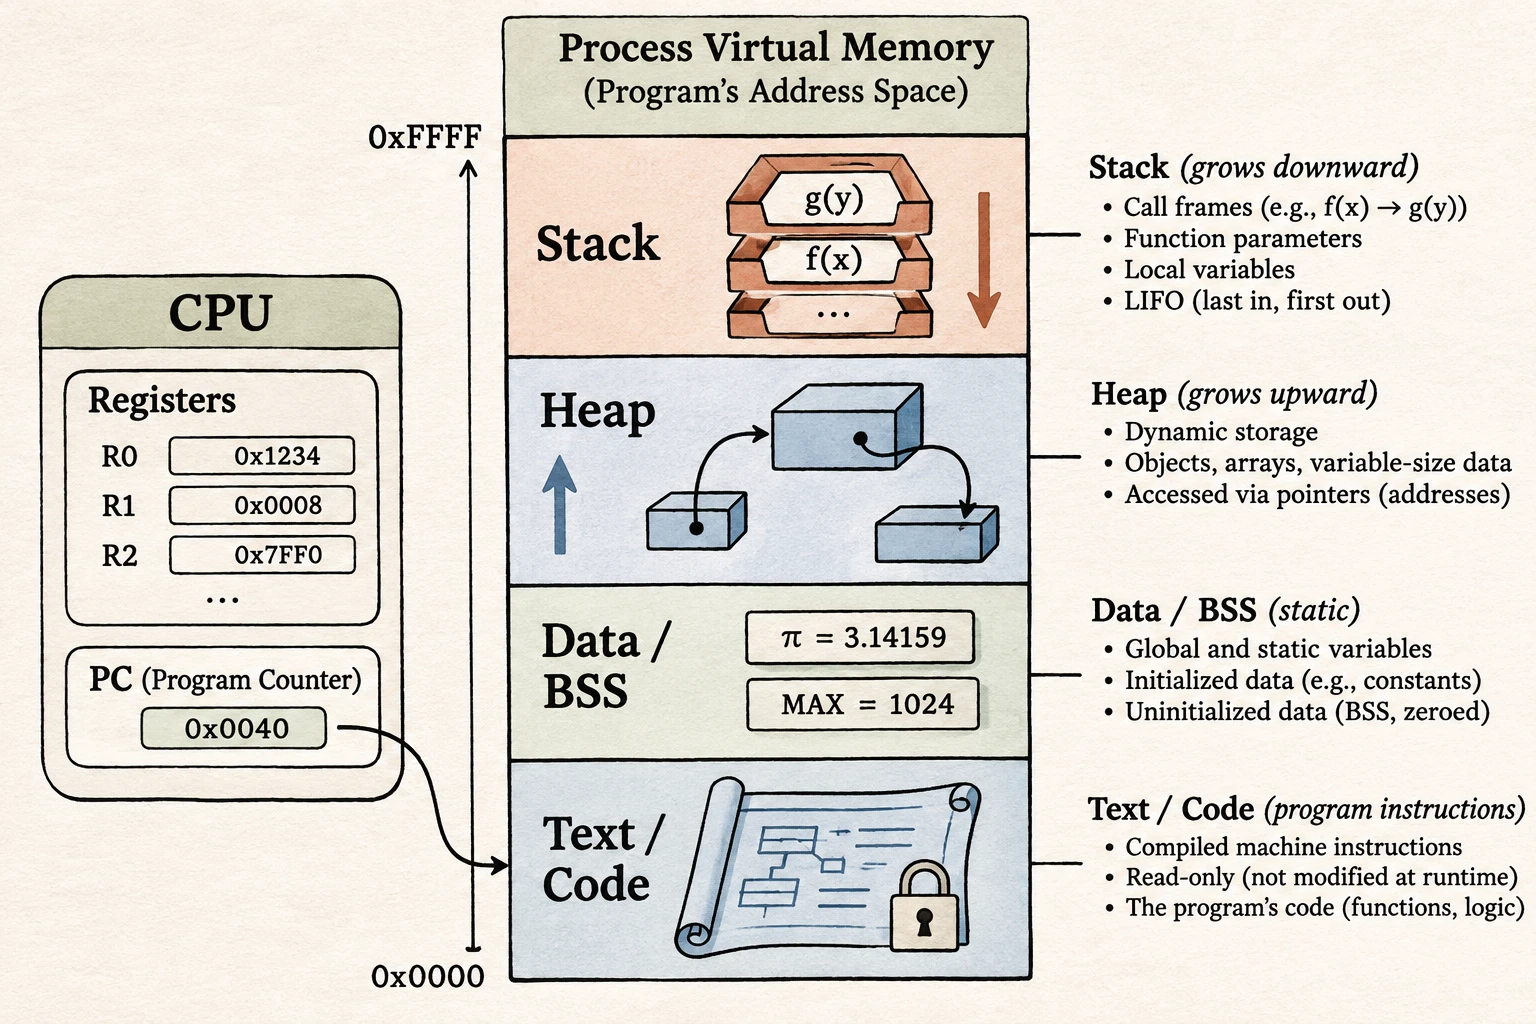 图:冯·诺依曼架构下的 CPU 执行模型与进程虚拟内存“四层户型图”。左侧 CPU 内部由极高速寄存器(Registers)与程序计数器(
PC,指向下一条待执行指令地址的游标)驱动;右侧进程内存从低地址(0x0000)到高地址(0xFFFF)依次划分为:底部的只读指令区(Text / Code)与静态常量区(Data / BSS),以及中间相向生长的两个动态核心区——向上扩张的冷钢蓝动态仓库 Heap(堆),与从顶部向下压入的陶土红函数调用托盘 Stack(栈)。
1. 硬件与内存里的四个核心角色
| 核心部件 / 内存分区 | 工程定义 | 数学直觉映射 | 现实生活隐喻 |
|---|---|---|---|
| CPU 与程序计数器(PC) | CPU 是唯一会做算术与逻辑判断的硅片;内部的 PC(Program Counter) 寄存器存着“下一条要执行的指令在内存里的门牌号”。 | 状态转移算子与时间步游标 | 按菜谱做菜的主厨,手指头(PC)一行行指着当前做到哪一步。 |
| 1. 代码区(Text / Code) | 位于内存最底部,存放编译/加载后的机器指令,权限被锁死为只读(Read-Only)。 | 不可变的算子定义域 (防止程序跑着跑着把自己的代码覆盖了) | 塑封压膜、贴在厨房墙上的只读菜谱。 |
| 2. 全局/静态区(Data / BSS) | 存放全局变量、静态常量(如配置项 MAX_RETRY = 3),程序一启动就分配好,直到进程退出才销毁。 |
全局常值向量 (生命周期与进程全集 等长) | 厨房里固定焊死在墙上的盐罐和油桶。 |
| 3. 栈(Stack) | 位于内存最顶部,向下生长;专门记录当前正在执行哪个函数、传了什么参数、有哪些临时小变量。 | 严格后进先出(LIFO)的树遍历路径栈 | 主厨手边一摞按顺序叠放的“当前备菜小托盘”。 |
| 4. 堆(Heap) | 位于静态区上方,向上生长;专门存放体积大、寿命长、或者运行时才知道有多大的复杂数据对象。 | 动态分配的图节点集合 (通过内存地址指针引用) | 后厨旁边宽敞的“大冷库 / 自由货架”。 |
问题二:为什么内存非要分成「栈(Stack)」和「堆(Heap)」?—— 编译期确定性 vs. 运行期动态性
几乎所有初学计算机的人都会问同一个问题:既然都在内存条里,为什么不把所有变量混在一起随便放,非要大费周章分成「栈(Stack)」和「堆(Heap)」?
答案非常深刻:因为程序里的变量分为截然不同的两类——一类在代码运行前就已经知道大小和寿命(归栈管),另一类必须等代码真正跑起来、收到用户输入后才知道有多大、要活多久(归堆管)。
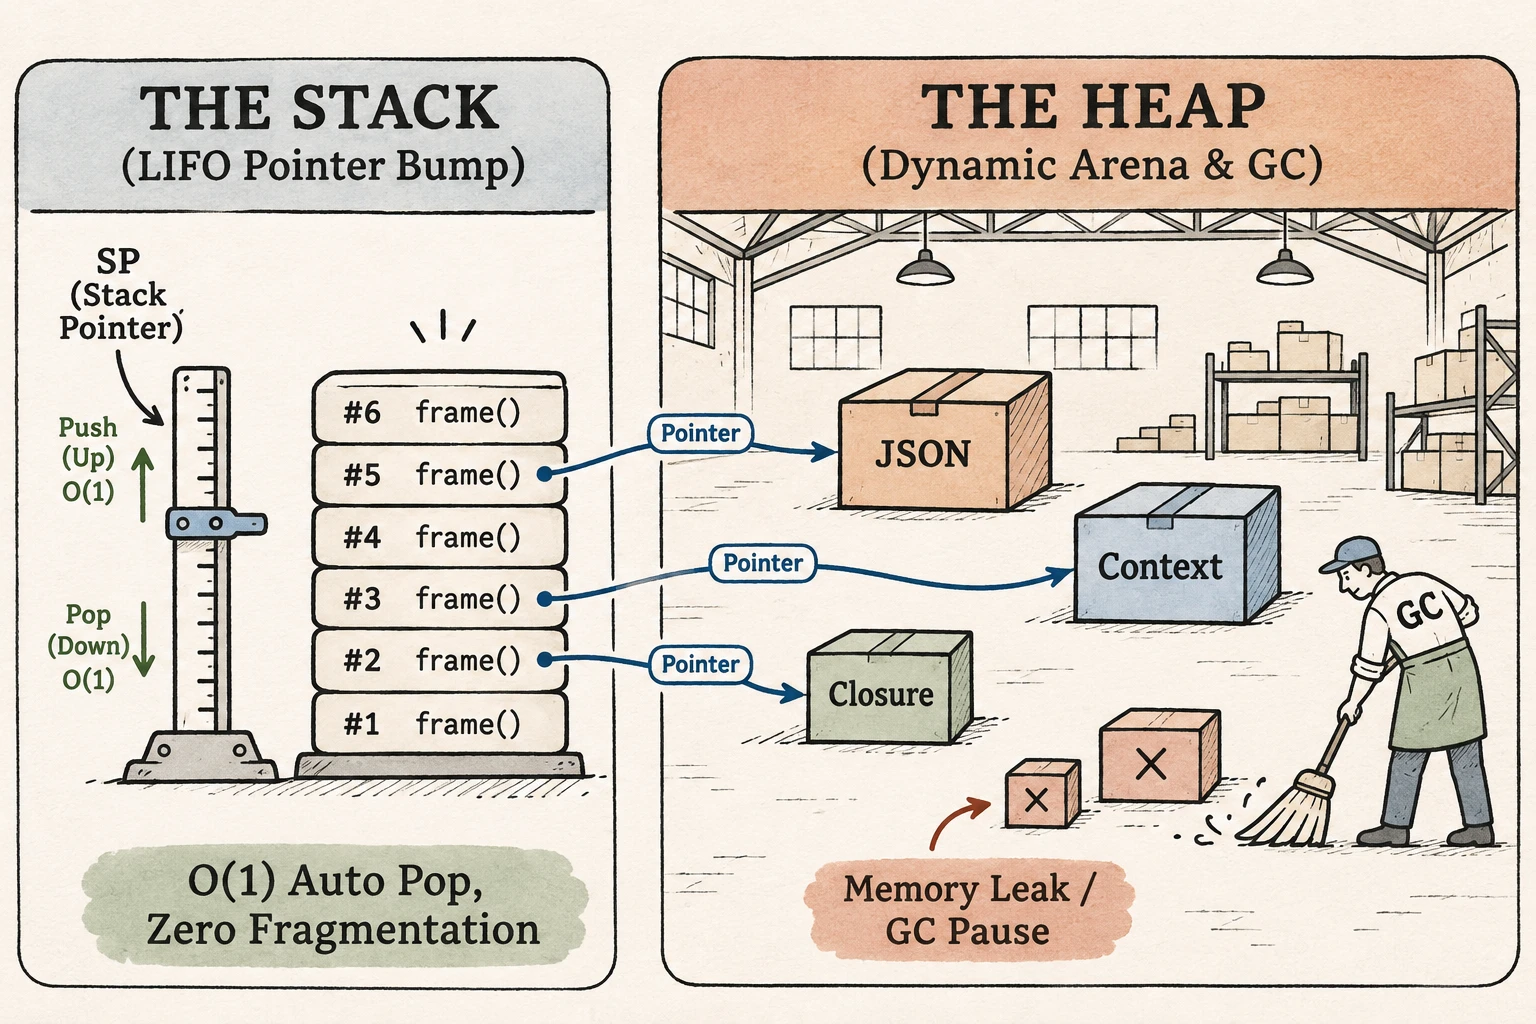 图:内存“栈(The Stack)”与“堆(The Heap)”的运作机制与生命周期对比。左图(The Stack):采用严格的后进先出(LIFO)连续托盘结构,仅需上下拨动单个栈顶指针(
SP)即可在 时间内完成函数栈帧的分配与瞬间销毁,零内存碎片;右图(The Heap):采用开放式仓库结构存放体积可变或跨函数存活的动态对象(如大段 JSON、Agent 对话上下文),栈上仅保存指向堆内存的轻量级地址指针(Pointer),并依赖垃圾回收器(GC)定期清扫失去引用的孤儿对象。
1. 栈(Stack):极致速度的“自动驾驶流水线”
假设你写了两个简单的函数嵌套调用:
function add(a, b) {
  let sum = a + b;
  return sum;
}

function main() {
  let x = 10;
  let y = add(x, 20);
}
当 CPU 执行 main() 时,它在栈顶压入一个属于 main 的托盘(叫栈帧 Stack Frame),里面装着变量 x = 10;接着调用 add(10, 20),CPU 直接在 main 托盘上面再叠一个属于 add 的新托盘,装着 a = 10, b = 20, sum = 30。
最奇妙的事情发生在 add 函数执行完 return sum 的那一瞬间:
- 因为函数调用严格满足“后进先出(Last-In, First-Out)”——后被调用的内层函数,一定比外层函数先结束!
- 所以当
add结束时,系统根本不需要去擦除内存里的数据,只需要把栈顶指针(Stack Pointer,SP)往上拨一格,宣告上面那个托盘作废即可!下次调用别的函数时,直接覆盖这块位置。 - 数学代价:分配和释放内存的时间复杂度是绝对的 (只需一条 CPU 指针加减指令,耗时不到 1 纳秒),而且永远不会产生任何内存碎片!
[!WARNING] 顺手扫盲 1:到底什么是“栈溢出(Stack Overflow)”? 因为栈追求极致的连续与高速,操作系统分给每个线程的栈空间通常很小(比如只有
1MB ~ 8MB)。如果你写了一个没有终止条件的死递归函数function f() { return f(); },CPU 就会以每秒几百万次的速度往栈上叠新托盘,不到 0.01 秒就会把这8MB的天花板撞穿——这就是鼎鼎大名的Stack Overflow(栈溢出崩溃)。
2. 堆(Heap):灵活但需要人打扫的“自由大仓库”
既然栈这么快,为什么不能把所有东西都放栈上?因为栈有两个死穴:
- 大小必须在编译时固定:比如一个 64 位整数固定占 8 个字节。但如果你在写一个 Agent,要去读取用户上传的一篇文档、或者接收大模型返回的 JSON,在代码跑起来之前,谁知道这篇文档是 100 个字还是 10 万个字? 大小不确定,根本没法做固定规格的栈托盘。
- 寿命不能超过当前函数:栈上的变量一旦函数
return就原地灰飞烟灭了。但 Agent 的多轮对话历史(Session History)需要跨越无数次函数调用一直存活在内存里。
于是,堆(Heap) 登场了:
- 当你写下
let history = [{ role: "user", content: "..." }]时,系统会在宽敞的堆(Heap)仓库里找一块空地,把这团大小可变的复杂对象存进去(假设存放在仓库门牌号0x8F00); - 然后,在当前函数的栈(Stack)托盘上,只放一张固定 8 字节的小纸条(叫指针 Pointer / 引用 Reference),纸条上写着:
history -> 见仓库 0x8F00 号。 - 这样一来,无论堆里的 JSON 长到 100MB 还是缩成空数组,栈上的指针永远只有整齐的 8 字节!函数传参时也不用搬运 100MB 的货物,只需复印那张 8 字节的小纸条即可。
[!TIP] 顺手扫盲 2:到底什么是“垃圾回收(GC)”与“内存泄漏(Memory Leak)”? 货物放进堆仓库后,函数结束了,栈上的小纸条(指针)被销毁了,但堆仓库里的真货物还在!
- 在 C / C++ 里,程序员必须自己写代码
free()去仓库退租;忘写就会把内存撑爆,写早了又会出现指向空地的“野指针”。- 在 Python / JavaScript / Go / Java 里,语言运行时配了一个自动保洁阿姨——垃圾回收器(Garbage Collector, GC)。她每隔一会儿就顺着栈上的小纸条去堆仓库里点名:凡是还有小纸条指着的货物就留着;凡是没有任何小纸条指向的“孤儿货物”,就自动清扫回收。
- 那为什么自动 GC 的语言还会“内存泄漏(Memory Leak)”? 因为如果你在代码顶层搞了一个全局数组
const globalCache = [],每次用户对话都往里塞数据却忘了清理旧数据——当保洁阿姨来检查时,发现globalCache这张总纸条一直指着所有旧数据,她以为你还要用,永远不敢收走!久而久之,堆仓库被塞满,服务直接OOM(Out of Memory,内存耗尽被内核强杀)。
问题三:进程、线程与 CPU 核心到底是什么关系?—— 并发(Concurrency)与并行(Parallelism)
搞懂了单个程序在内存里的长相,接下来我们把视野拉大:一台电脑既有多个程序在跑,每个程序内部又想同时干好几件事。这里最容易混淆的三个词是:CPU 核心(Core)、进程(Process)、线程(Thread)。
用“开餐馆”来打个比方,三秒钟就能彻底分清:
| 概念 | 餐馆隐喻 | 计算机真实物理机制 | 隔离性与通信成本 |
|---|---|---|---|
| 进程(Process) | 一间独立的餐馆门店(有自己独立的后厨、账本、冷库) | 操作系统分配资源的最小单位,拥有完全独立的虚拟内存空间(独立的栈 + 独立的堆)。 | 绝对隔离。A 餐馆着火不会烧掉 B 餐馆;但两家店想借颗葱(进程间通信 IPC),必须打外部电话或走快递。 |
| 线程(Thread) | 同一家餐馆后厨里的多个厨师 | CPU 调度的最小执行单位。同一个进程里的多个线程共享同一个堆(Heap)和全局变量,但每个线程有自己独立的小栈(Stack)和 PC 游标。 | 零距离共享,但极易撞车。厨师 A 和厨师 B 转身就能拿同一个冷库(堆)里的肉,但如果两人同时去改同一本账单,不加锁(Lock/Mutex)就会把账算乱(竞态条件 Race Condition)。 |
| CPU 核心(Core) | 后厨里真正能点火炒菜的煤气灶头 | 物理芯片上的真实运算单元(如 8 核 CPU 就有 8 个物理运算阵列)。 | 物理上限:同一纳秒内,8 个灶头最多只能有 8 个厨师真正在同时炒菜。 |
1. 顺手厘清 1:并发(Concurrency) 并行(Parallelism)
- 并行(Parallelism,物理同时):后厨有 4 个灶头(4 核 CPU),4 个厨师同时在 4 个灶头上炒 4 盘菜。这是靠硬件堆出来的真同时。
- 并发(Concurrency,逻辑交错):后厨只有 1 个灶头(单核),但接了 10 桌客人的单。厨师先把第 1 桌的汤炖上(趁水还没开的空档),立刻转身切第 2 桌的菜,再给第 3 桌的鱼翻个面……在食客看来,10 桌菜都在同时推进。并发不是物理上的同时执行,而是对“等待时间”的极致穿插利用!
2. 顺手厘清 2:为什么计算机世界里到处都叫 Worker(PyTorch num_workers、Cloudflare Workers、浏览器 Web Worker)?
在阅读各类技术文档时,你会高频撞见 Worker(打工人) 这个词。它绝非巧合,而是计算机架构中最经典的分工母题——「Master-Worker(包工头—打工人)」模式的通用代号。
无论处于哪一层技术栈,只要一个组件被命名为 Worker,就意味着它具备三个共同的架构特征:① 不掌管全局调度,只找主节点(Master / Main / Gateway)领具体任务干活;② 无状态或弱状态,可以像流水线工人一样水平复制(从 1 个扩到 1,000 个);③ 它的底层物理形态取决于所在的技术层级:
技术场景中的 Worker |
它的“包工头(Master)”是谁? | 它在底层物理上到底是什么? | 为什么在这个场景下需要它? |
|---|---|---|---|
PyTorch DataLoader(num_workers=16) |
负责模型训练循环的 Python 主进程 | 16 个独立的操作系统进程(Process) | Python 存在全局解释器锁(GIL),多线程无法并行榨干多核 CPU;必须开 16 个独立进程在后台并行解码图片、切分数据喂给 GPU。 |
浏览器 Web Worker / Node worker_threads |
负责 UI 渲染或事件循环的唯一主线程 | 同一进程内的后台子线程(Thread) | 主线程一旦算重活就会导致网页掉帧或服务假死;因此把加密、压缩等纯 CPU 苦力活丢给后台子线程 Worker 算,算完发消息通知主线程。 |
Cloudflare Workers |
Cloudflare 全球边缘路由网关 | V8 引擎内的微沙箱实例(V8 Isolate) | 沿用 Web Worker 的开发者体验,在边缘节点花 2 毫秒切出一个即用即走的轻量级代码执行工位,处理完 HTTP 请求即刻休眠。 |
Kubernetes Worker Node |
K8s 集群控制平面(Control Plane) | 一整台物理服务器或云虚拟机 | 在分布式集群维度,主控节点只负责排班发令,底下成百上千台真正运行 Docker 容器干活的机器统称为 Worker 节点。 |
问题四:为什么 Node.js / Worker 只有一个主线程,却能同时挂几百个大模型请求?—— 异步与事件循环(Event Loop)
这是整个现代 Web 与 AI Agent 工程(包括你每天用的 DSH、Cloudflare Workers、FastAPI async/await)最核心的底层魔法。
1. 先算一笔物理账:CPU 眼里的世界有多慢?
在人类眼里,等待大模型 API 响应 1 秒钟 很快;但在每秒跳动 30 亿次的 CPU 眼里,这 1 秒钟漫长得像一场冰河世纪。 如果我们把 CPU 执行一条寄存器指令(约 0.3 纳秒)放大为人类世界的「1 秒钟」,那么计算机里其他操作的耗时对比如下:
| 计算机动作 | 真实物理耗时 | 放大为人类体感时间(CPU 1 纳秒 秒) | 架构直觉 |
|---|---|---|---|
| CPU 寄存器 / 栈顶读写 | 1 秒(眨一下眼) | 就在手边,随拿随用 | |
| 物理内存条(RAM / 堆)读写 | 5 分钟(下楼买杯咖啡) | 稍微走两步,但还能接受 | |
| 固态硬盘(SSD)读取文件 | 3.5 天(出差去趟外地) | 开始进入慢速 I/O 区! | |
| 跨洋网络请求(发包到美国机房) | 14 年(从小学读到大学毕业) | CPU 如果原地傻等,等于坐牢 14 年 | |
| 等待 LLM 大模型生成完整回复 | 约 300 年(从清朝雍正年间等到今天!) | 极端 I/O 密集型场景! |
看到这张表,你就瞬间明白了为什么 AI Agent 是人类历史上最极端的“I/O 等待密集型(I/O-Bound)”应用: 当你的 Agent 服务跑起来时,99.99% 的时间 CPU 根本没在做复杂的数学运算,而是在干等大模型 API 吐字、干等数据库返回结果、干等硬盘读文件!
2. 传统多线程 vs. 单线程事件循环(Event Loop)
面对这“长达 300 年”的网络等待,工程师们发明了两套截然不同的架构流派:
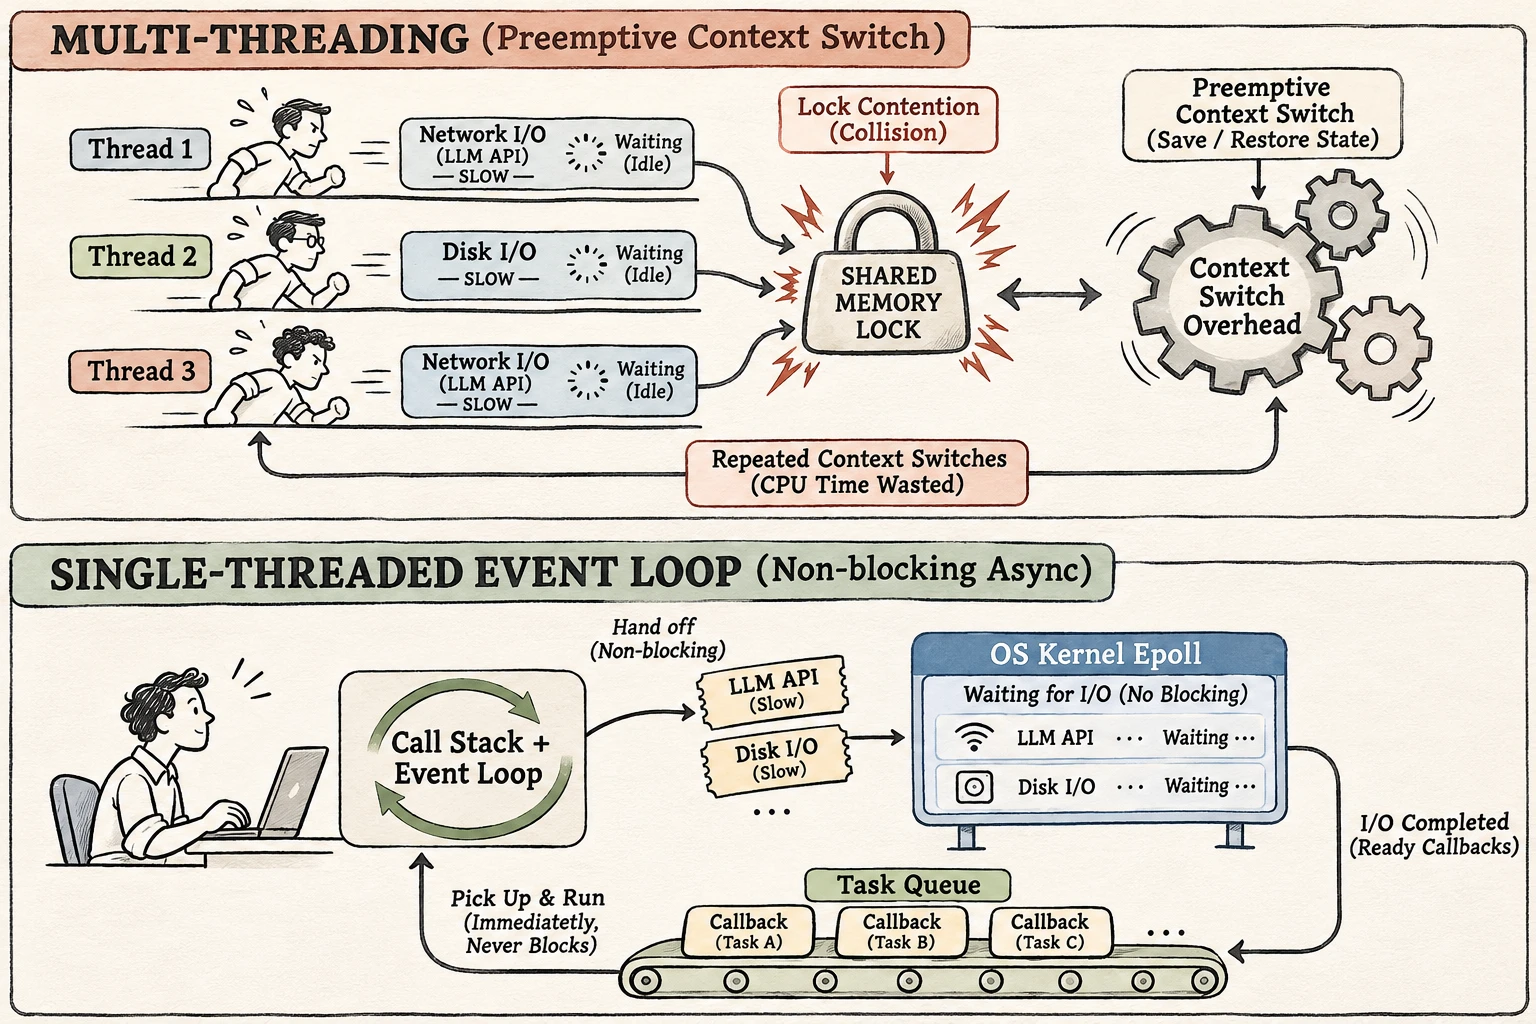 图:传统多线程阻塞模型(上)与单线程异步事件循环模型(下)的机制对比。上图(Multi-Threading):为每个并发请求分配独立操作系统线程,不仅每个线程需消耗数 MB 栈内存,且在等待慢速网络 I/O 时大量线程挂起切换,并在读写共享内存时引发激烈的锁竞争(红色火花);下图(Single-Threaded Event Loop):仅用唯一一个主线程运行调用栈(
Call Stack),遇到慢速 LLM API 或磁盘读写时,立即将等待任务卸载给操作系统内核级多路复用器(OS Kernel epoll / kqueue),主线程零阻塞地继续处理后续请求,待内核通知 I/O 完成后再从任务队列(Task Queue)按序取回回调执行。
- 老派做法:多线程阻塞模型(One Thread per Request,如早期 Java / Apache)
- 做法:每来一个用户请求,就招一个新服务员(新建一个操作系统线程),专门陪着这个用户等大模型回话。大模型 3 秒不说话,这个服务员就原地发呆傻站 3 秒。
- 代价:如果有 5000 个用户同时在线,你就得招 5000 个服务员。光发工服(每个线程默认分配 2MB 栈内存)就要吃掉
10GB 内存;而且操作系统在 5000 个线程之间来回切换上下文(Context Switch),CPU 光点名就累趴下了,还要处理极其头疼的多线程抢锁 Bug。
- 现代 Agent 主流做法:单线程异步 + 事件循环(Event Loop,如 Node.js / Cloudflare Workers / Python
asyncio)- 做法:整间餐厅大堂里自始至终只有 1 个金牌服务员(单主线程)!
- 他是怎么做到同时服务 5000 桌客人的?
- 第 1 桌客人点单:“帮我问一下 DeepSeek 这个问题”(代码中遇到
await fetch(llm_url)); - 金牌服务员绝不在桌边傻等!他花 0.001 秒写了一张小纸条(Promise 挂起状态 + 回调函数),顺手把“盯着网卡看 DeepSeek 回没回信”这个苦差事直接甩给了餐厅地底下的操作系统内核总管(Linux
epoll/ macOSkqueue); - 甩手之后,当前函数的栈帧暂停存档,金牌服务员立刻转身去招呼第 2 桌、第 3 桌……第 5000 桌客人!
- 3 秒钟后,地底下的操作系统内核发现网卡收到了第 1 桌的 DeepSeek 回复,就把第 1 桌的小纸条塞进吧台的「已完成任务队列(Task Queue / Microtask Queue)」里;
- 金牌服务员只要手里没活(当前调用栈
Call Stack为空),就会不知疲倦地去吧台队列里拿下一张小纸条,恢复第 1 桌的上下文,把大模型的结果发给客人——这个“检查调用栈为空 从队列取一张已完成任务执行 再检查队列”的无限循环,就叫做 事件循环(Event Loop)!
- 第 1 桌客人点单:“帮我问一下 DeepSeek 这个问题”(代码中遇到
[!IMPORTANT] 一句人话捅破
async / await的窗户纸: 当你在代码里写下const res = await fetch(...)时,表面上看代码像是“停在这一行等结果”,但实际上:await的真正意思是“让出(Yield)主线程”! 它在告诉那个唯一的金牌服务员:“嘿,后面是个要等好几秒的网络慢活儿,你先把我这个函数的进度存到堆(Heap)里,赶紧去干别人的活吧!等网络数据回来了,再从await下一行把我唤醒继续跑。”
3. 物理坐标定位:这个“事件循环”到底跑在服务端还是我自己的电脑上?是谁的 CPU 在调度?
初学者看到这里最容易产生一个空间错觉:“这个上蹿下跳的金牌服务员(事件循环),到底是在我自己的电脑里跑,还是在远端服务器里跑?”
答案只有一句话:代码部署在哪台机器上,就是哪台机器的 CPU 和操作系统内核在跑这套事件循环。 事实上,在一次完整的 AI Agent 对话链路中,往往有三台物理机器上的“三个金牌服务员”在接力跑各自的事件循环:
| 物理位置(谁的机器?) | 谁的 CPU 在调度事件循环? | 典型运行程序 | 这个位置的“事件循环”具体在等什么、忙什么? |
|---|---|---|---|
| 1. 客户端 / 本地宿主侧 (你面前的 Mac / PC) |
你本机的 CPU (配合 macOS kqueue 或 Win IOCP) |
本地桌面 Agent(如 DSH、Claude Code CLI)或浏览器前端 | 当你在本地 Agent 里同时发起 3 个工具调用(如并行生成 3 张图、同时向远端大模型发请求)时,你本机的 Node.js 事件循环负责把 3 个请求异步发出去并让出主线程,因此在漫长的 20 秒等待期内,你本机 CPU 占用率几乎为 0%,电脑丝毫不卡。 |
| 2. Agent 服务端 / 网关层 (云端服务器 / 公司内网主机) |
Cloudflare 边缘服务器或公司内网服务器的 CPU (配合 Linux epoll) |
Web 版 Agent 后端服务(如客服问答后端、MCP 远程网关) | 本节的核心主角! 当 500 个员工同时在网页上向客服 Agent 提问时,服务端这 1 个 Node.js / Worker 进程靠事件循环同时挂起 500 个会话:趁着帮员工 A 等大模型回复的 3 秒空档,转身帮员工 B 查数据库、帮员工 C 拼装 Prompt。 |
| 3. 远端大模型推理机房 (DeepSeek / OpenAI 机房) |
GPU 服务器宿主机上的 CPU | 大模型推理框架前端(如 vLLM / SGLang 的 Python asyncio 服务) |
接住全球成千上万个 Agent 服务端发来的 HTTP 请求,用异步事件循环将不同用户的 Token 请求动态拼成一锅(Continuous Batching),再通过 PCIe 喂给旁边的 H100 GPU 计算。 |
问题五:全景排障直觉 —— 既然单线程异步这么神,它的死穴在哪里?
理解了“整间餐厅只有 1 个金牌服务员(单线程事件循环)”之后,你在写 Agent 或后端服务时,就能瞬间想通两个最经典的工程事故,并打通上层应用与底层 AI Infra 的认知闭环:
1. 为什么在异步服务里写死循环或算重活,会让所有用户一起卡死?
- 事故现场:你在 Node.js 或 Worker 里处理用户 A 的请求时,没有用异步 I/O,而是写了一个纯 CPU 硬算的循环(比如用正则表达式在一个 50MB 的奇葩文本里疯狂回溯匹配,或者同步算一个巨大的矩阵乘法,耗时 5 秒)。
- 物理后果:在这整整 5 秒钟里,那个唯一的金牌服务员一直在厨房里埋头切土豆丝,根本抽不出手回吧台看「已完成队列」!
- 表象:哪怕用户 B、用户 C 只是发了一个最简单的健康检查请求,甚至他们的大模型回复早就已经到达网卡、躺在了吧台队列里,也没有任何人去拿出来发给他们。整台服务器表现为“全员假死 5 秒”——这就是工程上常说的 “阻塞事件循环(Blocking the Event Loop)”。
2. CPU 密集型 vs. I/O 密集型:一张表定生死
| 任务类型 | 物理特征 | 典型 AI / 工程场景 | 最佳架构选型 |
|---|---|---|---|
| I/O 密集型(I/O-Bound) | 99% 时间在等网络、等磁盘、等数据库;CPU 每次只需花几微秒拼装一下 JSON。 | AI Agent 编排调度、网关路由、MCP 服务端、Web 看板、流式转发。 | 单线程异步事件循环(Node.js / Cloudflare Workers / Python asyncio):省内存、无锁竞争、轻松扛上万并发等待。 |
| CPU 密集型(CPU-Bound) | 不等外部网络,CPU 必须一刻不停地满负荷做算术运算。 | 本地跑大模型矩阵乘法推理、视频转码压缩、大规模数据加密哈希、复杂图像渲染。 | 多进程 / 多线程并行 + GPU 卸载(Rust / C++ / Python multiprocessing / Worker Threads):必须把重活拆给多个物理灶头(多核 CPU/GPU),绝不能霸占事件循环主线程。 |
3. 灵魂追问:怎样才能让 CPU 跑满?为什么在 AI Infra 里又常听说“GPU 在干等 CPU 调度”?
读到这里,一个极自然的反问是:既然写 Agent 时 CPU 99.9% 的时间都在闲着等网络,那什么情况下 CPU 会被 100% 跑满?为什么到了大模型训练/推理机房里,大家又反过来抱怨“CPU 太慢,害得 GPU 在干等 CPU”?
这恰恰捅破了「上层应用工程(Agent)」与「底层算力基建(AI Infra)」的视角转换窗户纸——一切取决于谁是当前流水线上最慢的瓶颈:
- 怎么把 CPU 真正 100% 喂饱?
只要砍掉一切外部 I/O 等待(数据已经全在内存里),让 CPU 核一刻不停地做纯算术或逻辑指令,同时开启与物理核心数相等的线程/进程(例如 8 核机器开 8 个工作进程),CPU 就会瞬间飙到 100%。典型场景包括:一次性
JSON.parse数百 MB 的巨型文本、用复杂正则表达式全量扫描知识库、做图像/视频编解码、加密哈希计算,以及为 GPU 准备训练数据的预处理流水线。 - 为什么到了大模型底层,反过来变成了“GPU 在等 CPU 调度”?
因为 GPU 是一个“算矩阵快如闪电、但毫无生活自理能力的偏科巨兽”。我们可以把 CPU 比作 「1 个全能包工头」,把 GPU 比作 「10,000 个只懂同时挥铲子的壮汉」。GPU 自己不能跑操作系统内核、不能直接读硬盘文件、甚至不知道下一步该算哪一层网络,所有指令和数据都得靠 CPU 喂给它。这就导致了两个经典的“GPU 等 CPU”现场:
- 算子发射墙(Kernel Launch Overhead):大模型推理一步要拆成几百个小算子(矩阵乘、
LayerNorm、Softmax等)。CPU 跑着慢吞吞的 Python(PyTorch),每翻译并派发一道指令要花10 微秒,而 GPU 上的上万个核心齐刷刷一铲子下去,2 微秒就算完了!结果 GPU 每干 2 微秒的活,就要拄着铲子干等 CPU 喊下一句口令等 8 微秒(所以底层推理引擎才引入 CUDA Graph,把几百步口令提前录成一张总图纸一次性塞给 GPU,省去 CPU 逐句喊话)。 - 洗菜切菜跟不上炒菜(Data Loading Starvation):在训练多模态或大模型时,CPU 负责从硬盘读图、解码 JPEG、做分词(Tokenize),再通过主板 PCIe 总线搬运到 GPU 显存。往往 H100 GPU 花 10 毫秒就把一锅菜炒完了,而本机 CPU 所有核心 100% 满负荷运转去解码图片、切分词,还是供不上 GPU 的吞吐胃口。
- 算子发射墙(Kernel Launch Overhead):大模型推理一步要拆成几百个小算子(矩阵乘、
[!TIP] 一张全链路流水线看懂“谁在等谁”:
- 在 Agent 车间,慢的是跨网通信和远端生成,所以用单线程异步(Event Loop)让一个 CPU 核同时挂几千个等待;
- 在 GPU 机房车间,慢的是 Python 解释器调度与数据预处理,所以底层要用 C++/Rust、多进程并行与 CUDA Graph 拼命榨干 CPU,别让昂贵的 GPU 闲着!
4. 进阶追问:既然“GPU 等数据”这么烧钱,大模型大厂在训练时是怎么喂饱 GPU 的?
如果一张 H100 显卡因为等 CPU 解码数据或等网络传输而闲置一半时间,万卡集群每天都在白白蒸发数百万人民币。为了把 MFU(Model FLOPs Utilization,模型算力利用率) 从 20% 硬生生拉到 50%~60% 的物理极限,现代头部大模型厂(如 DeepSeek、OpenAI、Meta)在 AI Infra 层构建了四道工业级“喂饭”防线:
- 离线预处理与零拷贝二进制平铺(Zero-Copy Binary Format)
绝不在训练中途让 CPU 现做分词(Tokenize)或解压缩原始网页。训练开始前,独立的 CPU 大集群早已把语料清洗并打包成紧凑的连续二进制块(如
mmap内存映射格式或Arrow/WebDataset)。训练时无需 CPU 解析语法,直接原封不动按字节块塞进显存。 - 后台多进程流水线重叠(Overlap Compute & Data Loading)
利用
num_workers=16开启多个独立 CPU 进程,在 GPU 埋头计算第 批数据(Batch )的同时,CPU 已经在后台提前把第 批数据搬进了显存的预取环形缓冲区(Prefetch Ring Buffer)。只要后台备菜速度 前台炒菜速度,GPU 就能无缝衔接、永不空转。 - 分布式内存/SSD 缓存与“防节点抖动(Anti-Straggler)”三件套
在万卡同步训练中,所有 GPU 每算完一步都必须全员对齐梯度(
All-Reduce);一旦 1,000 台机器里有 1 台因为远端存储节点抖动卡了 2 秒,其余 999 台机器就得全员陪等(即木桶效应 / 慢节点问题 Straggler Problem)。为此,大厂在分布式缓存层(如JuiceFS、Alluxio、以及 DeepSeek 开源的3FS)设计了三道防抖动护栏:- 蓄水池削峰(Prefetch Buffer):显存/内存里常备未来数步的存粮,吸收几百毫秒级的瞬时网络毛刺;
- 对冲读取(Hedged / Speculative Read):同一数据切片存有多副本;若向节点 A 请求超过
10ms未回包,不等超时立即向副本节点 B 并发重发请求,谁先返回用谁,直接砍掉长尾延迟; - 本机 NVMe SSD 贴身兜底:每台 GPU 服务器本地挂载 8 块极速 NVMe 固态盘作为本地缓存池,即便远端网络抖动也能降级直读本地盘。
- 终极杀器:
GPUDirect RDMA(彻底把 CPU 和操作系统内核踢出群聊!) 这是当今所有大模型训练集群的绝对标配(也是 NVIDIA 斥资 69 亿美元收购 Mellanox 迈络思的战略核心):- 传统 TCP/IP 网络的五道倒手:机器 A 的 GPU 想把算好的梯度发给机器 B 的 GPU,必须先从
A 显存 -> A 主内存 -> A 的 CPU 与内核打包 TCP -> A 网卡 -> B 网卡 -> B 的 CPU 与内核拆包 -> B 主内存 -> B 显存。来回拷贝 4~5 次,两边 CPU 被彻底累垮,延迟高达数百微秒(日常人类刷网页走百毫秒级外网毫无体感,但在 50 微秒算完一层的 GPU 之间就是致命瓶颈)。 GPUDirect RDMA(远程直接内存访问):每张 H100 旁直接配一张专属的400Gbps InfiniBand / RoCEv2智能网卡。CPU 只在最初下达一条指令,随后机器 A 的网卡直接伸手进机器 A 的 GPU 显存抓起数据,顺着光纤飞过去,由机器 B 的网卡直接写进机器 B 的 GPU 显存!全程零拷贝(Zero-Copy)、绕过操作系统内核(Kernel Bypass)、绕过主内存(RAM),两边 CPU 占用率为0%,跨机通信延迟骤降至1~2 微秒(连 DeepSeek 的3FS存储系统也是靠 RDMA 直接把训练数据从存储节点打进训练节点的内存/显存里)。
- 传统 TCP/IP 网络的五道倒手:机器 A 的 GPU 想把算好的梯度发给机器 B 的 GPU,必须先从
附录 A:栈帧展开、闭包逃逸与事件循环调度的形式化模型
为了将上述物理直觉沉淀为严密的数学图景,我们用状态自动机简要刻画单线程事件循环的调度不变式。
A.1 调用栈(Call Stack)与异步挂起(Continuation)
设主线程在时刻 的同步执行状态为调用栈 。
- 同步函数调用:压栈映射 ,栈深度单调增减,局部状态生命周期严格受限于栈帧区间 。
- 异步挂起(
await/ CPS 变换):当栈顶函数 发起非阻塞 I/O 请求 时,编译器(如 JS/Python 的协程状态机)将该函数剩余未执行的代码段打包为一个续延闭包(Continuation Closure) 并逃逸分配至堆(Heap)中,同时将栈帧 从当前调用栈弹出,使主线程得以立即返回处理其他任务。
A.2 事件循环(Event Loop)的死锁与饥饿条件
设就绪回调队列为 。单线程事件循环的推进算子满足严格的前置条件:仅当当前调用栈为空()时,才从队列头部弹出下一个续延 入栈执行。
若队列中第 个任务 包含耗时为 的纯同步 CPU 计算,则后续任务 ()的排队等待延迟为:
这从数学上直接解释了为什么在事件循环架构中,必须严格要求每个同步切片的执行时间 :一旦某个 (同步死循环),则 ,整个异步系统立即陷入全局饥饿(Starvation)。
附录 B:最小代码切片 —— 亲手看清“阻塞”与“非阻塞并发”
下面这段不到 25 行的 JavaScript 代码,直观展示了为什么同样是“处理 3 个耗时 2 秒的请求”,异步非阻塞只需要 2 秒,而同步阻塞会卡死整整 6 秒:
// 1. 正确的异步 I/O(模拟调用大模型 API):把等待交给底层,立即让出主线程
async function askLLM(userId) {
  console.log(`[0.0s] 金牌服务员接单:用户 ${userId},已派发网络请求,转身招呼下一位...`);
  await new Promise((resolve) => setTimeout(resolve, 2000)); // 模拟 2 秒网络 I/O 等待(不占 CPU)
  console.log(`[2.0s] 收到大模型回复,为用户 ${userId} 上菜!`);
}

// 并发启动 3 个用户的请求:总耗时仅 2 秒!
async function runConcurrentAgents() {
  await Promise.all([askLLM("A"), askLLM("B"), askLLM("C")]);
}

// 2. 灾难性的同步阻塞(反面教材):霸占唯一的 CPU 主线程死算 2 秒
function badCpuBlock(userId) {
  const start = Date.now();
  while (Date.now() - start < 2000) {} // 金牌服务员在原地踏步数数 2 秒,谁也别想插队!
  console.log(`用户 ${userId} 同步硬算完成(期间整台服务器对其他人完全假死)`);
}