本篇导读:面对 Google Cloud (GCP) 或 AWS 动辄数百项的云端服务目录,初学者往往容易陷入“名词迷宫”;而在实际构建数字产品时,如何在 Cloudflare 这类全球边缘云与 Google Cloud 这类传统中心云之间做架构取舍,又是决定系统维护成本与响应速度的分水岭。本篇讲义从一台个人电脑的硬件拆解出发,围绕四个递进的核心问题,系统还原现代云服务的底层存储与数据库分野、三代算力范式的解耦演进、边缘云与中心云的物理拓扑差异,以及现代轻量应用中最具代表性的“单 Worker 全栈门店”工程机制。
问题一:为什么一打开云控制台就会迷失?—— 云端四大原语与存储分野
当你第一次打开任何一家主流云厂商(GCP、AWS、阿里云)的控制台时,页面上往往同时陈列着 Compute Engine、Cloud Storage、BigQuery、VPC 网络、Kubernetes Engine、IAM 等数十个入口。之所以让人感到无从下手,是因为云厂商把给独立构建者用的基础积木和给跨国企业管理上万台服务器用的底层基建平铺在了同一个桌面上。
要看懂任何一家云服务商,最有效的心智模型是回到一台个人电脑(PC)。无论云端产品的命名多么繁复,整朵云在物理本质上只是把一台电脑拆成了独立计费的四个基础原语:
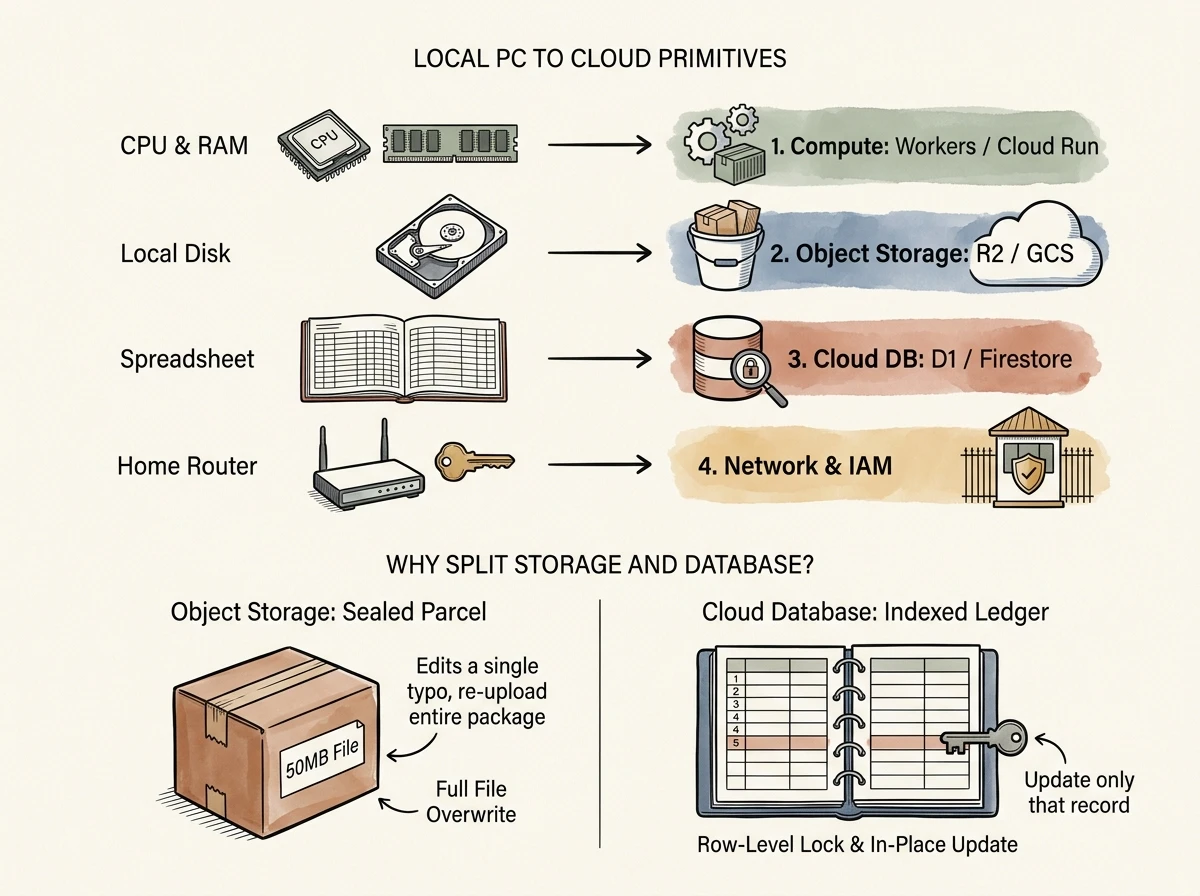 图:本地个人电脑硬件与云端四大基础原语的映射(上),以及对象存储与云数据库的底层读写机制分野(下)。1. 本地负责执行程序的
CPU & RAM 映射为云端算力层(Compute),如 Cloudflare Workers 或 GCP Cloud Run;2. 存放静态大文件的本地磁盘(Local Disk)映射为按体积计费的对象存储(Object Storage),如 Cloudflare R2 或 GCP Cloud Storage;3. 本地记录结构化账目的电子表格(Spreadsheet)映射为支持并发按行读写的云数据库(Cloud DB),如 Cloudflare D1 或 Firestore;4. 家用路由器与门禁(Home Router)映射为云端虚拟网络与权限控制(Network & IAM)。
核心解惑:为什么在电脑上“表格也是硬盘里的文件”,到了云端却必须把“对象存储”和“数据库”拆开?
在个人电脑上,一份 账本.xlsx 表格和一张 风景.jpg 照片明明都存放在同一块本地硬盘里;但到了云端,所有云厂商都会严格区分“对象存储(Object Storage)”与“云数据库(Database)”。这背后的物理根源在于“能否在并发环境下原地修改一行数据”:
- 个人电脑上的单机假象:本地硬盘本身并不理解 Excel 文件里有哪些行和列,只认识一整块连续或分块的二进制字节流。当你修改表格第 100 行的一个数字并按下保存时,电脑实际上先把整个
.xlsx文件完整读入内存,由 Excel 软件修改那一个单元格,再把整个文件重新序列化并覆盖写回硬盘。因为在单机上只有你一个人操作且文件较小,你察觉不到这个“全量读取 全量覆盖”的笨重过程。 - 如果把结构化账目当普通文件扔进云端对象存储(R2 / GCS)的两大灾难:
- 整存整取的带宽浪费(Full File Overwrite):云端的对象存储就像一个只收“密封快递箱”的仓库,铁律是只能按文件 Key 整箱存入、整箱取出,不支持伸手进去只改纸箱里的一页纸。如果把一个 50MB 的数据文件存在里面,每次在网页上更新一条状态,云端代码都必须先把 50MB 完整拉取下来、改完 1 个字节、再把 50MB 完整上传覆盖。
- 多端并发的静默抹除(Lost Update):如果前端网页和后台定时任务在同一秒读取了这份文件各自修改,后保存的一方会直接把先保存一方的修改彻底覆盖抹掉,毫无事务锁保护。
因此,云服务商在物理磁盘之上分化出了两个截然不同的工种:
| 对比维度 | 对象存储 (Cloudflare R2 / GCP Cloud Storage) |
云数据库 (Cloudflare D1 / Firestore / Cloud SQL) |
|---|---|---|
| 物理机制 | 键值对象仓库(不可变字节流 + HTTP 下载地址) | 受管存储引擎(B-Tree / LSM-Tree 索引 + 事务锁管理器) |
| 读写粒度 | 只能按完整对象上传、下载或删除(整存整取) | 支持 SQL 或文档级行锁,原地精准检索并更新单条记录 |
| 存放内容 | 无需拆开局部修改的静态资产:图片、PDF、音视频、备份包 | 需要高频筛选、排序与并发修改的状态数据:业务账目、任务状态、会话记录 |
| 计费特征 | 极低廉(仅按占用的冷存储体积计费) | 按存储 + 计算/读写行数计费(需为后台检索与锁管理引擎付费) |
问题二:同样是“跑代码”,虚拟机、容器与 Serverless 到底差在哪?
在云上运行一段程序,过去二十年经历了三次核心范式演进。理解这三者的解耦过程,就能明白为什么现代请求驱动型应用几乎不再首选租用传统虚拟机(VPS)。
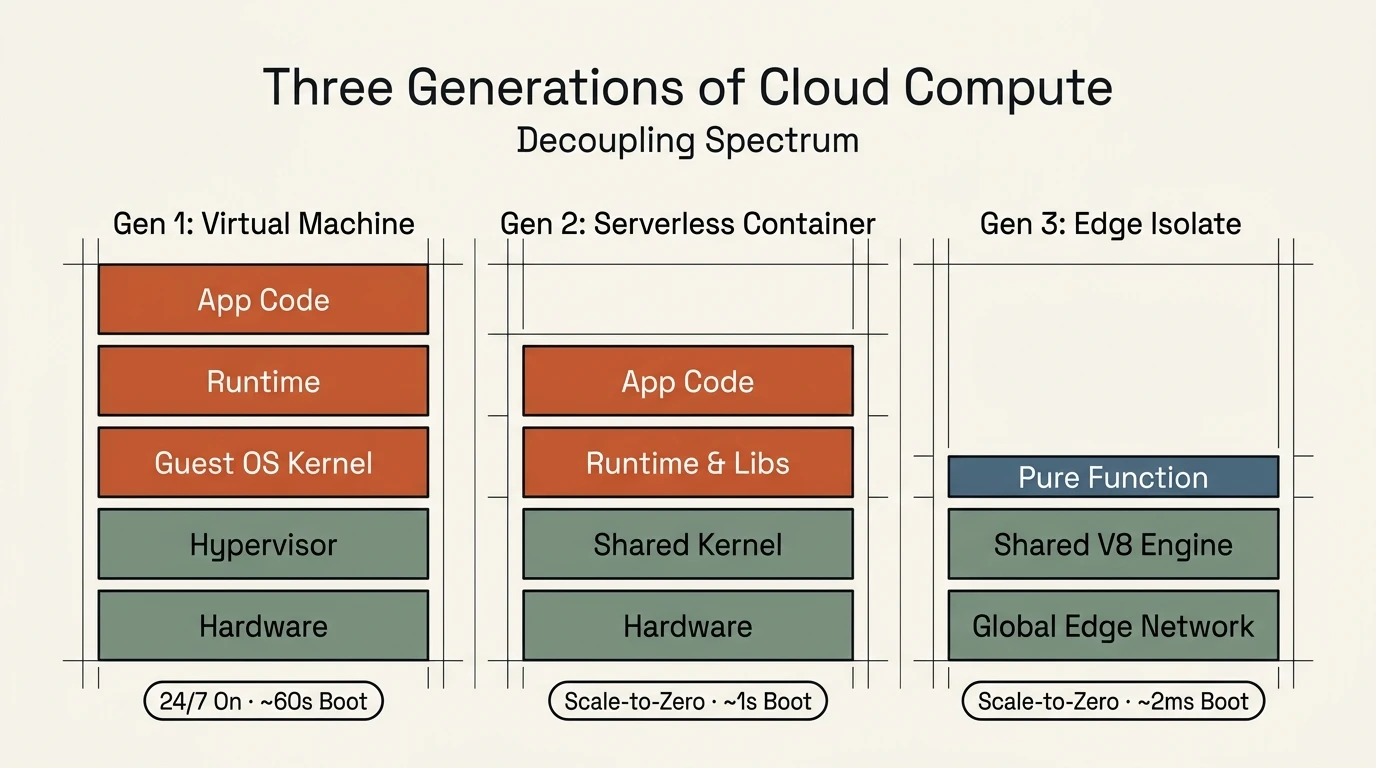 图:云端算力三代演进与解耦光谱(Three Generations of Cloud Compute)。图中陶土红与冷钢蓝模块代表需要开发者自行维护或打包的层级,灰绿色模块代表由云厂商全自动托管的底层基建。第一代(
Gen 1: Virtual Machine,如 GCP Compute Engine / AWS EC2)需自行维护完整的客户机操作系统内核(Guest OS Kernel)、语言运行时与业务代码,开机耗时长达 ~60s 且必须 24 小时常驻计费;第二代(Gen 2: Serverless Container,如 GCP Cloud Run)将操作系统内核下沉为云端共享层,开发者仅需将业务代码与依赖打包为 Docker 镜像,实现 ~1s 启动与无人访问时缩容至零(Scale-to-Zero);第三代(Gen 3: Edge Isolate,如 Cloudflare Workers)进一步剥离操作系统外壳,在共享的全球 V8 引擎之上直接运行纯粹的业务函数(Pure Function),实现 ~2ms 极速唤醒。
核心权衡:常驻计费 vs. 按需缩容至零(Scale-to-Zero)
- 传统虚拟机(Compute Engine / VPS)= 整租一间常驻办公室 哪怕你的工具一周只触发两次、每次运行 3 分钟,这台虚拟机也必须 7×24 小时开机耗电。你不仅要为 99.9% 的闲置时间按月付费,还需承担操作系统补丁升级、磁盘日志清理与公网端口防扫描等运维负担。
- Serverless 容器与边缘函数(Cloud Run / Cloudflare Workers)= 按毫秒计费的随叫专车
Serverless 最核心的架构变革,是将“代码的部署存在(Deployment)”与“代码的物理运行(Execution)”彻底解耦——平时无人访问时,代码仅作为静态字节码躺在云端存储中,处于“0 实例运行”状态,边际闲置成本严格为零。
当外部请求(HTTP 点击或定时触发器)到达云端网关的那一刻:
- 云平台在 2 毫秒(Cloudflare Workers)至 1 秒(Cloud Run) 内瞬间唤醒实例;
- 程序执行完数百毫秒的查询或计算任务,将结果返回客户端;
- 闲置片刻后,云端自动销毁或冻结实例,账单立即停止跳动。
[!NOTE] 适用边界:什么时候传统虚拟机(VPS)或本地常驻主机(如 Mac mini)反而优于 Serverless? Serverless 的优势建立在“请求/事件驱动、短平快、无常驻内存状态”的前提之上。一旦系统需要 7×24 小时维持长连接或后台守护进程——例如需要维持 WebSocket / TCP 长连接的即时通讯网关、需要长期保持本地浏览器上下文会话或本地进程池的守护服务——Serverless 的“用完即焚(Scale-to-Zero)”机制反而会造成频繁断连与冷启动惩罚。在这类常驻有状态场景下,一台待机功耗仅 5W 的本地常驻主机(配合 Cloudflare Tunnel 内网穿透)或按月租用的轻量 VPS,在工程心智与长周期成本上反而更加顺手。
问题三:边缘云(Cloudflare)与中心云(Google Cloud)的本质差异是什么?
这是现代云架构选型中最核心的问题:既然已经有了 Cloudflare(可免费托管前端并运行边缘函数与数据库),为什么还需要 Google Cloud 或 AWS?反过来,有了功能完备的传统大云,为什么开发者又越来越偏爱 Cloudflare?
答案在于:两者的物理网络基因完全相反——Cloudflare 是“驻扎在全球网线交汇处的边缘轻骑兵”,而 Google Cloud 是“建在少数核心区域的重装超级工厂”。
1. 物理拓扑与底层运行时的代差
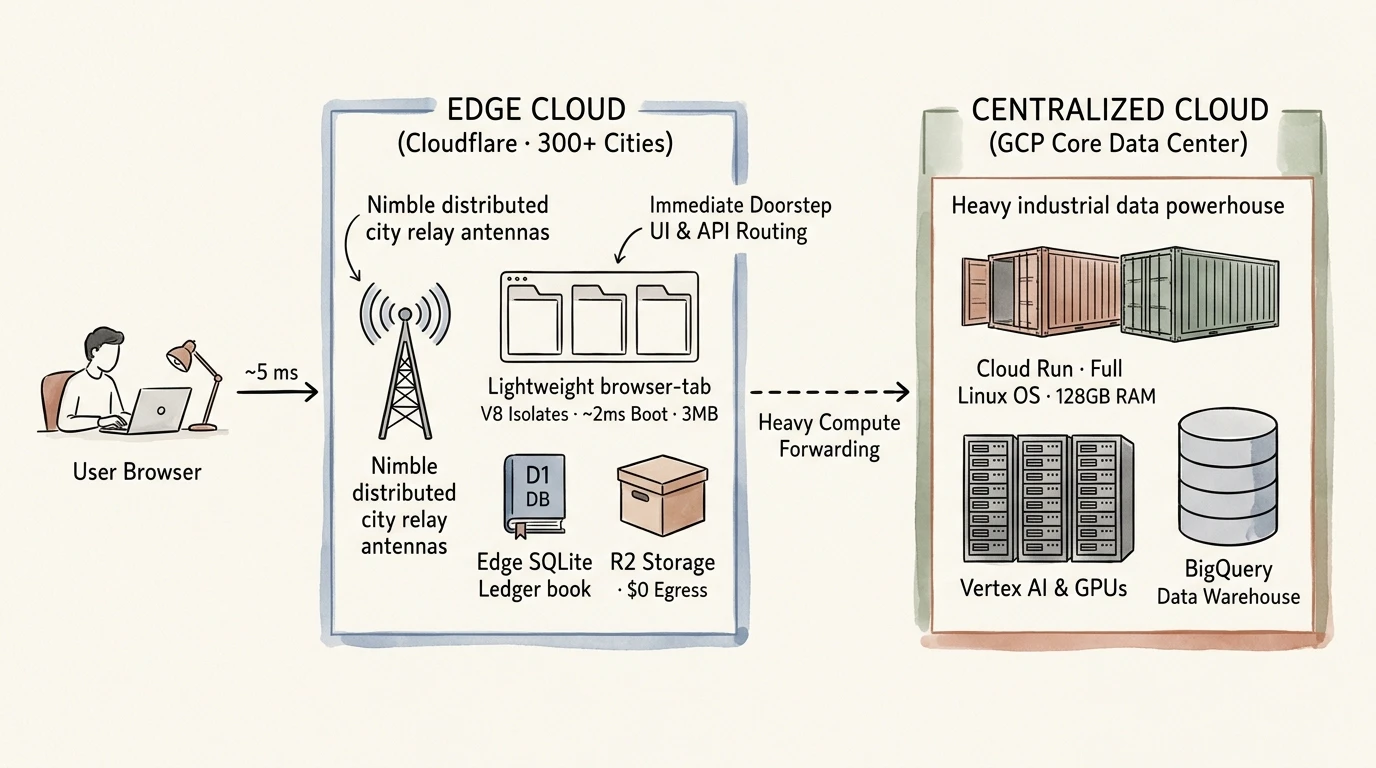 图:边缘云(
Edge Cloud: Cloudflare,中)与中心云(Centralized Cloud: GCP,右)的物理拓扑与分工。终端用户(User Browser)的请求首先在 ~5 ms 内就近接入遍布全球 300 多个城市的边缘节点,由 ~2 ms 唤醒的 V8 Isolates 结合边缘轻量存储(D1 DB 与 $0 Egress 的 R2 Storage)直接完成界面渲染、鉴权与 API 路由;仅当遇到需要完整 Linux 容器环境、重型 GPU/TPU 算力集群或 PB 级数据仓库(Cloud Run、Vertex AI、BigQuery)的重负载任务时,才通过跨网转发链路(Heavy Compute Forwarding)交由少数核心区域的中心化超算机房处理。
- Cloudflare 的底座是
V8 Isolates(语言虚拟机微隔离): 传统云厂商每运行一个容器都要初始化一套 Linux 用户态环境;而 Cloudflare 将 Chrome 浏览器的 V8 引擎搬到了遍布全球 300 多个城市的边缘服务器上。每次唤醒一段 Worker 代码,本质上是在已常驻的 V8 宿主进程里“新开一个隔离的内存标签页(Isolate)”,耗时仅 2 毫秒,内存开销仅约 3MB(底层隔离机理详见《第三讲》)。- 优势:全球就近接入、零冷启动感、天然防 DDoS、免费额度极其慷慨。
- 局限:标准 Worker 不是完整的 Linux 操作系统,无法直接运行依赖原生 C/C++ 编译的 Python 科学计算栈(如完整的
scipy/matplotlib)、无法调用系统级二进制命令行工具(如ffmpeg或ripgrep),且单次 CPU 计算时长受限(若需跑完整容器,须启用付费扩展Cloudflare Containers)。
- Google Cloud 的底座是
完整 Linux 容器与重型硬件集群: GCP 的Cloud Run提供的是标准 Linux 容器环境。- 优势:任何能在本地 Linux / Docker 中运行的二进制程序、C++ 扩展库、Python 数据科学工具链,在 Cloud Run 中 100% 均可原样运行,单实例最高可配 32 核 CPU、128GB 内存乃至挂载 GPU,且同样支持无人访问时缩容至
$0。 - 局限:容器冷启动需
0.5s ~ 2s,机房集中在固定地理区域(如美西、东京),且公网出站带宽计费昂贵。
- 优势:任何能在本地 Linux / Docker 中运行的二进制程序、C++ 扩展库、Python 数据科学工具链,在 Cloud Run 中 100% 均可原样运行,单实例最高可配 32 核 CPU、128GB 内存乃至挂载 GPU,且同样支持无人访问时缩容至
2. 核心组件对标与选型判准
| 能力维度 | Cloudflare 对应产品 | Google Cloud (GCP) 对应产品 | 核心差异与架构选型判准 |
|---|---|---|---|
| 前端静态托管 | Cloudflare Pages / Workers Assets 🏆 | Firebase Hosting / Cloud Storage | 首选 Cloudflare:绑定 GitHub 自动构建,全球 CDN 边缘缓存,无限流量免费。 |
| 轻量 API 与路由网关 | Cloudflare Workers 🏆 | Cloud Run functions | 编写 REST API、远程 MCP 服务端、Webhook 路由或大模型 API 编排,Workers 响应更快、配置更轻。 |
| 重型后端与容器沙箱 | Cloudflare Containers (需 $5/月底租) | GCP Cloud Run 🏆 | 与 Worker/D1 同工程紧密协同的中小容器选 Cloudflare Containers;追求 $0 零月租起步、一键部署任意标准 Dockerfile 或需大内存/GPU 时选 Cloud Run。 |
| 结构化数据库 | Cloudflare D1 (边缘托管 SQLite) | Firestore (文档库) / Cloud SQL | 中小规模全栈应用首选 D1(与 Worker 同内存绑定免密直连);高并发大规模关系型数据库选 Cloud SQL。 |
| 对象存储(大文件/图床) | Cloudflare R2 🏆 | Cloud Storage (GCS) | R2 的杀手锏是“免出站流量费 ($0 Egress)”;传统中心云存储桶一旦遭遇高频下载,出站带宽账单极为高昂。 |
| 企业级数仓与 AI 中台 | Vectorize / Workers AI (偏轻量) | BigQuery + Vertex AI 🏆 | 涉及亿级行数据分析、企业级合规与多厂商旗舰大模型统一调度,GCP 具备绝对统治力。 |
[!NOTE] 商业机制拆解:为什么 Cloudflare 能把核心基建免费开放给开发者?
- 闲置边缘算力的错峰复用:Cloudflare 的主业是为全球大型企业抵御 T 级 DDoS 攻击并提供 CDN 加速,必须在 300 多个城市常备海量冗余带宽与服务器。利用几 MB 内存、毫秒级生灭的
V8 Isolates承载开发者的轻量请求,边际电费与硬件折旧近乎为零。- 用“零出站流量费(Zero Egress Fee)”击穿传统中心云软肋:AWS S3 与 GCP GCS 虽然存储单价低,但对每 GB 下载收取昂贵的出站带宽费;而 Cloudflare 身为骨干网交换节点,其
R2存储桶提供每月 10GB 免费容量且出站流量费永久为 $0,彻底消除了流量刷爆账单的风险。- 产品驱动增长(PLG)漏斗:免去个人与初创团队每月几美元的琐碎账单,换取全球开发者构建原型时的默认首选心智;当业务规模扩张至企业级合规、高并发与安全治理(Enterprise Plan)时,再实现高客单价商业变现。
问题四:现代轻量全栈应用是如何组织的?—— 解剖“单 Worker 前店后厂”架构
在早期的云端开发中,部署一个前后端分离的全栈应用通常需要拆成两个独立项目:前端静态文件部署在托管平台,后端接口部署在另一台服务器,中间还要配置跨域资源共享(CORS)、数据库连接池与环境变量密钥。
而在现代 Cloudflare 工程实践中,通过 “单 Worker 全栈架构(Workers + Static Assets + Bindings)”,一个部署单元就像一间“前店后厂”的紧凑工坊——前门是直接向浏览器分发静态网页的展示橱窗(public/),中庭是处理 API 与定时任务的运行时操作间(src/index.ts),后院则通过内部内存管道直连地下金库(D1 数据库与 R2 存储桶)。
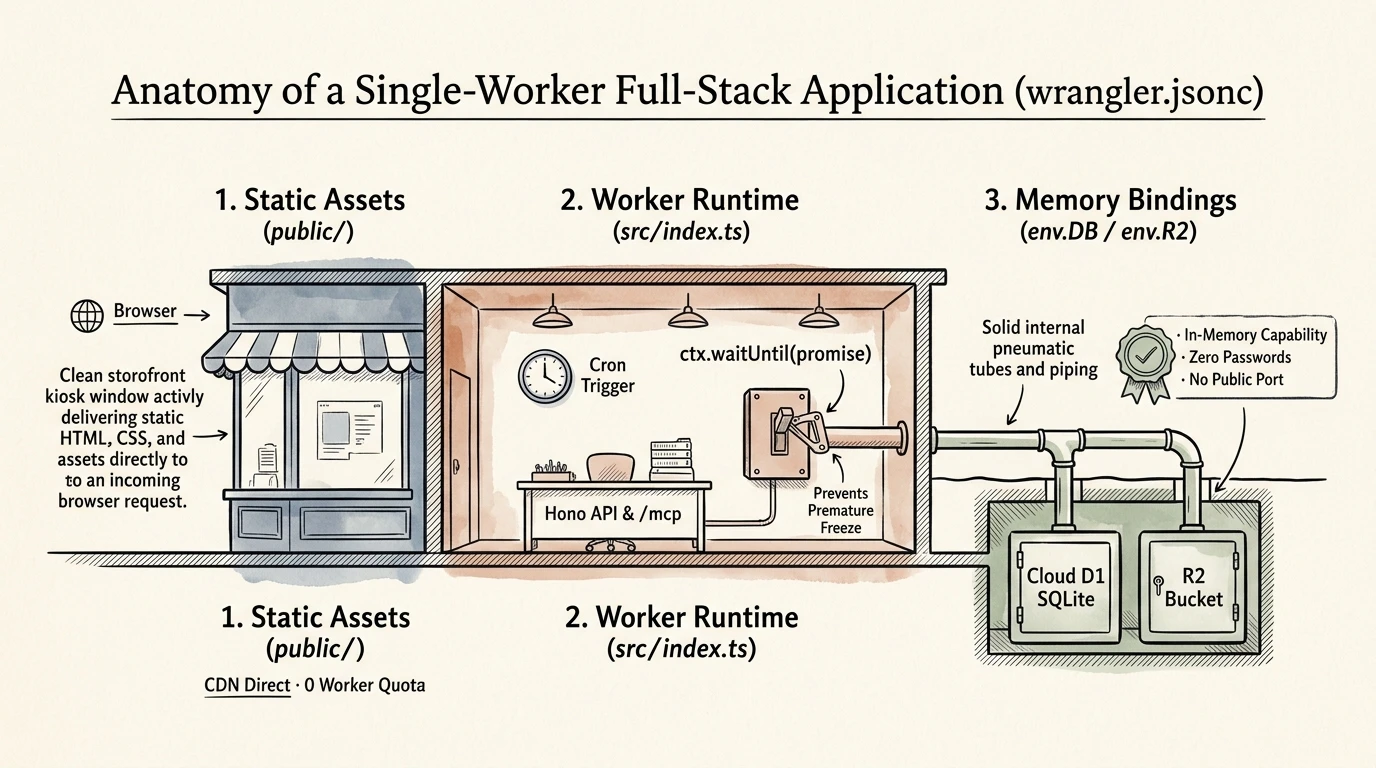 图:单 Worker 全栈应用(
wrangler.jsonc)的“前店后厂”架构剖面图。1. 前门静态橱窗(Static Assets: public/):浏览器访问静态网页时由全球 CDN 节点直接返回,完全不唤醒后端代码(消耗 0 次 Worker 额度);2. 中庭运行时工坊(Worker Runtime: src/index.ts):承载 API 路由与定时触发器(Cron Trigger),墙上的电源开关配有一支 ctx.waitUntil(promise) 机械撑杆,防止沙箱在异步后台任务完成前被提前断电冻结;3. 后院内存管道(Memory Bindings: env.DB / env.R2):由宿主机在内存层直接注入已鉴权的私有能力句柄,实现零密码配置、零公网端口暴露与零连接握手延迟的直连读写。
打开一份仅 20 余行的标准配置文件 wrangler.jsonc,即可看清五种基础设施能力是如何浓缩进同一个原子部署单元的:
{
  "name": "fullstack-app",
  "main": "src/index.ts",               // 1. 算力中枢:API 路由与服务端业务逻辑
  "compatibility_date": "2025-03-01",
  "assets": {                           // 2. 静态橱窗:同域托管前端 HTML/CSS/JS
    "directory": "./public",
    "binding": "ASSETS"
  },
  "d1_databases": [                     // 3. 结构化账本:内存绑定 D1 SQLite 数据库
    {
      "binding": "DB",
      "database_name": "app-db",
      "database_id": "xxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxxx"
    }
  ],
  "r2_buckets": [                       // 4. 对象存储箱:内存绑定 R2 存储桶
    { "binding": "BUCKET", "bucket_name": "app-files" }
  ],
  "triggers": {                         // 5. 云端定时器:按 Cron 表达式自动唤醒任务
    "crons": ["0 22 * * 1-5"]
  }
}
在这份简短的配置背后,隐藏着三个极具代表性的云原生底层机制:
1. 同域静态托管(Static Assets):为什么比前后端分拆部署更优雅?
当在配置中声明 "assets": { "directory": "./public" } 后:
- 静态流量零算力损耗:当浏览器请求
/index.html或/app.js时,边缘网关直接从 CDN 缓存返回静态文件,根本不会唤醒src/index.ts中的 Worker 实例,因此静态页面访问完全不消耗每日免费请求额度。 - 天然消灭跨域(CORS)与版本撕裂:前端页面发起的
fetch('/api/data')与网页本身处于完全相同的域名与端口下,无需配置任何 CORS 响应头;且每次执行wrangler deploy,前端界面与后端接口在同一秒内原子化同步生效。
2. 内存级资源绑定(Bindings):为什么 env.DB 连数据库账号密码都不用配?
在传统云服务器架构中,后端代码访问数据库必须经历三步:开放数据库网络端口 在 .env 中配置账号密码 每次建立连接时执行 TCP 三次握手与 TLS 加密握手(单次握手开销常达 100ms ~ 300ms)。
而在 Worker 架构中,D1 数据库与 R2 存储桶通过 Bindings(环境绑定) 直接注入到代码的 env 参数中:
- 物理机制:当 Worker 实例被唤醒时,宿主机直接在内存层面将一条预先完成权限绑定的内部能力句柄(Capability Reference)交给了
env.DB。 - 工程收益:零明文密码(代码库与环境变量中绝无数据库密码可泄露)、零公网暴露(数据库在公网上没有任何可被扫描的 IP 或端口)、毫秒级读写(省去了传统的连接池维护与加密握手延迟)。
- 跨云边界说明:
Bindings免密内存专线仅限同一云生态内部组件互通;若在 Worker 中跨云调用外部存储(如 GCP Cloud Storage),则需退回标准公网模式,在环境变量(Secret)中配置外部服务凭证并通过 HTTPS 协议访问。
3. Serverless 的“拔电源定律”:为什么异步后台任务必须包裹 ctx.waitUntil()?
在编写定时任务(scheduled)或需要在返回响应后继续异步记录日志的接口时,标准代码如下:
export default {
  fetch: app.fetch,
  async scheduled(event: ScheduledEvent, env: Env, ctx: ExecutionContext) {
    // 关键原语:向云端调度器申请延缓冻结实例,直至 Promise 完成
    ctx.waitUntil(
      syncExternalDataAndWriteSnapshot(env.DB)
    );
  },
};
这是从传统常驻服务器转向 Serverless 时最容易踩中的生命周期陷阱:
- 传统常驻服务器是 24 小时通电的,主函数返回后,留在内存里的异步
Promise依然会继续把数据库写完。 - Serverless 极速沙箱则是按毫秒计费的——一旦入口函数(
fetch或scheduled)执行完毕返回,云端调度器为了节省算力,会在下一毫秒立刻冻结并回收整个沙箱实例。如果不加ctx.waitUntil(...),异步网络请求刚发出去一半,沙箱就被强行“拉闸断电”了。 ctx.waitUntil(promise)的机制本质:正如上图 2 中庭墙上的机械撑杆,它向云端宿主递交了一张“延缓拉闸申请单”——即便主 HTTP 响应已经先行返回给客户端,也强制保持当前 Isolate 通电运行,直到括号内的异步任务彻底落盘完毕后再销毁实例。