本篇导读:在第一篇至第四篇中,我们依次穿越了广义线性模型、贝叶斯正则化、支持向量机(SVM)以及决策树与集成学习(RF / GBDT / XGBoost)。面对散落在各章中的概率似然、拉格朗日对偶、核希尔伯特空间与正交超矩形切分,本篇在中场节点建立一座全局俯瞰塔:首先用“经验风险 + 结构风险”的大一统优化方程将前四站彻底焊合,在几何空间与偏差-方差光谱上厘清三大门派的领地分野;随后沿着 1950s–2010s 的历史时间线复盘门派更替的内在逻辑,剖析传统机器学习“固定特征契约”在同构感知信号面前的结构性失效,正式推开端到端表征学习(深度学习)的大门。
1. 传统机器学习的“大一统方程”:万物皆可 经验风险 + 结构风险
回顾前四站,不同流派的发明者有着截然不同的学术背景:高斯与费雪来自数理统计,Vapnik 来自泛函分析与统计学习理论,Breiman 与 Friedman 则扎根于非参数统计与计算科学。正因如此,各门派的数学黑话千差万别——第一章讲的是“高斯噪声与极大似然估计(MLE)”,第二章讲的是“高斯/拉普拉斯先验与最大后验(MAP)”,第三章变成了“最大间隔超平面与拉格朗日对偶”,第四章又换成了“信息熵、基尼指数与函数空间负梯度(GBDT)”。
然而,当我们剥离掉历史演进留下的术语外壳,将前四站的所有算法放在同一个泛函最优化显微镜下做一次“基因测序”时,会惊讶地发现——半个世纪的传统监督机器学习,本质上都在求解同一个大一统方程(结构风险最小化,Structural Risk Minimization, SRM):
剥开这个优化目标,它的左右两项分别扮演着不可或缺的对偶力量:
- 第一项(经验风险 —— 倾听样本证据,追求拟合得准):看手头样本点怎么分布,踩油门驱动模型拼命贴合已知数据,核心使命是把偏差(Bias)降下来;
- 第二项(结构风险 —— 注入先验偏好,控制模型复杂度):在看具体数据之前,人类工程师通过选定模型家族 (硬先验 / 归纳偏置)以及惩罚项 (软先验)给模型踩刹车,防止模型因参数过度自由而死记硬背样本里的微观随机噪声,核心使命是把过拟合风险与方差(Variance)压下去。
认知顿悟(抽象压缩与场景解压缩): 数学理论的演进史,本质上是人类将零散、经验性的工程直觉提炼为极简“通用母方程”的抽象压缩过程。例如,AdaBoost 最初诞生时充斥着样本重加权、基分类器投票权重计算等特定启发式技巧;直到 Jerome Friedman 指出 Boosting 的本质是在函数空间中沿着损失函数的负梯度方向下山(GBDT),整个集成学习才被彻底压缩进了泛函梯度的优美母框架下。 这种抽象压缩赋予了算法工程师极致的“解压缩自由度”:在真实业务场景中,我们只需要像拼积木一样切换经验损失 (面对厚尾异常值换 Huber 损失、面对排序业务换对偶排名损失 Pairwise Loss、面对二分类概率换 Log-Loss)或更换正则项 (追求参数稀疏选 、追求平滑共线性抑制选 、追求简单规则选树深度与叶节点惩罚),就能瞬间解压缩出成百上千种为业务量身定制的全新机器学习算法。
任何一个监督学习算法,无非是在回答由该方程拆解出的三个正交哲学问题:
- 假设空间 (Hypothesis Space):我允许候选函数 长什么几何形状?(是平直的超平面、升维后的平滑曲面,还是横平竖直的阶梯盒子?)
- 经验损失函数 (Loss Function):当模型预测值 与真实标签 不符时,我该用什么尺子衡量“犯错的代价”?(是平方误差、对数交叉熵,还是合页损失 Hinge Loss?)
- 复杂度惩罚与归纳偏置 (Regularization & Inductive Bias):为了防止模型在有限样本上死记硬背(过拟合),我该如何给函数 戴上紧箍咒?
1.1 前四站核心模型的大一统基因图谱
将前四站的主角逐一代入上述三大维度,原本孤立的公式瞬间严丝合缝地咬合在了一起:
| 模型流派 | 假设空间 (函数形式 ) | 经验损失 (犯错标尺) | 复杂度控制 (防过拟合枷锁) | 概率论 / 几何学底牌 |
|---|---|---|---|---|
| 线性回归 (OLS / Ridge / Lasso) | 全局线性超平面 |
均方误差 (MSE) |
范数 (Ridge) 范数 (Lasso) |
高斯观测噪声 MLE + 高斯/拉普拉斯参数先验 MAP |
| 逻辑回归 (Logistic) | 广义线性对数几率 |
对数交叉熵 (Log-Loss) () |
范数 或 范数 | 伯努利分布 MLE + Sigmoid 概率校准 |
| 支持向量机 (SVM + 核) | 核希尔伯特空间超平面 |
合页损失 (Hinge Loss) |
间隔走廊宽度倒数 (等价于最大化 ) |
边缘支持向量稀疏性 + 核内积高维平滑映射 |
| 单棵决策树 (CART) | 轴平行超矩形局部常数 |
回归:盒内 MSE 分类:信息熵 / 基尼指数 |
叶节点个数与树深限制 $$\alpha |
T |
| 随机森林 (Random Forest) | 棵深树并联算术平均 |
单树内部贪心极小化不纯度(MSE / Gini) | 隐式统计正则:Bootstrap 采样 + 节点特征子空间抽样(压低 ) | 大数定律与协方差拆解:打破克隆树相关性地板 |
| 梯度提升树 (GBDT / XGBoost) | 棵浅树串联加法模型 |
任意二阶可微凸损失 (二阶泰勒展开 ) | 树结构正则 + 收缩学习率 |
函数空间梯度下降(用新树拟合负梯度残差) |
1.2 三种损失函数的同台竞技:为什么分类问题会有三种截然不同的尺子?
在二分类问题中(不妨统一设真实标签 ,模型原始打分为 ),乘积 被称为函数间隔(Functional Margin):
- 当 时,说明预测符号与真实标签同号(分类正确),且 越大,样本离决策边界越远,分类越有把握;
- 当 时,说明预测符号与真实标签异号(分类错误)。
为什么逻辑回归、SVM 和 Boosting 会选择不同的损失函数?把它们画在同一张以 为横轴的坐标系里,三者的性格差异一目了然:
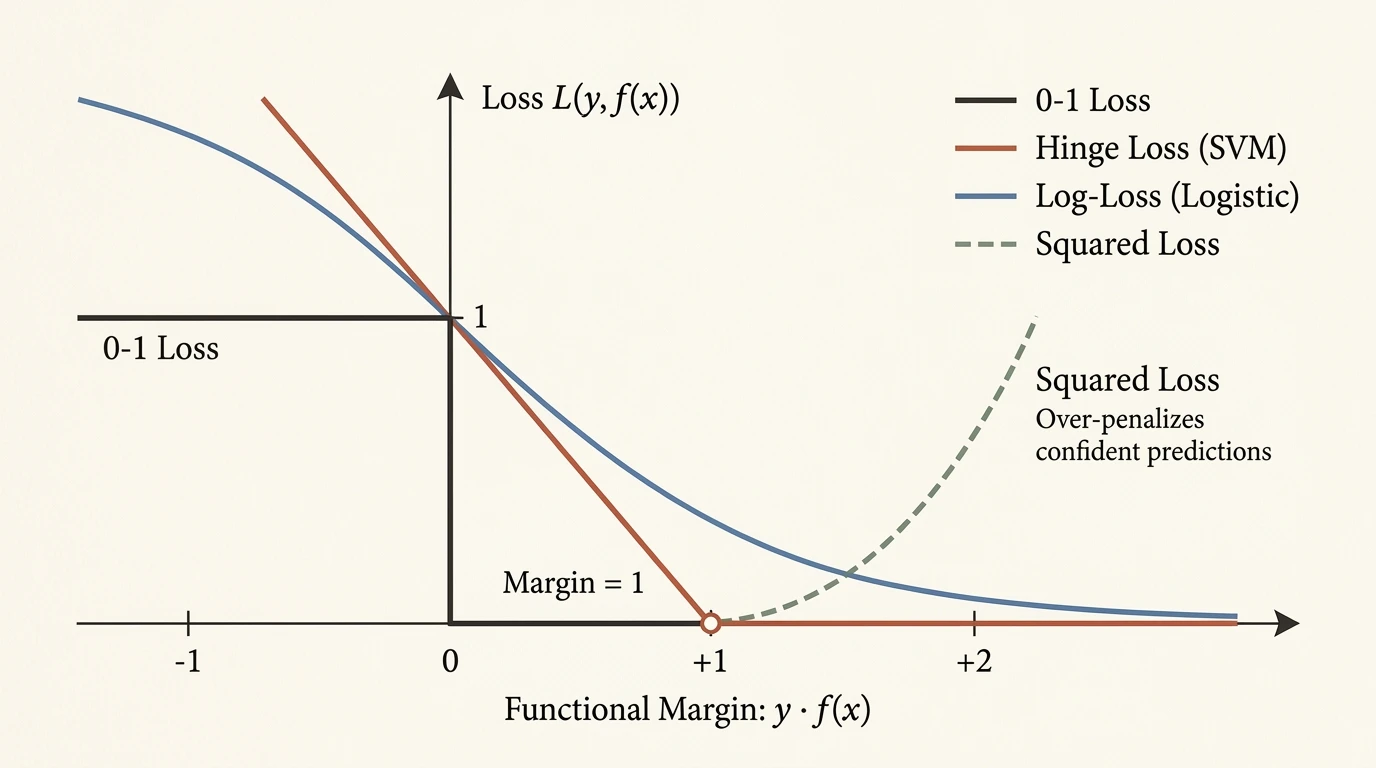 图:四种常见分类经验损失函数随函数间隔 的变化全貌对比。0-1 损失为不可导的阶梯标尺;合页损失在安全走廊边界 后彻底归零,造就支持向量的极致稀疏性;对数损失处处平滑且渐近趋于 0,驱动全局后验概率校准;平方误差损失在 处反而惩罚过度置信。
- 理想损失 :犯错记 分,正确记 分。虽然最符合人类直觉,但它是一个处处梯度为 、在原点处断裂的阶梯函数,无法用梯度下降求解(直接优化是 NP-Hard 问题)。因此,所有现代分类损失本质上都是 损失的平滑凸代理函数(Convex Surrogate Loss)。
- 对数交叉熵损失(Log-Loss,逻辑回归 / 神经网络 / GBDT 分类标配):
- 性格特征(追求全局概率校准的完美主义者):即使某个样本已经被正确分类且 ,对数损失依然大于 ,梯度永不归零。这迫使模型照顾到空间里的每一个样本,从而能够输出具备严格统计学含义的后验概率 ;但代价是对极端异常值(离群噪声)较为敏感。
- 合页损失(Hinge Loss,软间隔 SVM 标配):
- 性格特征(抓大放小的实用主义几何学家):只要样本被正确分类且跨过了安全走廊边界(),损失直接砍成绝对的 ,梯度彻底消失!这意味着安全区内的绝大多数样本(非支持向量)对决策边界毫无发言权,造就了 SVM 极致的解的稀疏性(Sparsity)与局部抗干扰能力;但代价是丧失了直接输出 calibrated 概率的能力。
2. 几何切分与偏差-方差全景图:三大门派的领地分野
如果把二维特征平面 想象成一块画布,前四站的三大门派在画布上切割正负样本的手法,代表了人类理解高维空间的三种基本几何原型:
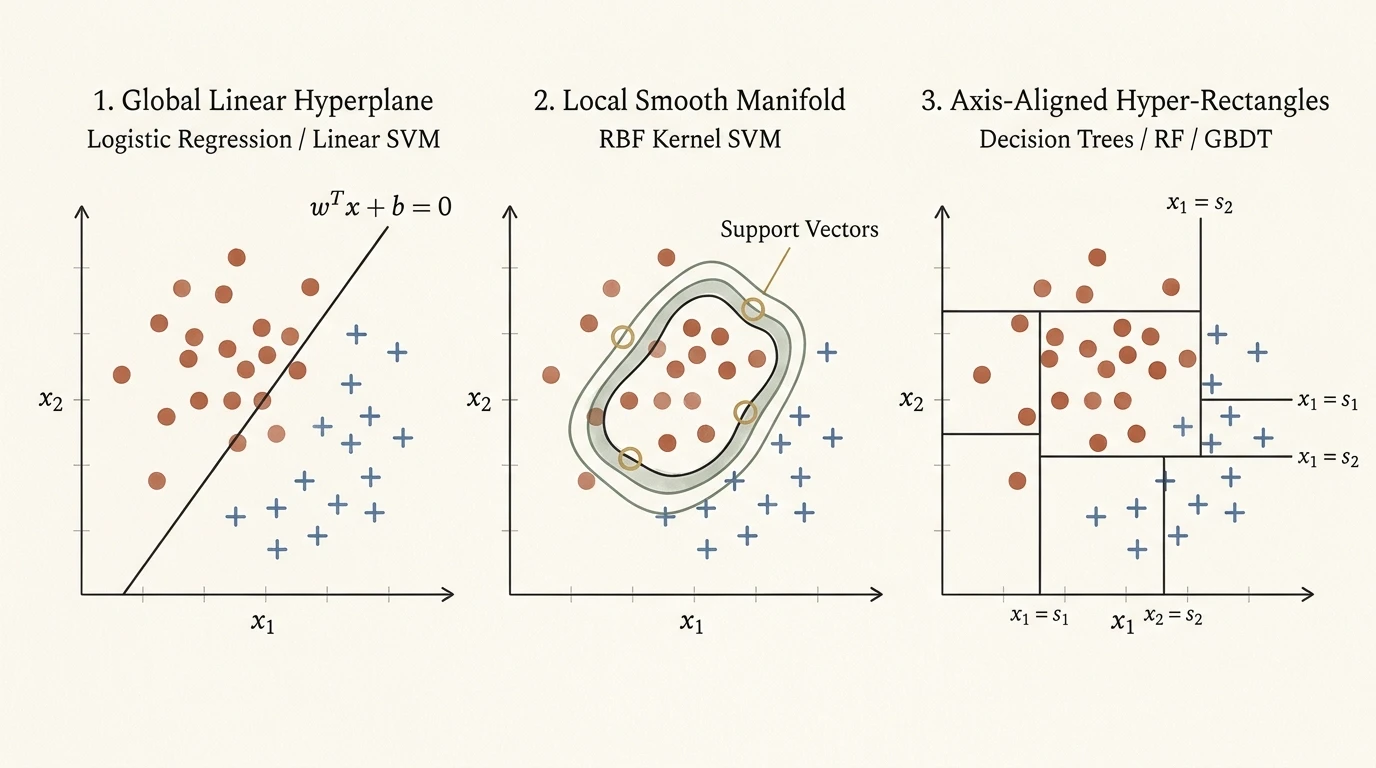 图:传统机器学习三大流派在同一份二维非线性双月数据集上的决策边界与几何划分对比。原型一(逻辑回归 / 线性 SVM)强制施加全局单调线性超平面;原型二(高斯 RBF 核 SVM)依赖欧氏局部核相似度构建平滑包络流形;原型三(CART / 随机森林 / GBDT)通过轴平行递归切分拼出阶梯式正交超矩形。
2.1 泛化误差的严格定义与偏差-方差(Bias-Variance)光谱
在日常讨论中,人们很容易产生一个直觉误区:“如果我把模型调得很复杂,让它在手头这批数据上拟合得死准(每个点的残差 都接近 ),那它的方差不是应该很小吗?为什么统计学家反而说‘拟合得太准会导致方差爆炸’?”
要彻底捅破这层窗户纸,必须回到数理统计(如《西瓜书》第 2.5 节与《ESL》)对期望泛化误差(Expected Test Error)的严格数学定义:
假设真实世界的底层规律为确定性函数 ,而观测标签 混有不可消除的独立随机噪声 (满足 )。当我们从总体分布中抽取一个包含 个样本的训练集 时,学习算法会据此训练出一个依赖该特定数据集的预测模型 。 如果我们做一场“平行宇宙思想实验”——从总体分布中反复独立抽取无数个不同的训练集 ,分别训练出无数个模型,并将这无数个模型在测试点 处的预测值求算术平均,便得到了该算法家族的期望预测模型(平行宇宙平均模型):
在此基础上,模型在任意测试点 处的期望泛化均方误差可以严格分解为如下三项之和(完整代数证明见 附录 A):
仔细审视上述公式中的每一项,先前的直觉陷阱便迎刃而解:
- 口语中的“拟合得准(残差小)” vs 统计学中的“模型方差 ”: 口语里说的“拟合得准”,指的是在单次特定训练集 上,训练残差 很小。然而请看上式中 的定义——模型方差公式里压根没有出现真实标签 ,也没有出现真实函数 !它衡量的纯粹是“当平行宇宙换一批训练集 时,训出来的模型 围绕其自身平均模型 上蹿下跳的剧烈程度”!
- 为什么第一项 压偏差、第二项 压方差?
- 如果不加任何复杂度约束(),让高次多项式或深树死命迎合单批数据 上的每一个含噪点,虽然在每个宇宙内部训练误差均为 ,且无数个宇宙的平均曲线 确实贴近真实规律 (偏差 ),但第 1 个宇宙的麻花曲线 与第 2 个宇宙的麻花曲线 长得面目全非(模型方差 彻底爆炸);
- 当引入结构风险惩罚 (踩刹车限制复杂度)后,算法不再允许模型为了迎合个别噪声点而急转弯,不同宇宙训出的曲线 被死死收拢在平均曲线 周围——虽然平均曲线稍微变平缓了一点点( 微升),但跨数据集的剧烈摇摆()被大幅削平,从而令总泛化误差达到极小!
把前四站的算法放置在“模型复杂度 — 偏差/方差”的二维光谱上,就能自上而下看懂为什么不同算法需要截然不同的驯服手段:
- 高偏差、低方差阵营(先天老实,怕欠拟合):
- 代表:线性回归、逻辑回归、浅层决策树桩(Stumps,深度为 1~3 的树)。
- 演化出路(扩充假设空间 ,向偏差开战):
- 给线性模型手动构造交叉特征、多项式升维,或引入核技巧(SVM)将其弹射至无穷维空间;
- 给浅层决策树桩引入 Boosting(GBDT / XGBoost),用一队短小精悍的弱学习器串联接力,每一棒专门修补前一棒留下的负梯度残差,从而将系统性偏差一步步削平。
- 低偏差、高方差阵营(先天狂野,怕过拟合):
- 代表:高次多项式回归、极大宽度 的高斯核 SVM、不剪枝的完全生长深决策树。
- 演化出路(强化先验约束 或统计平均,向方差开战):
- 在参数空间施加贝叶斯先验约束球(Ridge / Lasso 正则化)或最大化几何间隔(SVM 惩罚);
- 对完全生长的深树引入 Bagging 与随机森林(Random Forest)——既然模型方差源于“单个训练集 的抽样抖动”,那就直接模拟平行宇宙抽样!利用 Bootstrap 样本重采样与节点特征子空间抽样,在压低树间相关系数 的前提下对 棵深树求平均(直接逼近 ),在不牺牲低偏差的同时硬生生把狂野的方差压下去。
2.2 实战选型的“第一性原理”:什么时候该用谁?
脱离数据形态谈算法优劣都是耍流氓。掌握了前四站的几何与统计底牌后,面对真实工业界问题,我们可以直接按数据流形与业务约束给出清晰的技术选型判据:
| 决策维度 | 线性模型 (LR / Ridge / Lasso) | 核支持向量机 (RBF-SVM) | 树与集成模型 (RF / GBDT / XGBoost) |
|---|---|---|---|
| 最擅长的数据形态 | 超高维稀疏数据(如早期 NLP 词袋/TF-IDF 特征,)、强线性因果关系 | 中小样本()、特征同构且经严格归一化的连续非线性流形 | 异构表格数据(Tabular Data):量纲悬殊、含类别枚举与大量缺失值 NaN |
| 对特征工程的依赖 | 极高(需手动归一化、分箱、处理缺失值、构造交叉项) | 高(对量纲与异常值极其敏感,必须做标准化 StandardScaler) |
极低(天然免疫任意严格单调变换,内置缺失值默认路由与高阶特征交互) |
| 趋势外推能力 (Extrapolation) | 强(沿斜率向未见过的数值区间自然线性延伸) | 无(远离支持向量后高斯核衰减为 ,回归至常数偏置 ) | 绝对为零(叶节点局部常数近似,跨出训练集历史极值范围后输出彻底锁死为水平线) |
| 计算复杂度与扩展性 | 极快,,支持在线流式更新(SGD) | 慢,训练需存储与分解 核矩阵,耗时 ,大样本算不动 | 快(尤其 XGBoost 分位数直方图与并行寻优),工业级海量表格首选 |
| 可解释性与合规审计 | 极高(权重 直接对应特征边际贡献与 Odds Ratio,风控评分卡最爱) | 差(高斯核映射到无穷维,无法直观解释单个原始特征的增减效应) | 中高(支持特征重要性排序与 TreeSHAP 归因,但百棵树叠加不如线性评分卡直观) |
3. 半个世纪的恩怨情仇:传统机器学习演进史(1950s–2010s)
许多初学者在翻看教材时,常把这些算法当成同时代并列发明的工具;实际上,它们是一场横跨半个多世纪、历经多次学术王朝更替的思想接力赛。梳理这段历史,能帮我们看清每一个算法究竟是为了解决上一代人的什么绝境而诞生的:
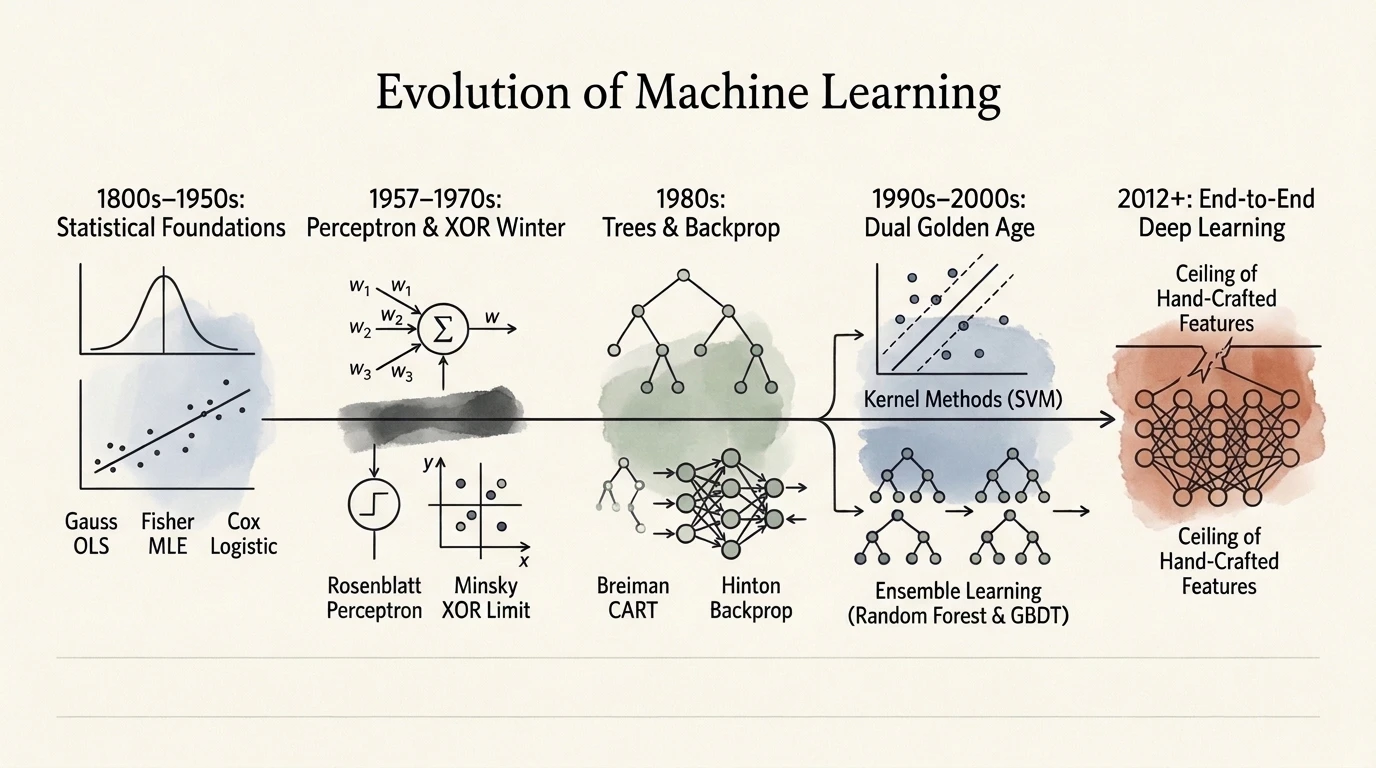 图:机器学习从古典统计学奠基、感知机寒冬、1990s 核方法与集成学习双雄争霸,直至 2012 年 ImageNet 端到端表征学习破局的半世纪演进脉络。
- 1800s–1950s(古典统计学的奠基): 高斯(Gauss)与勒让德(Legendre)为测算天体轨道发明了最小二乘法(OLS);20 世纪初,费雪(R. A. Fisher)爵士一举创立极大似然估计(MLE)与线性判别分析(LDA);1958 年,统计学家 David Cox 提出逻辑回归(Logistic Regression),用对数几率(Logit)完美打通了线性代数与伯努利概率分布。
- 1957–1970s(感知机狂潮与正则化的诞生): 1957 年,心理学家 Frank Rosenblatt 受到生物神经元启发,造出了硬件实现的感知机(Perceptron),《纽约时报》甚至预言它很快能学会行走与思考。然而 1969 年,AI 先驱 Marvin Minsky 与 Seymour Papert 出版了著名的《Perceptrons》一书,用极其严密的数学证明给狂热浇下一盆冰水:单层感知机本质上只是一个线性分类器,连最简单的 4 个点“异或(XOR)”问题都永远无法切开! 这一论断直接将神经网络打入长达十余年的“第一次 AI 寒冬”。与此同时,统计学家 Hoerl 与 Kennard(1970)为解决共线性矩阵求逆崩溃问题,提出了岭回归(Ridge Regression, 正则化)。
- 1980s(决策树成型与神经网络的短暂复兴): 1984 年,统计学家 Leo Breiman 等四人合著出版《Classification and Regression Trees》(CART),奠定了现代二叉树正交切分与剪枝的基石;1986 年,Rumelhart、Hinton 与 Williams 重新发明并普及了多层神经网络的反向传播算法(Backpropagation, BP),证明加一层隐藏层就能解开 XOR 死局。但受限于当时的算力匮乏、数据稀缺以及深层网络严重的梯度消失(Vanishing Gradient)与非凸局部极小值困扰,训练超过 3 层的神经网络如同玄学。
- 1990s–2000s(SVM 与集成学习的“双雄黄金时代” —— 第二次寒冬中的绝对统治):
就在多层神经网络陷入泥潭之际,两大具备坚实数学保障的门派横空出世,彻底统治了机器学习界长达二十年:
- 左路(几何与凸优化之巅):1992–1995 年,Vladimir Vapnik 与 Corinna Cortes 将最大间隔超平面、拉格朗日对偶与核技巧(Kernel Trick)完美融合,推出支持向量机(SVM)。当时的学术界对 SVM 佩服得五体投地:它既有核函数带来的无穷维非线性拟合能力,又是一个严格的凸二次规划问题(全局最优解唯一,绝不陷入局部极小值)!在手写数字识别(MNIST)和文本分类上,SVM 把早期的神经网络打得毫无还手之力。同年(1996),Robert Tibshirani 提出 Lasso( 正则化),开启了高维稀疏统计学习的浪潮。
- 右路(集成学习王朝):1996 年,Leo Breiman 提出 Bagging,并于 2001 年加入特征随机子空间正式发明随机森林(Random Forest);几乎同一时期,Yoav Freund 与 Robert Schapire(1995)提出 AdaBoost,随后统计学家 Jerome Friedman(1999/2001)高屋建瓴地指出 Boosting 的本质是函数空间中的梯度下降,正式创立 GBDT(Gradient Boosting Decision Trees);2014–2016 年,陈天奇推出引入二阶泰勒展开、结构正则化与极致系统工程优化的 XGBoost,将表格数据建模推向了工业界的终极巅峰。
4. 传统机器学习的“阿喀琉斯之踵”:为什么历史必然走向深度学习?
既然 SVM 拥有完美的凸优化理论与无穷维核映射,GBDT / XGBoost 又在各类数据竞赛中大杀四方,为什么到了 2010 年代,人工智能的历史车轮没有停留在第四站,而是猛烈地转向了深度神经网络?
要回答这个根本问题,我们必须审视前四章所有算法共同签署的那份“底层契约”。
4.1 传统 ML 的底层契约:特征提取 与分类决策 的彻底割裂
无论是逻辑回归、SVM 还是 GBDT,它们在工作时都默认了一个前提:输入给算法的向量 ,其每一个维度都已经具备了相对明确的物理或统计语义(或者通过预设的固定公式完成了转换)。
在数学形式上,传统机器学习的预测函数始终可以写成:
在这份契约下,当面对复杂的现实世界时,人类只有两条路可走:
-
第一条路:固定数学核映射(以 SVM 为代表) SVM 说:“你不用手写 ,我直接用一个通用的高斯核 帮你隐式映射到无穷维!”
- 致命死穴 1(各向同性的盲目距离):高斯核衡量两个样本是否相似,唯一依据是它们在原始输入空间里的欧氏距离 。对于一张 的猫咪照片,如果把整张图片往右平移仅仅 个像素,或者把背景从白色草地换成暗色地毯,两张图片对应像素相减的平方和 会瞬间变得极大!在高斯核眼里,这两张明明是同一只猫的照片“距离十万八千里,毫不相干”。固定核函数没有任何能力从原始像素中提炼出对平移、旋转、光照不敏感的“高层语义不变量”。
- 致命死穴 2(核矩阵的算力灾难):核方法必须计算并存储两两样本之间的核矩阵 。当样本量 时,核矩阵只有 个浮点数,毫无压力;但当互联网时代带来 ImageNet 级别的 (一百万)张图片时, 个元素光存进内存就要数千 GB,二次规划求解器彻底瘫痪!
-
第二条路:人工特征工程(Hand-crafted Feature Engineering,2012 年前的工业界常态) 既然算法自己看不懂原始像素和声波,那就只能靠人类领域专家燃烧脑细胞,手写代码把原始信号 翻译成特征向量 ,再喂给 SVM 或 GBDT:
- 计算机视觉(CV)专家:耗费十几年青春,基于微积分与方向梯度直方图,手工设计出了 SIFT(1999)、HOG(2005)、LBP 等局部边缘与角点描述子;
- 语音识别(ASR)专家:基于人类耳蜗生理结构与傅里叶变换,手工设计了 MFCC(梅尔频率倒谱系数);
- 自然语言处理(NLP)专家:手工统计词频 TF-IDF、-gram 词袋、手工编写句法依存树规则。
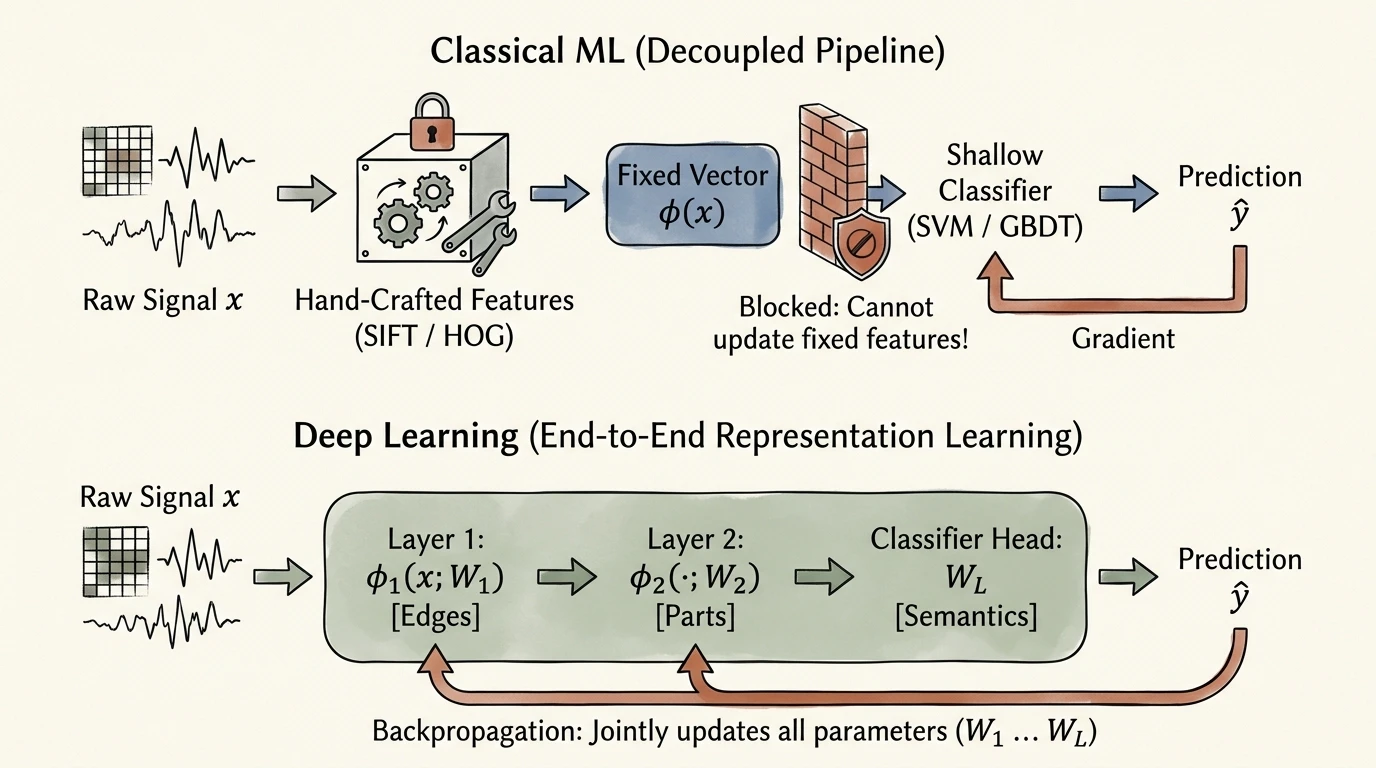 图:传统机器学习“人工特征工程 + 浅层分类器”割裂流水线(上)与现代深度学习“多层可微参数化表征 + 反向传播端到端联合优化”流水线(下)的本质区别。
4.2 认知破局:什么是“端到端表征学习(End-to-End Representation Learning)”?
看懂了上面的对比图,你就看懂了深度学习革命的全部灵魂。
在传统机器学习流水线中,“特征提取 ”和“分类器训练 ”是完全割裂的两张皮:当最后的 SVM 或逻辑回归预测错了,产生的误差信号只能用来调整分类超平面的权重 ,却没有任何通道能倒推回去修改人类专家写死的 SIFT 算子或高斯核公式!如果人类专家漏掉了某个关键的纹理特征,哪怕后面的分类器优化到数学极致,整体准确率也依然卡死在天花板上。
于是,以 Geoffrey Hinton、Yann LeCun、Yoshua Bengio 为代表的一小撮“连接主义固执派”提出了一个振聋发聩的构想:
为什么不把特征变换 本身,也变成由可学习参数矩阵 组成的层级函数?
在这个多层复合函数里:
- 没有人工特征工程:直接把最原始的像素矩阵、音频波形或文本 Token 喂给第一层 ;
- 层级语义自动涌现:第 1 层参数 自动学会提取各个方向的微小边缘;第 2 层 把边缘拼成拐角、圆弧和局部网格纹理;第 3 层把纹理拼成“猫耳朵、车轮、眼睛”;最后一层分类头 在这个高度提纯的高层语义空间里,只需要画一条极其简单的线性超平面,就能轻松完成分类!
- 端到端联合求导:从输入端(Raw Input)到输出端(Prediction),整条流水线全部由连续可微的矩阵乘法与非线性激活函数焊接而成。一旦预测出错,损失函数的梯度可以顺着复合函数的链条一路反向传到底层,告诉每一层:“为了减少最终的分类误差,第 1 层的边缘检测器该往左微调 ,第 2 层的纹理组合器该把权重放大 !”
4.3 为什么表格数据留在了第四站,而感知世界跨入了第六站?
站在今天(大模型与深度学习全面繁荣的时代)回望,我们终于可以用一套极其自洽的认知框架,同时解释两个看似矛盾的现象:
- 为什么在图像、语音、自然语言(同构感知数据)上,深度学习彻底埋葬了传统特征工程 + SVM? 因为感知数据的单个维度(单个像素、单个采样点)毫无独立语义,真正的语义隐藏在成千上万个像素跨越空间与尺度的层级组合结构(Hierarchical Compositionality)之中。靠人类专家手写公式去穷举这种高阶组合,无异于用算盘去模拟量子力学;而多层神经网络层层递进的复合映射,恰好与物理世界“像素 边缘 部件 物体”的生成结构同构!
- 为什么在金融风控、电商转化、医疗临床(异构表格数据)上,第四站的 GBDT / XGBoost 至今依然能与深度神经网络分庭抗礼甚至胜出?
因为在表格数据里,“特征工程 / 表征提纯”这一步,其实早就被人类的商业制度和数据库建表过程提前完成了!表格里的每一列(“近 30 天逾期次数”、“历史客单价均值”、“年龄”)本身就已经是高度浓缩的高层业务语义,不再需要通过 10 层矩阵乘法去从零拼凑“边缘和纹理”。更进一步,正如实证研究(如 Grinsztajn et al., NeurIPS 2022,《Why do tree-based models still outperform deep learning on typical tabular data?》)所揭示的,这并非出于工业界的历史惯性或单纯为了可解释性,而是因为深度神经网络的底层归纳偏置在面对商业表格时存在三大结构性水土不服(详见第四篇 1.1 节):
- 平滑谱偏置(Spectral Bias)vs. 制度性阶梯悬崖:神经网络由连续矩阵乘法与光滑激活函数复合而成,天然偏好拟合低频平滑曲面;然而商业与社会数据深受人类制度与系统硬阈值干预(例如银行信贷逾期满 90 天触发征信黑名单与强制抽贷、电商满 200 减 30 门槛、从 次违约到 次违约的定性跃迁),真实目标函数充满高频、非平滑的直角阶梯突变(Step Cliffs)。正交切分决策树用轴平行指示函数 一刀即可精准贴合悬崖,而神经网络则需堆叠大量平滑曲线勉强逼近,极易在边界处产生剧烈震荡。
- 全连接旋转混杂 vs. 单列赢家通吃的抗噪稀疏性:真实业务宽表往往混有大量弱相关或纯噪声冗余列。神经网络第一层全连接运算 在入口处便将所有特征列线性混杂求和;在有限训练样本下,梯度下降会利用冗余列上的巧合伪相关(Spurious Correlation)为其分配微小非零权重,导致测试期成百上千个微小噪声项累加引爆方差。相反,决策树在每个节点采用“单列比武选秀”机制(仅挑选信息增益或二阶泰勒增益 最高的那唯一一列切分,配合分裂阈值 剪枝),使无意义的噪声列全程无法入选、权重严格归零,从而天然免疫冗余特征干扰。
- 脏数据鲁棒性、可解释合规与百倍工程性价比:树模型仅依赖特征排序次序(天然免疫极端金额长尾分布)且内置缺失值
NaN默认路由,配合 TreeSHAP 可满足金融医疗严苛的监管归因审计,并在普通 CPU 上以百倍于神经网络的迭代速度取得顶尖泛化精度。(注:唯有当电商推荐场景引入“十亿级稀疏商品/用户 ID + 变长历史行为序列 + 图文多模态”时,工业界才会转向 Embedding + Attention 的深度推荐架构或 GBDT + 神经网络混血流水线)。
5. 本章核心总结与认知闭环
| 核心命题 | 认知升维总结 |
|---|---|
| 传统 ML 的大一统本质 | 前四站所有模型均可收敛至结构风险最小化 。第一项倾听样本证据以压低偏差(Bias),第二项注入先验偏好以约束复杂度、压低方差(Variance);各流派本质上是在该母方程下对 做模块化“解压缩”。 |
| 三大门派的几何与统计分工 | 线性模型守住高维稀疏、趋势外推与强可解释性底线;SVM 凭借核技巧与凸对偶统治中小样本连续非线性战场;决策树与集成学习(RF 降方差、GBDT/XGBoost 降偏差)依靠正交分治与单调不变性稳坐异构表格数据王座。 |
| 传统 ML 的底层枷锁 | 传统模型默认输入特征 已具备高层语义,或依赖固定核映射 与人工特征工程(SIFT/HOG/MFCC)。特征提取与分类决策彻底割裂,误差梯度无法穿透回特征提取端,且固定欧氏距离核无法捕获同构感知信号的高层空间不变量。 |
| 深度学习的范式跃迁 | 将特征变换本身参数化为多层复合映射 ,通过非线性激活打破线性坍缩,并借助反向传播实现从原始信号到最终预测的端到端联合表征学习。 |
从本章迈向下一站:打破传统机器学习的“固定特征契约”、迈向多层可学习表征的神经网络时,两座横亘在数学与计算上的大山立刻扑面而来——其一是几何与代数的“线性坍缩”死局(纯矩阵连乘 必然退化为单层线性模型,非线性激活函数 如何施展“空间折纸术”切开异或 XOR 死局?);其二是百万级复合函数的“学分分配难题”(计算图与反向传播自动微分如何仅用约 1~2 次前向传播的算力代价求出全网精确偏导数?)。这两大问题正是第六站的核心焦点。
附录 A:泛化误差的偏差-方差分解(Bias-Variance Decomposition)严格数学推导
为了在数学底层彻底厘清 第 2.1 节 中“期望泛化误差 = 偏差平方 + 模型方差 + 不可约噪声”的来龙去脉,下面给出无跳步的完整代数证明。
A.1 基本假设与符号定义
- 真实数据生成机制:设在测试输入点 处,真实观测标签 由底层确定性真值函数 与加性随机噪声 生成: 其中噪声满足零均值假设 ,且方差为 。
- 基于随机训练集 的预测模型:设 为从总体分布中独立同分布抽取的容量为 的训练集。学习算法在 上训练得到的模型记为 (简记为 )。注意: 是关于随机变量 的随机函数,且训练集 与未来测试点上的观测噪声 相互独立。
- 平行宇宙平均模型(期望预测):对所有可能抽取的训练集 求数学期望,定义算法在 处的平均预测值为: (注意: 与 均为剥离了随机变量 和 后的确定性常数)。
A.2 第一步:剥离测试集不可约噪声
考察模型在测试点 处的期望泛化均方误差 。将 代入并把括号改写为 展开: 由于训练集 与测试点噪声 相互独立,中间交叉项的期望可拆分为乘积: 同时由 ,第一阶段化简为:
A.3 第二步:引入平均模型 拆解偏差与方差
针对第一项 ,在括号内部施展经典的“加一项 再减一项 ”恒等变形: 将其平方展开并对 求期望(注意 对 而言是常数,可直接移出期望号): 根据期望的线性性质与 的定义,右侧交叉项中的期望恒等于零:
A.4 终局合体
将上述两步结果合并,即证得统计学习理论中最核心的偏差-方差分解定理: