本篇导读:在第五篇的收官之际,我们剖析了传统机器学习“固定特征提取 + 浅层分类器 ”底层契约在同构感知信号面前的结构性失效,并提出了将特征变换本身参数化为多层复合映射 的端到端表征学习构想。然而,从单层模型迈向多层网络并非简单的矩阵堆叠,它必须正面闯过两道决定生死的数学关卡:其一是几何与代数的“线性坍缩”死局(为什么不加非线性激活,叠一万层矩阵也依然切不开 4 个点的异或 XOR 问题?);其二是百万级嵌套参数的“学分分配难题”(如何在不计算百万次数值差分的前提下,仅以约等于一次前向传播的算力代价求出全网所有权重的精确偏导数?)。本篇将从 1969 年感知机寒冬的 XOR 公案出发,通过手算两层网络的“空间折纸术”建立深度表征的几何直觉,剖析从 Sigmoid 梯度消失到 ReLU 绿色通道的演进逻辑,随后以计算图(Micrograd 思想)与矩阵微积分彻底打通反向传播(Backpropagation)的四大核心方程,最后补齐现代深层网络得以稳定收敛的三大工程支柱(动量与自适应优化器 Adam、Xavier/He 方差守恒初始化、Dropout 隐式集成与归一化)。
1. 感知机的寒冬与“线性坍缩”死局:为什么不能只是把矩阵叠起来?
1.1 1969 年的 XOR(异或)公案:四颗点引发的第一次 AI 寒冬
回到 1957 年,心理学家 Frank Rosenblatt 模仿生物神经元的“树突加权求和 — 细胞体阈值点火”机制,提出了人工智能史上的鼻祖模型——单层感知机(Perceptron):
站在我们已经学完前五站的视角回看,单层感知机毫无神秘感:它的决策边界 就是第一站逻辑回归和第三站线性 SVM 里的那张平直超平面。
1969 年,人工智能先驱 Marvin Minsky 与 Seymour Papert 在《Perceptrons》一书中,摆出了一个仅有 2 个二进制输入变量 、总共只有 4 个样本点的极简逻辑运算表:
| 样本坐标 | 逻辑与 | 逻辑或 | 逻辑异或 (相同为 0,不同为 1) |
|---|---|---|---|
| (负类) | |||
| (正类) | |||
| (正类) | |||
| (负类) |
- 对于 (与) 和 (或),正负样本分别聚集在正方形的一角或一侧,随便画一条直线(例如 或 )就能轻松将 和 切开;
- 但对于 (异或),两个负类点 和 占据了主对角线,两个正类点 和 占据了副对角线——正负阵营呈十字交叉犬牙交错!
我们可以用两行初等不等式严格证明“单层线性分类器绝对切不开 XOR”: 假设存在一组权重 能将 XOR 正确分类,则对四个点必须同时满足:
- 为负类
- 为正类 ; 为正类 。两式相加得:
- 为负类 。结合第 1 式的 ,立刻推出 ,与第 2 式正面矛盾!
这个看似玩具般的反例,在当年却引发了地震:连“两个开关状态是否不同”这种最基础的逻辑判断都学不会,单层神经网络怎么可能模拟人类智能?
1.2 代数上的“线性坍缩(Linear Collapse)”:叠一万层线性矩阵等于只叠一层
面对单层感知机的困境,一个最自然的直觉是:既然一层权重矩阵 不够用,那我们像搭积木一样,连续串接三层、十层甚至一万层权重矩阵,能不能画出弯曲的决策边界?
不妨动手算一下。假设我们构建一个两层纯线性网络:
- 第一层(隐藏层):将输入 映射为隐藏向量 ;
- 第二层(输出层):将隐藏向量 映射为输出 。
将第一层的表达式直接代入第二层,利用线性代数的矩阵乘法结合律与分配律:
同理,哪怕你串联 层纯线性矩阵变换:
第一大生死劫(线性坍缩定理): 在线性代数中,任意有限个线性变换的复合,依然是一个纯粹的线性变换。如果层与层之间没有插入非线性激活函数(Non-linear Activation Function),那么无论你在硬件上堆叠多少层隐藏层、耗费多少亿次矩阵乘法,整个深度网络在数学表达能力上都会瞬间坍缩回第一站的单层线性模型,依然画不出哪怕一道最轻微的弧线,依然在 4 个点的 XOR 面前束手无策!
2. 破除第一劫:非线性激活函数与高维“空间折纸术(Space Folding)”
要在层与层之间阻断矩阵乘法的结合律,唯一的办法是在每一次线性变换 之后,强行套上一层逐元素非线性激活函数 :
此时,由于非线性壳子 的阻隔, 无法再穿过 与 相乘合并(),每一层才真正拥有了不可替代的独立表征意义。
[!NOTE] 深度附注:为什么线性代数的“美妙结合律”成了诅咒?以及为什么 被称为“激活函数(Activation Function)”?
- 结合律的双刃剑:在经典物理与工程计算中,矩阵乘法结合律是天赐的福音——哪怕系统经历了 步线性变换 ,也可预先相乘坍缩为单个矩阵 一步算完。但在表征学习中,我们恰恰追求“像素边缘 局部拐角 器官部件 整体语义”的层级涌现(Hierarchical Abstraction)。“允许被结合律化简”在数学上等价于“所有中间层级皆为冗余假象”。因此,唯有在层间插入破坏线性结合律的非线性函数,深度(Depth)才不会坍缩为宽度。
- “激活(Activation)”二字的生物溯源与现代门控实质:
- 神经生物学溯源:在 1943 年 McCulloch-Pitts 神经元模型中,生物神经元平时处于约 的静息电位(静默状态);当树突收集的加权总电位 冲破阈值时,细胞膜离子通道打开并触发一次动作电位脉冲(Neuron Activation,神经元激活/点火)。早期阶跃函数与 Sigmoid 正是对“点火放电率”的数学模拟。
- 现代表征学习的“特征探针门控”:脱离仿生学后,“激活”一词在现代深网(尤其是 ReLU)中演化出了更精准的几何含义。隐藏层的每个神经元本质上是一个特征探针(Feature Detector):第一步线性内积 计算输入信号与探针模板的匹配打分;若未侦测到目标模式(),如果不加截断,负向分值会直接流入下游造成噪声干扰。激活函数 充当了门控开关(Gatekeeper)——未匹配时()保持静默熄灭(输出 ),仅在侦测到目标特征时()将该神经元点亮(Activate)并向后传递信号强度。
2.1 手算破解 XOR:两层网络是如何把不可分平面“对折”成线性可分的?
很多教材在讲多层感知机解决 XOR 时,只给出“画两条线再求交集”的布尔逻辑解释;实际上,从表征学习(Representation Learning)的几何空间变换视角来看,隐藏层做了一件极其惊艳的事——空间折纸术(Space Folding)。
让我们亲手构造一个极简的两层网络,选用现代深度学习最常用的 ReLU(修正线性单元)激活函数:
我们在第一层(隐藏层)设置 2 个神经元 ,令权重矩阵与偏置为:
现在,把原始空间 里的 4 个异或样本逐一代入,看看它们在新的隐藏层特征空间 里变成了什么坐标:
| 原始输入 | 真实类别 | 线性预激活 | 线性预激活 | 隐藏层新表征 | 输出层打分 |
|---|---|---|---|---|---|
| (负类) | |||||
| (正类) | |||||
| (正类) | (与上一行完全重合!) | ||||
| (负类) |
请盯住表格的第 5 列(隐藏层新表征)!奇迹发生了:
- 在原始空间里,两个正样本 和 隔着负样本对角线遥遥相望,导致任何直线都无法将它们归入同一侧;
- 而经过隐藏层 的旋转投影,再被 在 处一刀截断折弯后,原本天各一方的两个正样本 和 ,在新的表征空间 中像折纸一样严丝合缝地折叠重合到了同一个坐标点 上!
- 此时,在 平面上,正样本位于 ,而两个负样本分别位于 和 。第二层(输出层)只需要画一条最普通的线性超平面 ,不仅能一刀切开正负样本,甚至让四个点的预测输出精确等于 !
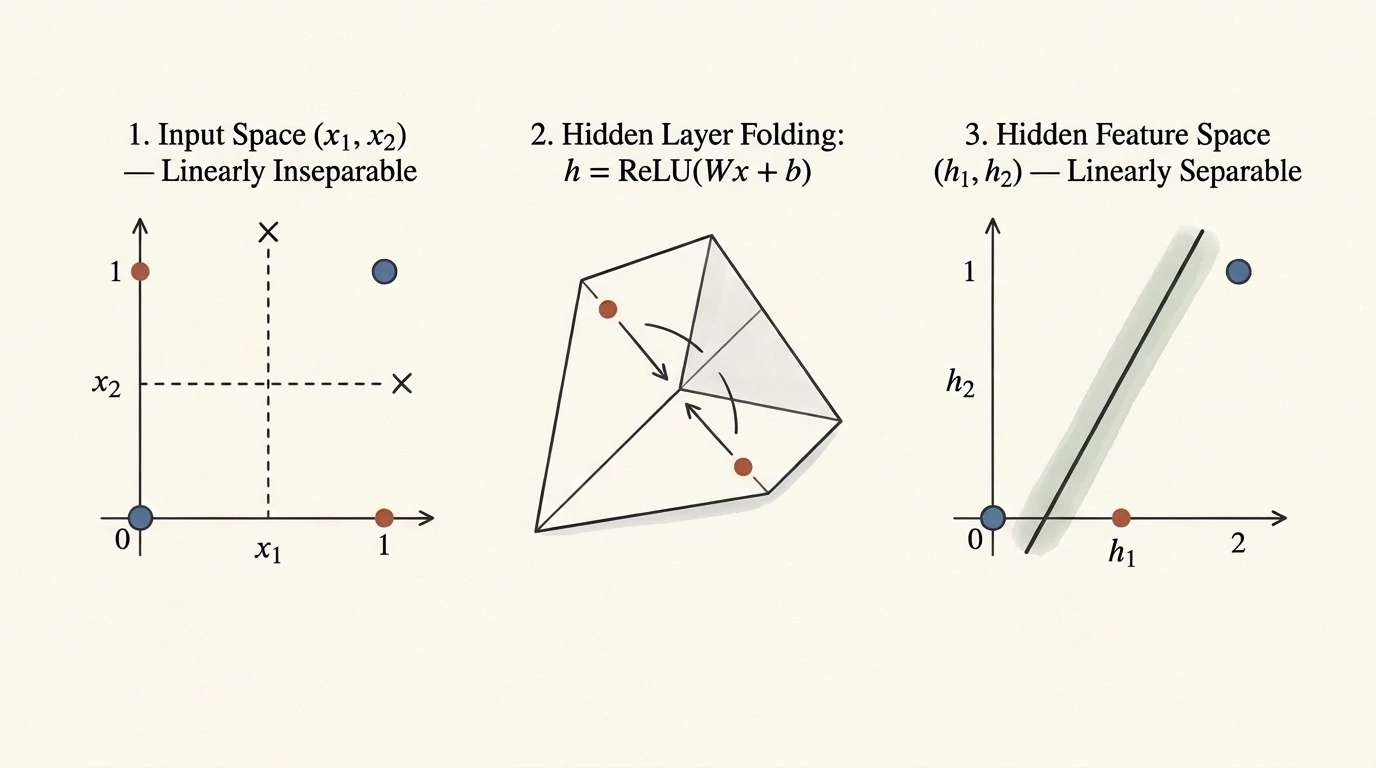 图:两层神经网络攻克 XOR 异或难题的“空间折纸术(Space Folding)”几何全貌。左图:原始输入空间 中正负样本呈对角线犬牙交错,任何单条直线均无法切开;中图:隐藏层 沿折痕超平面对特征空间实施非对称折叠;右图:在折叠后的隐藏表征空间 中,原本分离的两个正样本 与 重合至 ,仅用一条平直超平面即可轻松实现线性可分。
2.2 与第三站 SVM 的巅峰对话:核技巧“固定升维” vs. 神经网络“可学习折纸”
看到这里,不妨将第六站的多层神经网络与第三站的核支持向量机(Kernel SVM)做一次深度的几何对撞:
- 两者的终极目的一模一样:都是为了把原始空间里犬牙交错、线性不可分的复杂流形,变换到一个新的特征空间 ,使得在最后一层只需画一张平直的线性超平面 就能切开正负样本。
- 两者的实现路径截然不同:
- SVM 走的是“固定解析升维”:依靠人类预设的固定核函数(如多项式核或高斯核),不管三七二十一,直接把二维平面按固定公式撑高到三维抛物面乃至无穷维空间。它不会根据当前任务的特定语义去调整升维的方式。
- 深度神经网络走的是“参数化层级折纸”:甚至不需要增加空间维数(刚才 XOR 的例子里,输入是 2 维,隐藏层依然是 2 维!)。每一层变换 都分解为三步基本几何体操:
- 乘矩阵 :对空间进行旋转、缩放与剪切(仿射变换);
- 加偏置 :将空间平移,把需要折叠的部位对准坐标轴原点;
- 过非线性激活 :沿着坐标轴把负半区压平或折弯(制造一道折痕)。
- 深度(Depth)的指数级威力:如果把一张纸对折 次,一刀剪下去只能剪出 段折线;如果连续对折 次(对应 层深度神经网络),最后一刀线性切分展开回原始输入空间时,切出的是高达 个分段线性区域!这就是为什么“深而窄”的网络比“浅而宽”的网络在捕获复杂层级结构时具备指数级的参数效率优势。
2.3 激活函数的演进史:从 Sigmoid 梯度消失到 ReLU 的大道至简
既然只要是个非线性函数就能打破“线性坍缩”,那么在过去四十年里,为什么深度学习界会经历一场从 Sigmoid Tanh ReLU(及 GELU/SwiGLU) 的大迁徙?
早期的连接主义学者(1980s–1990s)为了模仿生物神经元“放电频率在 到 之间饱和”的生理特征,并且受第一站逻辑回归的启发,顺理成章地把 Sigmoid 函数塞进了每一层隐藏层:
在第一站里,Sigmoid 放在最后一层用来把实数打分压成 概率,表现堪称完美(且其导数 刚好能与交叉熵损失的分母约掉,梯度极其清爽)。然而,一旦把 Sigmoid 塞进 5 层以上的隐藏层内部,两个致命的数学诅咒立刻爆发:
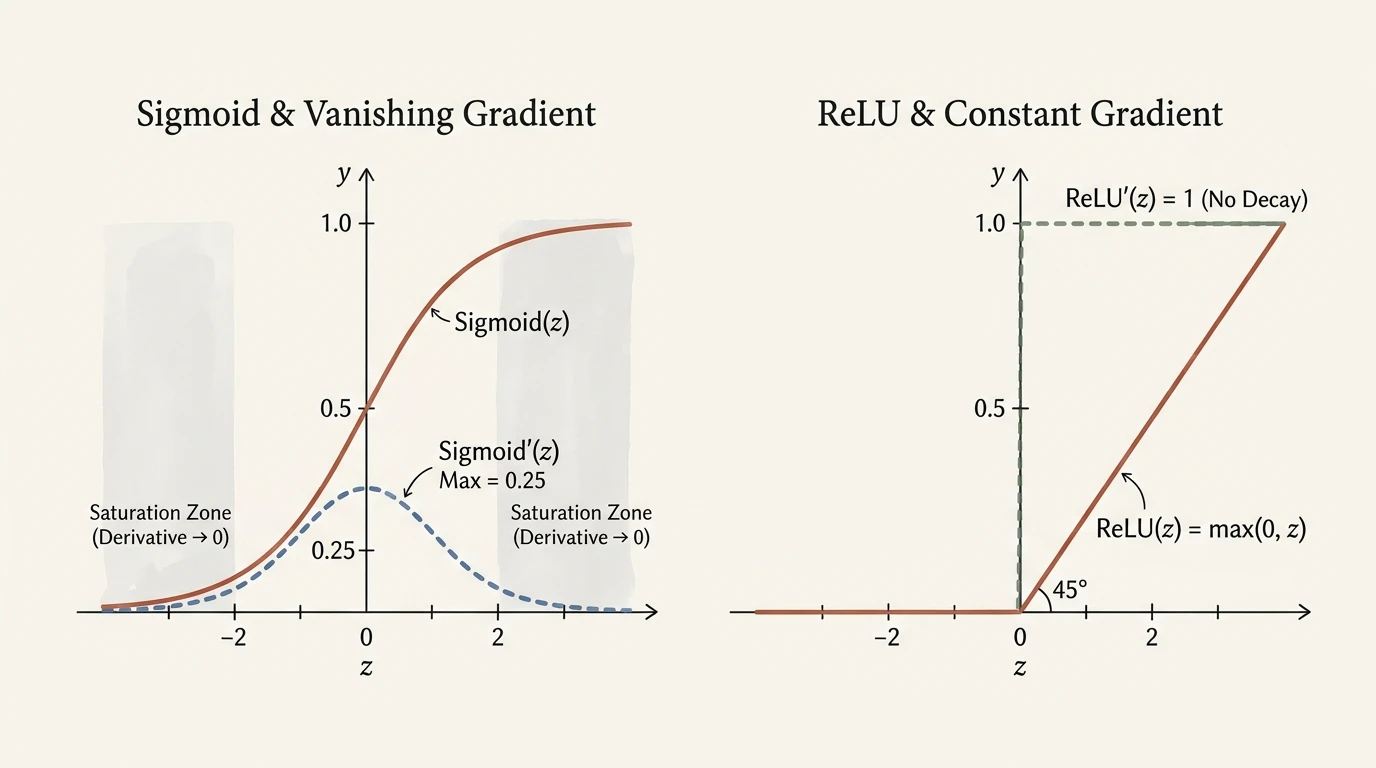 图:Sigmoid 与 ReLU 激活函数及其导数曲线的正面对比。左图:Sigmoid 函数的导数 呈钟形,即使在原点 处其导数极大值也仅为 ,而在 的两端饱和区导数迅速衰减至 ,导致多层连乘后产生毁灭性的“梯度消失”;右图:ReLU 函数在正半轴 保持恒定斜率 ,为误差梯度的跨层反向传播开辟了无衰减的绿色通道。
- 致命诅咒一:梯度消失(Vanishing Gradient)—— 的连乘绞杀
请看上图左侧 Sigmoid 的导数曲线 :
- 根据均值不等式 ,当且仅当 (即 )时,Sigmoid 的导数取得全局最大值,而这个最大值仅仅只有 !
- 一旦神经元输入稍大或稍小(比如 ),神经元进入两端平坦的饱和区(Saturation Zone),此时导数 。
- 在下一节我们将看到,反向传播求第 1 层权重的梯度时,必须把后面每一层激活函数的导数连乘起来:。就算每一层神经元都奇迹般地刚好落在导数最大的 处,经过 层隐藏层连乘后,梯度信号也会萎缩为:
- 结果就是:靠近输出层的第 9、10 层还在正常更新,而靠近输入层的第 1、2、3 层收到的梯度几乎全是 ,底层参数纹丝不动!这就是为什么在 2006 年之前,人类怎么也训不动超过 4 层的神经网络。
- 致命诅咒二:非零均值输出(Non-zero Centered Output)引发的锯齿震荡 Sigmoid 的输出恒为正数()。由于下一层权重矩阵 的梯度等于 ,当上一层输出全为正数时,当前神经元所有权重分量的梯度必然同正或同负(要么全增加,要么全减小),迫使参数更新只能沿着对角线象限走低效的“Z 字锯齿路线”(随后人们引入输出在 之间的双曲正切函数 ,虽解决了零均值问题并将最大导数提升至 ,但两端饱和区的梯度消失依然无解)。
直到 2010–2012 年(Nair & Hinton, 2010; AlexNet, 2012),深度学习界完成了一次“大道至简”的范式切换——彻底抛弃平滑的 S 型曲线,全面换用看似简陋的折线函数 ReLU(Rectified Linear Unit):
ReLU 凭什么一举救活了深层神经网络?
- 正半轴导数恒为 (无损梯度高速公路):只要神经元处于激活状态(),无论 是 还是 ,它的局部导数永远是绝对的 !哪怕连乘 层,,误差梯度可以毫无衰减地一路穿透到底层;
- 极致的算力效率与生物稀疏性:Sigmoid 需要计算昂贵的浮点数指数幂 与除法,而 ReLU 仅仅是一条 CPU/GPU 极速指令
if z > 0 then z else 0;同时,负半轴归零使得网络中任意时刻约有一半神经元处于静默状态(稀疏激活),有效降低了特征间的病态耦合。
| 激活函数 | 数学表达式 | 导数取值范围 | 核心优势 | 核心缺陷与适用场景 |
|---|---|---|---|---|
| Sigmoid | 将全实数完美映射为 概率 | 严重梯度消失、非零均值、指数计算慢;仅用于二分类输出层或门控开关(LSTM/Attention Gate) | ||
| Tanh | 零均值输出 ,原点处导数为 | 两端饱和区依然梯度消失;常用于早期 RNN 状态更新 | ||
| ReLU | 正半轴导数恒为 不衰减、计算极快、稀疏激活 | 负半轴梯度为 ,若学习率过大导致权重跌入负区将永久无法复苏(Dead ReLU 神经元坏死) | ||
| Leaky ReLU / GELU | 或 | 负轴保留微小斜率 | 保留正轴无损传导的同时,彻底根治神经元坏死并在原点处平滑可导 | GELU / SwiGLU 是当今 GPT、Llama 等大语言模型(Transformer)的绝对标配 |
[!NOTE] 历史公案:既然 1991 年就确诊了“梯度消失”,为什么学界苦等 20 年才敢换上极简的 ReLU? 早在 1991 年,Sepp Hochreiter(LSTM 提出者)便在硕士论文中严格证明了深层网络梯度消失的数学必然性(Bengio 等人于 1994 年进一步发表剖析)。然而,面对初等数学水平的折线函数 ,整个学术界却因三道根深蒂固的认知钢印迟疑了整整二十年:
- 传统优化理论的“光滑可导洁癖”:经典数值优化教科书强调目标函数须处处光滑连续可微()。 在原点 处存在尖锐折角(左导数为 、右导数为 ,在 处不可导),学者们普遍担心非光滑折角会导致梯度下降发生剧烈震荡。直到工程实践证明:连续浮点数运算几乎不可能精确踩中
0.0000000,在原点处简单指定次梯度(Subgradient)为 即可无缝收敛。- 对“左半轴死区”与“右半轴无界爆炸”的双重恐惧:
- 怕死透():研究者认为 Sigmoid 两端导数跌至 已属灾难,若将整个负半轴导数直接砍为绝对的 ,网络岂不当场瘫痪?实则对于任意样本,只要正半轴存活的那一半神经元保持导数恒为 ,误差梯度即可顺着活跃子网组成的绿色通道无损传回底层——“一半绝对畅通()+ 一半静默()”远胜于“全员半死不活()”。
- 怕爆炸():Sigmoid/Tanh 将输出严格关在 或 的安全笼中;而 ReLU 正半轴无上界。在 2010 年 Xavier/He 方差守恒初始化问世前,盲目在多层网络中使用无界激活函数极易引发前向数值指数级膨胀(
NaN),使早期尝试者误以为无界激活函数不可训练。- 对“概率与仿生隐喻”的执念(1995–2010 的两条弯路):连接主义学派长期执着于“隐藏层输出必须代表特征存在的概率 ”。为保住 Sigmoid,学界要么弃坑神经网络转投凸优化的 SVM(1995–2006),要么如 Hinton (2006) 般诉诸繁琐的“受限玻尔兹曼机(RBM)逐层无监督预训练”。直到 Nair & Hinton (2010) 证明无穷多个偏移二元随机神经元的期望叠加可近似为 (赋予其概率论合法性),且 Glorot, Bordes & Bengio (2011) 证实将合理的方差初始化与 ReLU 结合即可抛弃预训练直接训通深层网络,统治学界二十年的 Sigmoid 钢印才宣告粉碎。
3. 破除第二劫:百万参数的“学分分配难题”与反向传播(Backpropagation)
解决了模型的表达能力(非线性折纸)后,我们迎来了深度学习的第二道生死劫:怎么把这成百上千万个嵌套在复合函数里的权重参数 训练出来?
在人工智能史上,这个问题被称为“学分分配难题(Credit Assignment Problem)”:当一个 10 层神经网络最终把一只“猫”错判成了“狗”,产生了误差 ,这场事故的责任(或者说改正错误的功劳),究竟该给第 1 层的第 38 号权重分担多少?给第 5 层的第 1024 号权重分担多少?
从第一站我们已经知道,答案是计算损失函数 对每一个权重参数 的偏导数 ,然后沿着负梯度方向更新:。
3.1 为什么不能用微积分定义里的“数值有限差分法”求导?(算力灾难算账)
一个最自然的直觉疑问是:“求导还不简单吗?高中微积分教过导数的定义,把某个权重 稍微加上一丁点 ,其它权重不动,重新跑一遍网络看看 Loss 增加了多少,除以 不就是偏导数了吗?”
这个办法在数学上完全正确(工程上称为数值梯度 Numerical Gradient,常用来做代码 Debug 梯度检验),但在训练阶段却是一场彻头彻尾的算力灾难!
让我们算一笔极简单的乘法账:
- 假设你的神经网络有 ( 亿)个参数(这在今天甚至算是个很小的模型),跑一次前向传播计算 需要 毫秒( 秒)。
- 如果使用数值差分法,为了求出第 个参数 的偏导数,你要拨动 跑 次前向传播;为了求出第 个参数 的偏导数,你又要拨动 重新跑 次前向传播……
- 为了走仅仅一步梯度下降,你必须把全网 亿个参数挨个拨动一遍,总共要跑 亿次前向传播!耗时 !走一步就要十几天,训练一万步需要三百年!
为什么数值差分法慢得如此荒谬?因为当你拨动第 层的某个权重 时,你大费周章重算了一遍第 层的全部运算;下一秒当你拨动旁边的 时,第 层的传导路径明明一模一样,你却把刚才算过的信息全扔了,又从头重算了一遍!
3.2 计算图(Computational Graph)与链式法则的“接力赛”:Micrograd 思想
1986 年,Rumelhart、Hinton 与 Williams 重新发掘并普及了反向传播算法(Backpropagation,简称 BP,数学本质即反向模式自动微分 Reverse-mode Automatic Differentiation)。它做了一件惊天地泣鬼神的事:
无论你的神经网络有 个参数还是 万亿个参数,反向传播只需要跑“1 次前向传播 + 1 次反向传播”(总计算量仅约为前向传播的 2~3 倍),就能一次性求出损失函数对全网所有参数的精确解析偏导数!
从“ 亿倍代价”直接降维打击到“ 倍代价”,反向传播究竟施展了什么魔法?
答案正如 Andrej Karpathy 在著名的 Micrograd 极简自动微分引擎中所展示的:把庞大的复合函数拆解为一张由原子算子(加、乘、激活)组成的有向无环计算图(Computational Graph),并利用微积分链式法则进行“由果溯因的动态规划接力”!
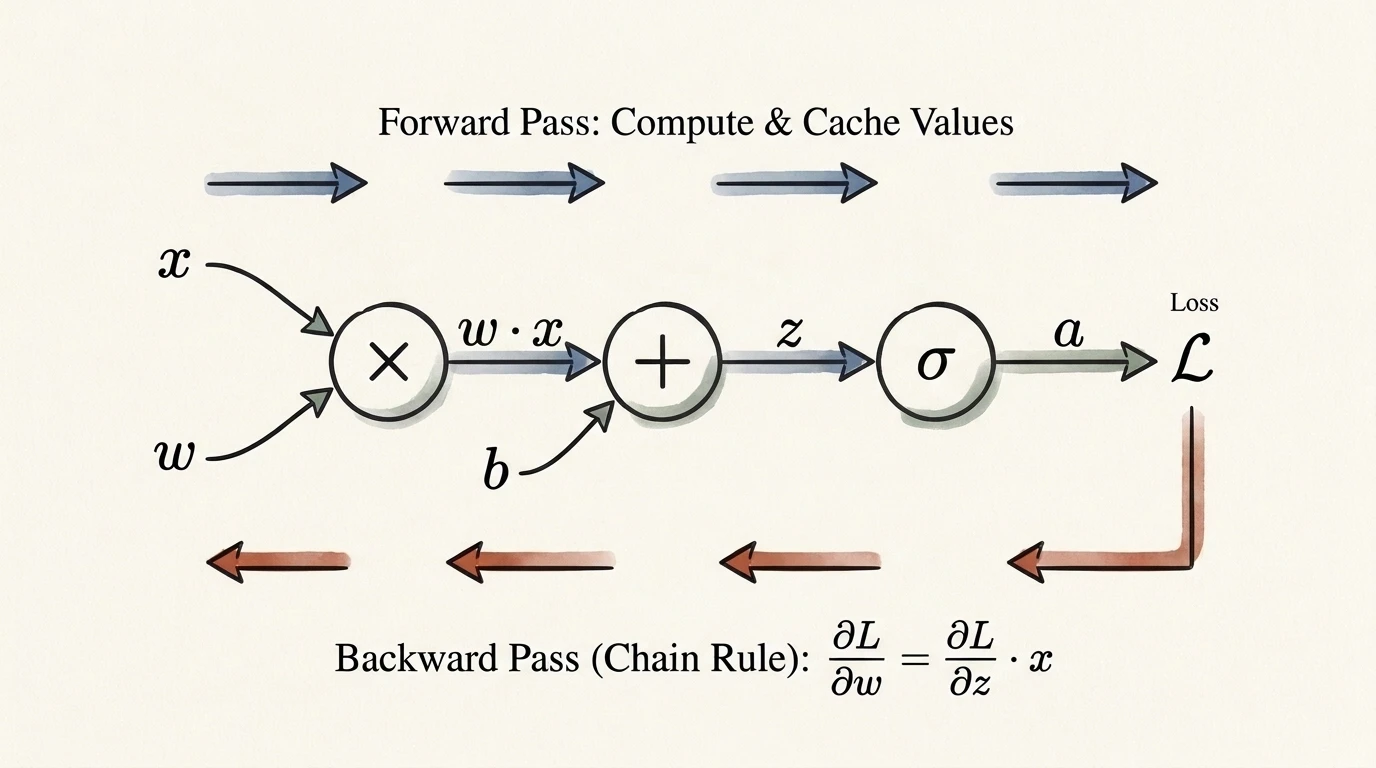 图:计算图(Computational Graph)中单个神经元的前向计算与反向梯度路由机制。上方蓝色流(Forward Pass):输入 与权重 经乘法门 、偏置加法门 及非线性激活门 逐级算出损失 ,并在节点本地缓存前向中间值;下方红色流(Backward Pass):从终端 出发自右向左回传,每个原子门仅需将“上游传来的梯度”乘以“本地局部导数”即可完成精确接力。
让我们顺着上图,用手工算一道最基础的单神经元计算题,彻底看清“局部梯度接力”是如何运作的:
设单个神经元的复合计算流程被拆解为如下 3 个原子步骤:
- 乘法门:
- 加法门:
- 激活与损失门:
假设给定某条样本输入 ,当前权重 ,偏置 :
-
第一阶段:前向传播(Forward Pass —— 从左往右算数值,并把中间结果存进草稿纸)
- 算乘法门:(本地缓存 );
- 算加法门:(本地缓存 );
- 算终端输出得到总损失 ,假设最后一步在 处的导数已经算出为 (这就是从上游传回来的误差信号!)。
-
第二阶段:反向传播(Backward Pass —— 从右往左传梯度,每个门只管自己眼皮底下的乘法) 现在,加法门和乘法门根本不需要知道右边后面的网络有多复杂,它们只需要遵循链式法则(Chain Rule):
- 经过加法门 :
因为 且 ,所以根据链式法则:
- 规律一(加法门是“梯度广播器”):加法门在反向传播时,不改变梯度的大小,直接把上游梯度原封不动地复制分发给每一个加数分支!
- 经过乘法门 :
因为 且 ,上游刚刚传给 的梯度是 ,所以:
- 规律二(乘法门是“输入互换器”):求权重 的梯度时,拿上游梯度乘以输入信号 ;求输入 的梯度(为了继续往更前一层传)时,拿上游梯度乘以权重 !
- 经过加法门 :
因为 且 ,所以根据链式法则:
工程顿悟:为什么训练大模型(LLM)时显存(VRAM)总是爆满,而推理时显存占用却很小? 请看上面乘法门的求导公式:! 在反向传播计算第 层权重矩阵 的梯度时,公式里必须用到前向传播时算出来的上一层激活值 !
- 推理(Inference)时:不需要反向传播,算完第 层得到 ,传给第 层算出 后, 的内存就可以立刻释放扔掉了;
- 训练(Training)时:为了等会儿反向传播时能在乘法门做“交叉相乘”,前向传播走过的所有层的中间激活值 全都不能扔,必须死死驻留在 GPU 显存里!这正是深度学习训练显存消耗的核心大头(也是现代大模型重计算技术 Activation Checkpointing 拿时间换空间的底层原因)。
3.3 多层感知机(MLP)矩阵级反向传播的四大核心方程
将上述单节点的“加法广播、乘法互换”推广到任意 层全连接神经网络(第 层的前向传播为线性组合 与逐元素激活 ,其中输入层记为 ),我们只需定义一个核心桥梁变量——第 层的误差敏感度向量(Error Sensitivity):
即损失函数对该层线性预激活值 的偏导数(代表第 层神经元对最终错误的“责任大小”)。利用多元微积分链式法则,整个深度神经网络的反向传播可以被极其优美地浓缩为四大核心矩阵方程(完整逐分量推导见 附录 A):
- 方程一:输出层误差起点 (以二分类 Sigmoid + 交叉熵或多分类 Softmax + 交叉熵为例)
- 物理直觉:输出层的责任 极其纯粹,就是“模型预测概率 与真实标签 的直接差值”!预测完全准确时差值为 ,误差越大, 越大(注:输出层激活函数的导数恰好与交叉熵对数求导的分母完美约消,从而避免了输出层饱和导致的梯度停滞,严格证明见 附录 A.1)。
- 方程二:层间误差的反向递推(从第 层倒推第 层责任 )
(其中 表示同维向量逐元素相乘 Hadamard Product)。
- 物理直觉:第 层神经元的责任怎么算?先把下一层算好的责任 顺着连接权重矩阵的转置 按权重比例倒推回来(乘法门对输入求导乘权重),再逐元素乘上本层激活函数在当前点的斜率 (过激活门)。
- 一眼看穿“梯度消失”:看!每次往回倒推一层,都要乘一次矩阵 和一次激活导数 。如果 是最大只有 的 Sigmoid,或者权重矩阵 初始化得太小,递推十几次后 就彻底归零了!
- 方程三:权重矩阵梯度
- 物理直觉:连接第 层第 个神经元与第 层第 个神经元的权重梯度 ,恰好等于“上游输出端背负的误差责任 ” “下游输入端在当时发出的激活信号强度 ”(乘法门互换律)!
- 方程四:偏置向量梯度
- 物理直觉:加法门的局部导数为 ,偏置梯度直接等于本层的误差责任向量 。
4. 现代深度学习训练的三大工程支柱:为什么光有 BP 还是训不好深网?
从 1986 年反向传播算法提出,到 2012 年深度学习真正统治工业界,中间足足隔了 26 年。既然四大方程在 1986 年就已经写得清清楚楚,为什么当年的人们依然训不好深层网络?
因为多层复合函数让损失曲面(Loss Landscape)从第一、三站里温顺的“凸碗(Convex Bowl)”,变成了高度非凸、遍布狭长病态峡谷(Ill-conditioned Ravines)、鞍点高原(Saddle Points)与梯度爆炸悬崖的险恶地形。除了将 Sigmoid 换为 ReLU 之外,现代深度学习还依靠以下三大工程支柱才真正驯服了深层网络:
4.1 支柱一:权重初始化的生死线 —— 打破对称性与 Xavier / He 方差守恒
在第一站训练逻辑回归时,我们随手写了一句 w = np.zeros(d)(把权重全部初始化为 ),模型照样欢快地收敛到了全局最优。
然而,在多层神经网络里,如果你把权重矩阵 全部初始化为 (或者全部初始化为同一个常数,比如 ),整张神经网络会当场彻底瘫痪,永远学不会任何东西!
为什么?这源于神经网络著名的“对称性锁死(Symmetry Breaking Problem)”:
- 假设隐藏层有 个神经元,它们的初始权重行向量完全相同(例如全为 )。
- 在前向传播时,由于接收相同的输入 ,这 个神经元算出的激活值 完全相等;
- 在反向传播时,根据方程二和方程三,这 个神经元收到的误差梯度 也完全相等!
- 结果就是:无论你训练一万步还是一亿步,这 个神经元的权重在每一步都做着一模一样的更新,永远保持克隆状态——你花钱买了 个神经元,实际上自始至终等于只有 个神经元在干活!
因此,神经网络的权重必须使用随机数初始化以打破对称性(偏置 可以安全地初始化为 )。但紧接着第二个问题来了:随机数该抽多大?(即初始化分布的方差 该设多少?)
假设某层有 个输入神经元(比如 ),线性求和为 :
- 如果随机权重抽得太大(比如标准正态分布 ): 项加在一起后, 的方差会放大 倍(),经过 10 层网络后数值变为 ,直接触发浮点数溢出(
NaN)与梯度爆炸(Exploding Gradient)! - 如果随机权重抽得太小(比如 ):每过一层信号方差缩小为原来的 ,过几层后所有激活值和梯度全部衰减为 (信号消失)!
为了在第一天开机训练时,让前向传播的激活值方差与反向传播的梯度方差在穿过每一层时都保持既不放大也不缩小的黄金平衡(),统计学家推导出了现代深度学习标配的方差守恒初始化准则(严格证明见 附录 B):
- Xavier / Glorot 初始化(2010,针对 Tanh / Sigmoid 等对称激活): 要求权重均值为 ,且方差严格反比于输入/输出维度:
- He / Kaiming 初始化(何恺明等,2015,针对 ReLU 激活的精确修正): 因为 ReLU 会将负半轴的一半信号直接砍成 ,导致经过 ReLU 后方差刚好折损一半;为了把这一半损耗补回来,必须将权重方差乘上 : 正是这一行极简的 标准差缩放因子,使得上百层的现代深度网络在初始化瞬间就能保持全网信号与梯度的畅通无阻!
4.2 支柱二:优化器演进 —— 从病态峡谷震荡到 Momentum(动量)与 Adam
在第一站附录 E中,我们曾分析过梯度下降的命门:当损失函数的等高线不是正圆,而是不同参数方向曲率悬殊的狭长病态峡谷(Ill-conditioned Ravine,纵向陡峭、横向平缓)时,普通随机梯度下降(Vanilla SGD)会陷入两难绝境:
- 梯度向量垂直于等高线,因此绝大部分分量都指向两侧陡峭的崖壁,只有极微弱的分量指向谷底出口;
- 步长 稍微大一点,参数就会在南北崖壁之间剧烈反弹震荡;步长 调小以迁就陡峭方向,沿着谷底向东前进的速度又慢如蜗牛。
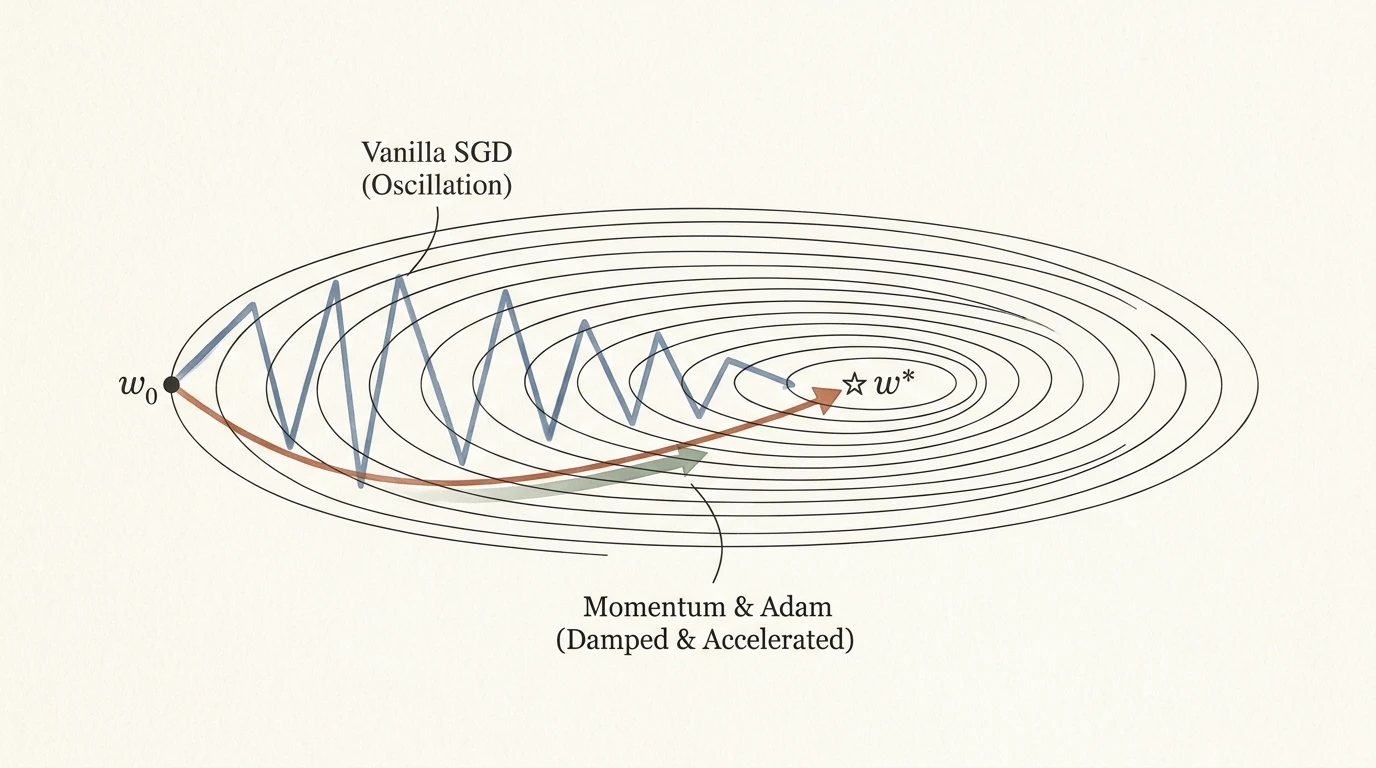 图:病态狭长损失峡谷(Ill-conditioned Ravine)中的优化器动力学轨迹对比。蓝色轨迹(Vanilla SGD):受限于瞬时梯度垂直于等高线的几何性质,在南北陡峭崖壁间剧烈锯齿震荡,向东推进极慢;红绿轨迹(Momentum & Adam):引入历史梯度指数移动平均(一阶动量惯性)抵消正负交替的南北震荡,并借助梯度平方累加(二阶自适应缩放)自动压制陡峭方向步长、放大平缓方向步长,平滑直抵全局最优解 。
为了彻底驯服峡谷地形,现代优化器沿着物理学直觉完成了两次升维:
-
动量法(SGD with Momentum,物理铁球惯性 —— 修正一阶方向): 想象从山坡上滚下的不是羽毛(每一步完全听命于当前点的瞬时风向 ),而是一颗沉重的实心铁球。铁球自带历史速度惯性 (历史梯度的指数移动平均 EMA,常取动量衰减率 ):
公式符号 名称与默认取值 物理与数学含义 模型权重参数(Weight) 第 步迈步前的当前参数坐标 ,与迈出一步后更新得到的新参数坐标 。 瞬时梯度(Gradient) ,第 步基于当前小批量样本(Mini-batch)算出的当前脚下瞬时坡度。 累积动量速度(Velocity) 为上一步攒下的历史惯性速度; 为融合历史惯性与当前瞬时梯度后的新合成速度。 动量记忆系数(常取 ) 权重分配开关: 意味着每一步的前进方向90% 继承历史惯性,10% 采纳当前新梯度(越久远的历史梯度按 指数级自然淡忘)。 学习率(Learning Rate) 步长缩放因子,控制顺着合成负动量方向 迈出的步伐大小。 - 核心追问:凭什么说“老梯度攒出来的惯性 ”比“当前刚算出来的最新梯度 ”更值得信赖?
- 几何视角(过滤峡谷高频正负震荡,提取低频主趋势):在狭长峡谷中,南北陡壁方向的瞬时梯度每一步都在正负剧烈反转(如 ),单看任何一步的 都在指鹿为马;而东西谷底方向的梯度虽然微弱(如恒为 ),却始终保持同向。将过去几十步梯度做指数移动平均后,方向频繁反转的错误分量在累加中自动正负抵消,唯有长期坚持同向的真实谷底主趋势被提纯保留。
- 统计视角(对抗 Mini-batch 抽样噪声):深度学习训练几乎从不全量计算数百万样本的真实总梯度,而是每一步只随机抽一小撮样本(如 Batch Size )估算随机梯度 。单步的 夹杂着极大的抽样方差(比如刚好抽到两张标错的离群图片);而历史动量 本质上是把过去几十个 Mini-batch 的梯度求了加权平均,等价于在时间维度上免费扩大了数十倍的样本视野,其方向自然比单步盲人摸象的 稳健得多!
- 如果地形真的拐弯了怎么办(指数遗忘机制)? 因为 ,动量法并不是死抱一万步以前的旧方向不放,它的有效记忆窗口大约只有最近 步左右。一旦山谷真正发生转向,连续十几步的新梯度都会指向新方向,很快就能把老惯性扭转过来。
- 核心追问:凭什么说“老梯度攒出来的惯性 ”比“当前刚算出来的最新梯度 ”更值得信赖?
-
RMSProp 与 Adam(Adaptive Moment Estimation,自适应步长 —— 修正二阶曲率尺度): 既然南北方向太陡(历史梯度绝对值总是很大)、东西方向太缓(历史梯度绝对值总是很小),为什么所有参数维度要共用同一个死板的学习率 呢? 2014 年,Kingma 与 Ba 提出了统治至今的 Adam 优化器(工业界现多采用其解耦权重衰减修正版 AdamW),同时维护两个历史滑动账本:
- 一阶动量账本(记方向惯性,):
- 二阶能量账本(记历史梯度平方大小,): 经过零初始偏差校正()后,参数更新公式为:
- 神来之笔在于分母 :对于常年剧烈震荡的陡峭方向,历史梯度平方均值 极大,除以 自动帮该维度踩下刹车(缩小有效步长);对于常年平缓的谷底方向, 极小,除以 自动帮该维度猛踩油门(放大有效步长)!相当于无需计算昂贵的海森矩阵逆,就免费给每个参数配了一位专属的自适应曲率调速员。
- 前沿引子(从标量级 AdamW 到矩阵级 Muon):自 2017 年至 2025 年,AdamW 一直是 OpenAI(GPT 系列)、Anthropic(Claude 系列)、Meta(Llama 系列)与 DeepSeek 等训练千亿大模型的绝对统治级标配。然而 AdamW 的一个底层局限在于它将二维权重矩阵 拆成孤立的标量元素逐个除以 ,容易引发矩阵更新的低秩坍缩。2025 年,月之暗面(Moonshot AI)在 Moonlight 与万亿参数模型 Kimi K2 中率先将新兴的 Muon 优化器(基于牛顿-舒尔茨迭代的矩阵正交化动量法) 扩展至超大规模 LLM 训练,通过对整个动量矩阵做奇异值拉平(正交化)并攻克大模型谱范数失控难题,成为十年来首个在旗舰大模型上真正撼动 AdamW 统治地位的新范式(关于现代大模型优化器的深层演进,我们将在后续专题章节中单独深入拆解)。
4.3 支柱三:深网的正则化新范式 —— Dropout(随机失活)与归一化
当深度神经网络拥有了千万级参数后,它死记硬背训练集的过拟合能力比第四站的深决策树还要狂野。除了继续沿用第二站的 权重衰减(Weight Decay)外,深度学习演化出了两件专属的护法神器:
- Dropout(随机失活,Srivastava & Hinton et al., 2014)—— 神经网络里的“随机森林”:
- 机制:在训练期的每一次前向传播中,以失活概率 (如 )随机将隐藏层中的一部分神经元临时掐断清零(拔掉网线),仅用剩下的神经元完成本次前向与反向更新;到了测试推理期,所有神经元全员上岗(并将激活值按保留率 缩放,或训练期直接除以 做 Inverted Dropout 以使测试期无需任何缩放)。
- 第一性原理(呼应第四站 Bagging):
- 如果一个隐藏层有 个神经元,每个神经元可开可关,总共对应 种不同的子网络拓扑结构!每一次训练迭代,Dropout 实际上都在抽取一个不同的瘦身子网络进行训练,并在测试期对这指数级个共享权重的子网络求平均——这在统计本质上,正是在单个神经网络内部以极低成本实现了第四站的 Bagging 与随机森林特征子空间抽样(压低模型方差)!
- 从协同适应(Co-adaptation)角度看,Dropout 逼迫每一个神经元都学会独立提取稳健特征,绝不敢躺平依赖某一个特定的“大哥神经元”(因为大哥随时有 概率在下一秒被拔掉网线)。
- 层间激活归一化(Batch Normalization / Layer Normalization):
- 在深层网络训练中,随着底层参数 的不断更新,传给第 层的输入分布每时每刻都在发生剧烈漂移,迫使高层不得不疲于奔命地适应底层分布的变化。
- BatchNorm(Ioffe & Szegedy, 2015,CNN 标配)与 LayerNorm(Ba et al., 2016,Transformer 标配)直接在线性变换与激活函数之间插入一道标准化关卡:强行将每一层神经元的激活值拉回均值为 、方差为 的舒适区(再乘加可学习的缩放平移参数 ),使梯度下降的损失曲面大幅平滑,允许使用比传统网络大上十倍的学习率极速收敛。
5. 计算机里如何表示神经网络?25 行纯 NumPy 手写攻克 XOR
5.1 捅破窗户纸:从“脑海里的圆圈连线图”到“内存里的二维数组表格”
面对教科书上画着的“一排排神经元小圆圈 + 密密麻麻的网线”,一个常见的直觉误区是以为在写代码时需要先定义一个 class Neuron 对象,再用链表指针把圆圈连起来。
真相是:在计算机内存里,根本没有任何“小圆圈”和“连线指针”!
在计算机语言(Python / NumPy / PyTorch)中,整整一层神经元及其所有连线,在内存里的唯一实体就是一张二维浮点数表格(权重矩阵 W)外加一排数字(偏置向量 b)。
以我们马上要手写的 2 输入特征 -> 4 隐藏神经元 -> 1 输出神经元 的两层网络为例:
| 网络结构层级 | 代码中的变量与形状(Shape) | 物理与几何对应关系(工程行矩阵约定:形状为 (上一层人数, 本层人数)) |
|---|---|---|
输入数据 X |
shape = (4, 2) |
4 行代表打包一起算的 4 个 XOR 样本(Batch);2 列代表每个样本的 2 个特征 。 |
| 第 1 层(隐藏层) | W1: (2, 4)b1: (1, 4) |
W1 是 2 行 4 列的表格:2 行接上游的 2 个输入,4 列代表本层的 4 颗隐藏神经元(表格的第 列就是连向第 颗神经元的那两根权重线)!b1 是这 4 颗神经元各自的偏置阈值。 |
| 第 2 层(输出层) | W2: (4, 1)b2: (1, 1) |
W2 是 4 行 1 列的表格:4 行接上游刚算出来的 4 颗隐藏神经元,1 列代表本层最终的 1 颗输出神经元。 |
当数据 X 从左往右流过网络时,前向传播在计算机底层只是一场“矩阵维度消消乐”(相邻两个矩阵相乘时,前一个矩阵的列数必须严格等于后一个矩阵的行数):
- 符号衔接说明(为什么代码里的矩阵乘法顺序与 3.3 节公式互为转置?):
在第 3.3 节与附录 A 的数学推导中,我们采用教科书标准的单样本列向量约定 (样本 为列向量,权重 形状为 );而在工程代码中,为了把 个样本按行堆叠成二维表格 批量并行计算,统一采用行向量右乘约定 (此时代码里的
W形状为 ,恰为列向量约定下 的转置)。根据矩阵转置基本恒等式 ,第 3.3 节方程三的权重梯度 在行矩阵代码中自然转置为左乘激活转置、右乘误差矩阵的A1.T @ dZ2(形状 ),方程二的误差反传 自然转置为dZ2 @ W2.T(形状 ),且代码中的/ len(X)即自动对 Batch 内 4 个样本的梯度求算术平均。
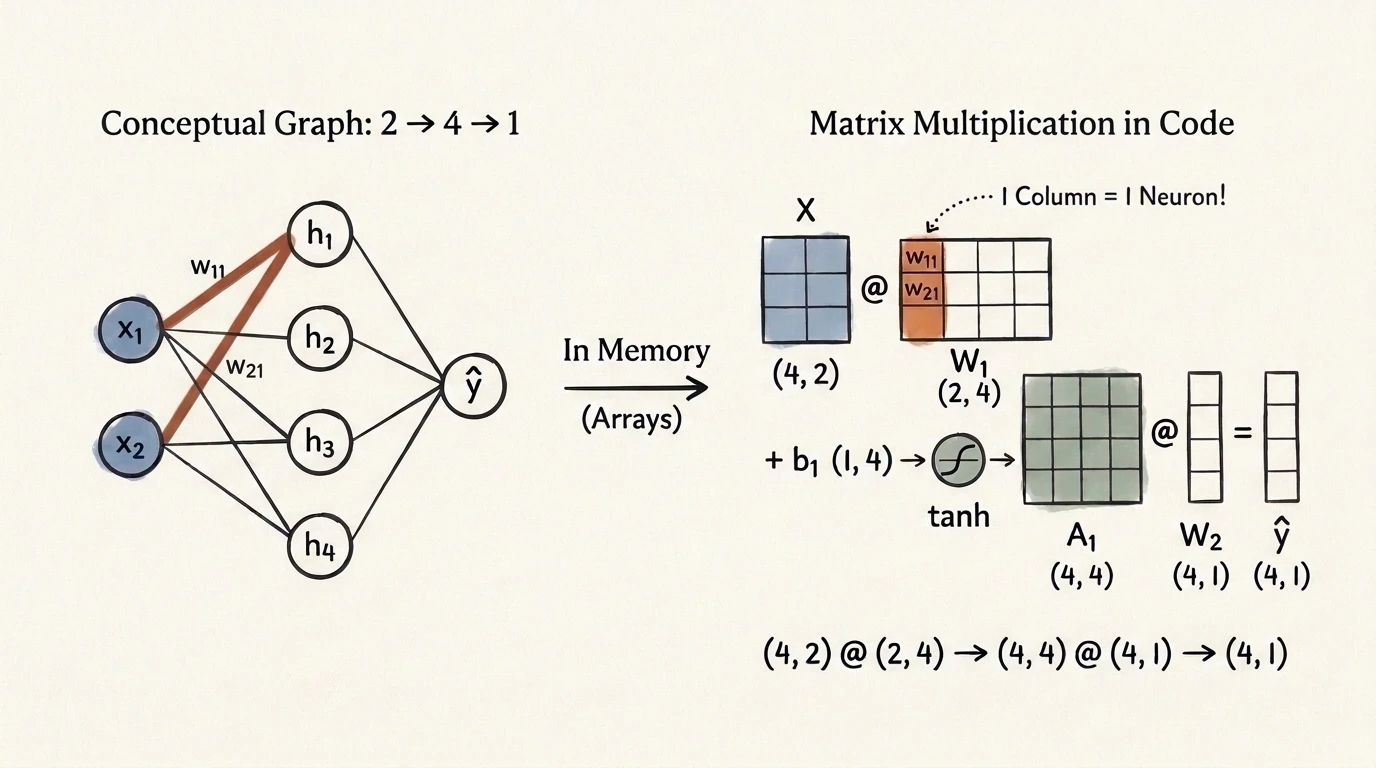 图:从“神经元圆圈连线图”到“计算机内存二维数组表格”的映射全貌。左图:概念上的
2 -> 4 -> 1 两层神经网络拓扑图;右图:计算机内存中实际存储并参与运算的二维矩阵——其中权重矩阵 的形状为 (2, 4),表格中的每一列严格对应本层的一颗神经元(如陶土红高亮的第 1 列 即为连向 1 号隐藏神经元 的两根权重线),整个前向传播通过 (4,2) @ (2,4) -> (4,4) @ (4,1) -> (4,1) 的矩阵维度消消乐一次性完成。
[!TIP] 为什么下面的 25 行代码里,第一层用了
np.tanh(Z1)(双曲正切激活函数)?以及是否每次线性变换都必须套激活函数?
tanh是什么:A1 = np.tanh(Z1)正是第一层(隐藏层)的非线性激活函数。它的数学定义是 ,本质上就是把 Sigmoid 的输出范围从 拉伸平移到了关于原点对称的 (消除了 Sigmoid 的非零均值缺陷),且其导数公式极其简明:(对应反向传播代码中计算dZ1时所乘的(1.0 - A1 ** 2))。- 为什么微型网络用
tanh而不用ReLU:在仅有 4 个隐藏神经元、4 个样本的极简玩具网络中,若使用负半轴导数直接归零的ReLU,一旦随机初始化的权重碰巧让某颗神经元对 4 个样本均输出负数,该神经元就会当场触发“神经元坏死(Dead ReLU)”而永久失联;而在仅有 2 层的浅网络中不存在十层连乘梯度消失,使用处处有梯度的光滑tanh能保证任意随机种子下 100% 稳定收敛。- 工程铁律——每次线性变换后都必须套激活函数吗?
- 所有中间隐藏层(Hidden Layers):100% 必须套(如
ReLU / GELU / Tanh),目的是将特征空间折弯、阻断相邻两层矩阵直接相乘合并;任何不加激活函数的中间线性层都是白耗算力的冗余层。- 最后一层(输出层 Output Layer):线性变换算出的原始分值 称为 Logits,其后是否套激活函数纯粹是为了将输出值格式化为任务所需的数值范围:
- 回归预测(房价、气温等任意实数 ):什么都不套(直接输出纯线性结果 ,若误套
ReLU则永远无法输出负数,误套Sigmoid则永远无法超过 );- 二分类概率(输出 单一概率):套
Sigmoid;- 多分类 / 大语言模型词表预测(输出 个和为 的概率分布):套
Softmax()。
5.2 25 行纯 NumPy 完整代码与 PyTorch 工业界写法对照
不需要安装任何深度学习框架,仅凭我们在第 3.3 节推导出的反向传播四大矩阵方程,用 25 行基础 NumPy 矩阵乘法就能从零训练出一个完美切开 XOR 异或死局的两层神经网络:
import numpy as np

# 1. 构造 XOR 异或数据集:4 个样本,输入 2 维,标签 1 维
X = np.array([[0, 0], [0, 1], [1, 0], [1, 1]], dtype=float)  # shape: (4, 2)
y = np.array([[0], [1], [1], [0]], dtype=float)              # shape: (4, 1)

# 2. 随机初始化两层网络参数(打破对称性):输入2 -> 隐藏层4(Tanh) -> 输出层1(Sigmoid)
np.random.seed(42)
W1 = np.random.randn(2, 4) * np.sqrt(1.0 / 2)
b1 = np.zeros((1, 4))
W2 = np.random.randn(4, 1) * np.sqrt(1.0 / 4)
b2 = np.zeros((1, 1))

# 3. 端到端前向传播 + 反向传播四大方程迭代训练
lr = 0.5
for step in range(2000):
    # 【前向传播 Forward Pass】缓存中间激活值 Z1, A1, A2
    Z1 = X @ W1 + b1                        # (4, 4) 第一层线性组合
    A1 = np.tanh(Z1)                        # (4, 4) 第一层非线性激活(双曲正切空间折纸)
    Z2 = A1 @ W2 + b2                       # (4, 1) 第二层线性组合
    A2 = 1.0 / (1.0 + np.exp(-Z2))          # (4, 1) 输出层 Sigmoid 预测概率 y_hat

    # 【反向传播 Backward Pass —— 严格对应 3.3 节四大方程】
    dZ2 = (A2 - y) / len(X)                 # 方程一:输出层误差起点 delta^(2) = y_hat - y
    dW2 = A1.T @ dZ2                        # 方程三:W2 梯度 = 上一层激活 A1^T * delta^(2)
    db2 = np.sum(dZ2, axis=0, keepdims=True)# 方程四:b2 梯度
    dZ1 = (dZ2 @ W2.T) * (1.0 - A1 ** 2)    # 方程二:倒推隐藏层责任 delta^(1) (tanh导数为 1-A1^2)
    dW1 = X.T @ dZ1                         # 方程三:W1 梯度 = 输入 X^T * delta^(1)
    db1 = np.sum(dZ1, axis=0, keepdims=True)# 方程四:b1 梯度

    # 【梯度下降更新参数】
    W2 -= lr * dW2; b2 -= lr * db2
    W1 -= lr * dW1; b1 -= lr * db1

print("XOR 预测概率输出:", np.round(A2.ravel(), 4).tolist())
# 输出: [0.0003, 0.9972, 0.9971, 0.0043] —— 完美攻克 XOR 异或死局!
而在工业界使用 PyTorch 时,框架只是把我们上面手写的“申请权重与偏置数组”与“反向传播求导四方程”封装成了自动化的模块(注:PyTorch nn.Linear(d_in, d_out) 内部将权重参数存为转置形状 (d_out, d_in) 并在前向时自动执行 X @ W.T + b,在数学上与上面手写的 X @ W1 + b1 完全等价):
import torch.nn as nn

# 这 6 行 PyTorch 定义,在数学运算上与上面手写的两层 NumPy 网络完全等价!
model = nn.Sequential(
    nn.Linear(in_features=2, out_features=4),  # 封装第 1 层线性变换 (2 输入 -> 4 隐藏神经元)
    nn.Tanh(),                                 # 对应 A1 = np.tanh(Z1)
    nn.Linear(in_features=4, out_features=1),  # 封装第 2 层线性变换 (4 隐藏 -> 1 输出神经元)
    nn.Sigmoid()                               # 对应 A2 = 1 / (1 + exp(-Z2))
)
6. 本章核心总结与认知闭环
| 核心模块 | 第一性原理与认知闭环 |
|---|---|
| 线性坍缩与空间折纸 | 纯矩阵连乘 因结合律必然坍缩为单层线性模型;唯有插入逐元素非线性激活函数 ,才能将每一层转化为“旋转缩放 + 平移 + 沿超平面折弯”的空间折纸操作,用 层网络切出指数级 个分段线性区域。 |
| 激活函数的跃迁 | Sigmoid 因导数上限仅为 且两端饱和,连乘后必然导致深层网络底层梯度消失;ReLU 以 在正半轴开辟了导数恒为 的无损梯度高速公路。 |
| 反向传播(自动微分) | 抛弃需算 次前向传播的数值差分法,利用计算图将全局求导拆解为局部算子接力(加法门广播梯度、乘法门互换输入与权重),通过缓存前向激活值 ,仅用 1 次前向 + 1 次反向即可求出全网精确梯度。 |
| 现代深网三大工程支柱 | Xavier/He 随机初始化打破神经元对称性并守恒逐层方差;Momentum 与 Adam 用一阶惯性与二阶曲率自适应步长抚平病态峡谷震荡;Dropout 与 Normalization 以隐式子网 Bagging 与分布对齐护航超深网络泛化。 |
从全连接 MLP 迈向现代架构演进: 掌握了本篇的端到端表征学习、空间折纸与反向传播后,你已经拿到了整个现代深度学习宇宙的通用发动机。接下来所有的现代神级架构,无非是针对特定物理世界结构,对全连接矩阵 所做的先验结构改造(归纳偏置注入):
- 当面对二维网格图像,把稠密矩阵 改造成“局部感受野 + 权重平移共享”的稀疏滤波器 卷积神经网络(CNN);
- 当层数突破百层出现退化问题,在层间架起恒等映射跳连通道 残差网络(ResNet);
- 当面对自然语言序列,用动态查询-键内积路由 取代固定静态权重 Transformer 与现代大语言模型(LLM)!
附录 A:反向传播(Backpropagation)四大矩阵方程的严格数学推导
为确保 第 3.3 节 中的四大矩阵方程不留任何黑盒跳步,本附录从标量分量求导与微积分链式法则出发,给出完整严密的代数证明。
A.1 符号约定与方程一(输出层误差起点 )的证明
设 层神经网络在第 层()具有 个神经元。给定单个样本输入 ,第 层的前向计算按分量写为: 定义第 层第 个神经元的误差敏感度为 。
情形 1:二分类输出层(Sigmoid 激活 + 二分类交叉熵损失) 输出层仅含 1 个标量节点 ,预测概率为 ,真实标签 ,交叉熵损失为: 由单变量链式法则 :
- 第一项(损失对预测概率求导):
- 第二项(Sigmoid 导数性质): 两项相乘,分母 与分子完美约消:
情形 2:多分类输出层(Softmax 激活 + 多分类交叉熵损失) 设输出层有 个类别节点 ,经 Softmax 归一化后的预测概率为 ,真实 One-hot 标签向量为 (满足 ),交叉熵损失为 。 因为调整单个 会通过分母归一化同时影响所有类别的概率 ,由多元微积分全导数公式: 利用商的求导法则计算 Softmax 的雅可比导数 :
- 当 时:;
- 当 时:。 代入求和式并拆分 与 项: 写成向量形式即证得方程一:。
A.2 方程二(层间误差反向递推)的证明
考察第 层第 个神经元的线性预激活值 。它首先通过激活函数生成 ,随后 作为输入同时馈入第 层的所有 个神经元: 根据多元函数全导数链式法则(计算图中多分支汇合梯度相加): 注意到 ,且对线性求和式求偏导有 ,代入上式得: 将所有分量 组装为列向量,即证得方程二:
A.3 方程三与方程四(权重与偏置梯度)的证明
对于第 层的特定权重参数 与偏置 ,它们仅直接参与第 层第 个神经元的线性组合 。由单路径链式法则: 根据矩阵外积定义,行指标为 、列指标为 的乘积 构成的矩阵恰为列向量 与行向量 的乘积,即证得方程三与方程四:
附录 B:Xavier 与 He(Kaiming)权重初始化方差守恒定理的严格推导
为理解 第 4.1 节 中为什么权重初始化方差必须设为 (Xavier)或 (He),下面给出基于概率论方差性质的严格推导。
B.1 线性层加权求和的方差传播公式
考察某层单个神经元的线性预激活输出 (初始偏置 )。假设:
- 权重 独立同分布(i.i.d.),均值为 ,方差为 ;
- 输入特征 相互独立,且与权重 相互独立;暂时设 ,方差为 。
根据独立随机变量乘积的期望与方差公式: 对 个相互独立的乘积项求和,总方差等于各项方差之和:
B.2 Xavier 初始化(针对原点处斜率为 1 的奇函数激活,如 )
在线性区附近(),若希望输出方差 与输入方差 保持严格相等(即信号经过每一层既不膨胀也不衰减:),必须令上式中的缩放倍率等于 : (同理,若从反向传播梯度方差守恒 出发,则会导出 ;Glorot & Bengio (2010) 取两者的调和折中,即 )。
B.3 He / Kaiming 初始化(针对 ReLU 激活的非对称折半修正)
当网络使用 时,当前层的输入 不再是零均值变量(其负半轴被全部截断为 )! 设上一层预激活值 服从关于原点对称的零均值分布(如高斯分布 ),经过 ReLU 截断得到 。 此时虽然 ,但因为 且 与 独立,依然有 ,从而: 由于 的概率密度关于 对称,其在负半轴()取值为 ,在正半轴()等于 ,因此 的二阶矩恰好等于完整对称分布方差的一半: 将其代回线性求和方差公式: 为了令相邻两层预激活值的方差严格守恒(),括号内的系数必须恒等于 :