本篇导读:在上一讲(内存栈与堆、线程与异步事件循环)中,我们拆解了单个进程内部的虚拟内存四层户型图与单线程事件循环(Event Loop)。然而,正是因为操作系统为了安全将每个进程锁死在各自独立的虚拟内存房间里(A 进程绝不能直接读写 B 进程的堆和栈),一旦需要跨进程协作——比如你的桌面 Agent 要调用本机安装的 Python 工具服务(本地
MCP),或者前端网页要穿过代理网关、实时接收云端大模型一个字一个字吐出的回复——我们就必须回答两个核心通信问题:第一,在同一台电脑上,两个内存绝对隔离的进程如何不走外网、以微秒级速度安全地递纸条?第二,当通信跨越物理网线与太平洋时,数据包如何完成全球寻址与代理转发,计算机又如何把一串不可靠的0/1电信号变成可靠的字节流(TCP),并在其上构建“一问一答(HTTP)”、“单向打字机吐字(SSE)”与“双向实时对讲(WebSocket)”? 本篇作为《计算机底层原理》系列的第二讲,围绕四个递进问题,把从本机内核管道到全球流式网络协议的完整物理链路一次性打通。
问题一:同一台电脑上的两个进程,内存完全隔离,怎么传数据?—— 进程间通信(IPC)与 stdio 匿名管道
在第一讲中我们知道,每个进程都是一间锁死大门的独立餐馆:宿主 Agent(比如用 TypeScript/Node.js 写的客户端)住在 进程 A,而你用 Python 写的某个本地数据分析工具住在 进程 B。既然 进程 A 连 进程 B 的内存门牌号都摸不到,它们俩怎么对话?
答案是:找整栋大楼唯一的物业总管——操作系统内核(OS Kernel)当中间人。 这套机制统称为进程间通信(Inter-Process Communication, IPC)。而在所有 IPC 机制中,最古老、最优雅、也是当今 本地 MCP(Model Context Protocol)工具调用绝对底座 的,就是标准输入输出管道(stdio Pipe)。
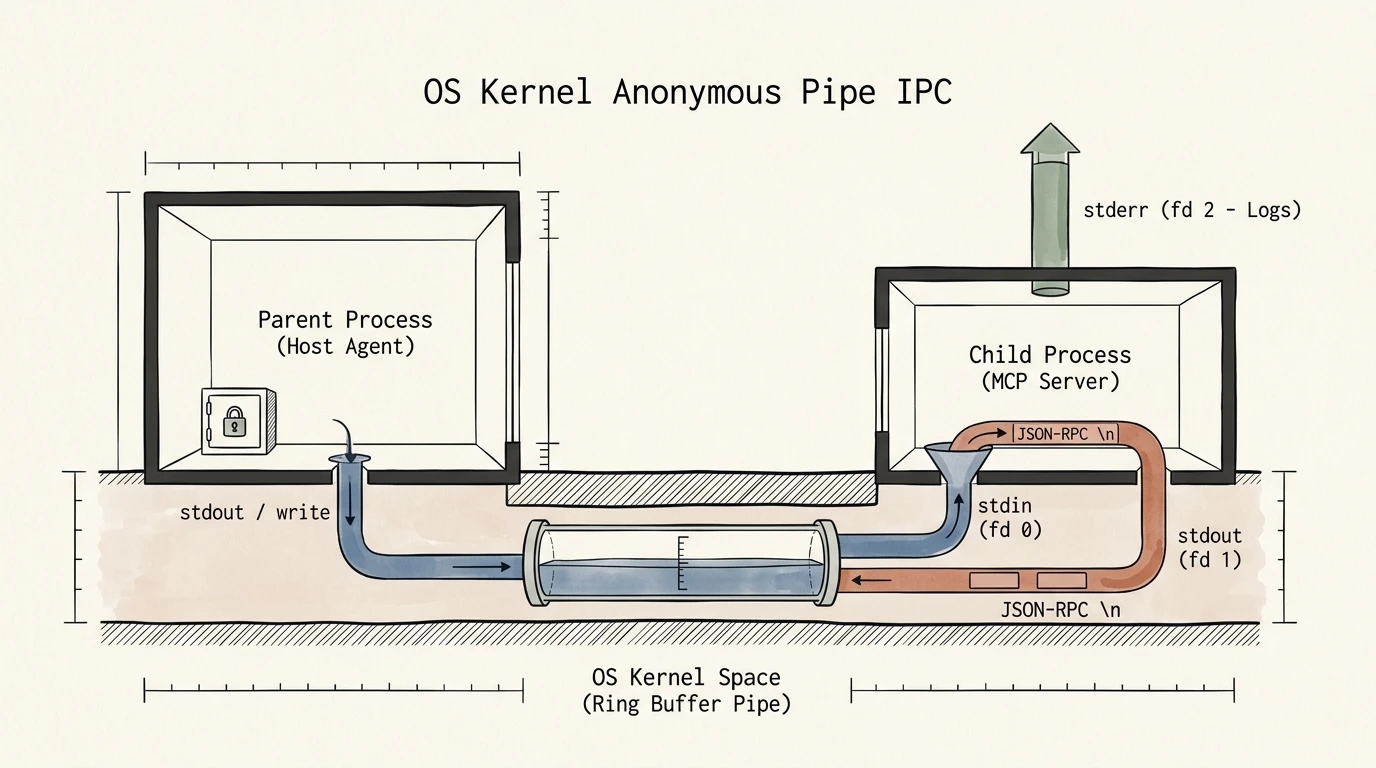 图:同机父子进程通过操作系统内核匿名管道(
stdio Pipe)通信的物理机制。左侧宿主父进程(Parent Process)与右侧子进程(Child Process / MCP Server)各自拥有完全锁死的私有内存空间,彼此无法直接越界访问;操作系统在底层的内核空间(OS Kernel)开辟一块内存环形缓冲区(Ring Buffer),将父进程的写入端与子进程的 stdin(标准输入,fd 0) 及 stdout(标准输出,fd 1) 首尾对接,专门传输以换行符 \n 切分的 JSON-RPC 结构化指令;而子进程的调试日志与报错则单独走顶部的绿色排烟管 stderr(标准错误,fd 2) 排出,从而保证数据主航道纯粹无污染。
1. 每个进程生来自带的“三根水管”(fd 0, 1, 2)
在 Unix / Linux / macOS 与现代 Windows 中,任何一个进程在诞生(fork + exec)的那一刻,操作系统内核都会默认往它房间里插进三根编号固定的标准管道(Standard Streams):
水管编号(文件描述符 fd) |
英文简称与全称 | 默认物理接向哪里? | 在被父进程(如本地 Agent)收编后接向哪里? |
|---|---|---|---|
0 号水管 |
stdin(Standard Input,标准输入) |
接在你的物理键盘上(敲键盘就是往 0 号管灌字节) |
被接在父进程的发件口上,专门接收父进程发来的 JSON 指令 |
1 号水管 |
stdout(Standard Output,标准输出) |
接在你的黑框终端屏幕上(print 就是往 1 号管喷字节) |
被接在父进程的收件口上,专门向父进程返回 JSON 结果 |
2 号水管 |
stderr(Standard Error,标准错误) |
同样接在黑框终端屏幕上 | 被父进程单独接去写后台日志文件(Log),绝不与 1 号管的业务数据混流 |
2. 为什么本地 MCP 插件非要用 stdio,而不是在本地起一个 HTTP 网页服务器?
当你配置一个本地 MCP 工具(如 npx @modelcontextprotocol/server-filesystem 或本地 Python 脚本)时,宿主 Agent 并没有让你去配什么端口号 localhost:8080,而是直接拉起子进程走 stdio 管道。这背后有三个极硬核的工程考量:
- 零端口冲突与零配置:如果装 10 个本地工具要起 10 个 HTTP 端口(
8081~8090),不仅容易跟本机其他软件撞端口报错,生命周期还极难管理(宿主关了,后台僵尸端口还挂着)。而stdio子进程与父进程同生共死,父进程退出,管道关闭,子进程收到EOF自动优雅退出。 - 纯内存拷贝,极致低延迟:
stdio匿名管道的本质,只是操作系统内核在内存里划出的一块64KB环形缓冲区(Ring Buffer)。父进程调用write()把字节推进内核缓冲区,子进程调用read()从缓冲区取走——全程不经过网卡、不打包 TCP/IP 协议头、不走防火墙检查,延迟仅有几微秒。 - 绝对的本地隔离安全:匿名管道在文件系统中连名字都没有,只有通过
fork()继承了该管道描述符的亲生子进程才能读写,外网黑客甚至同一台电脑上的其他陌生进程连门都摸不到。
[!CAUTION] 实战铁律:写本地
stdioMCP 工具时,为什么严禁在代码里随便写print("正在加载...")? 看了上面的管道图你就瞬间懂了!在 Python 或 Node.js 里,普通的print()和console.log()默认全都是往1号水管(stdout) 里喷字节的! 此时父进程(宿主 Agent)正眼巴巴地守在1号水管出口,等着接收格式极其严格的{"jsonrpc": "2.0", "id": 1, "result": ...}\n字符串并交给JSON.parse()解析。如果你在代码里随手写了一句print("调试信息:开始查库"),这串中文就会直接混进1号水管,把后面的 JSON 撞碎,导致宿主当场抛出SyntaxError: Unexpected token崩溃! 正确做法:凡是本地stdio服务里的调试日志,必须强制打往2号排烟管(stderr)——在 Python 中写print("...", file=sys.stderr),在 JS 中写console.error("...")。
3. 同机 IPC 家族全景对比:除了管道,还有哪些递纸条方式?
当同机通信的数据量暴增(比如要传几百 MB 的视频帧或张量)或者两个进程之间没有父子血缘关系时,操作系统还提供了另外三种常见的同机通信武器:
| IPC 方式 | 物理机制与隐喻 | 速度与吞吐 | 典型工程场景 |
|---|---|---|---|
匿名管道(Anonymous Pipe / stdio) |
内核内存里的单向传送带,仅限有血缘关系的父子进程使用。 | 快(微秒级,2 次内存拷贝) | 本地 MCP 工具调用、Shell 管道命令 cat log.txt | grep ERROR。 |
| Unix Domain Socket(UDS,本地套接字) | 在本地文件路径(如 /var/run/docker.sock)挂一个虚拟插座,任意无血缘关系的两个本地进程都能插上来双向通信。 |
快(绕过 TCP/IP 网络栈,直接在内核转发) | Docker CLI 与守护进程通信、Nginx 与同一台机器上的 Python/Node 后端通信。 |
共享内存(Shared Memory / shm) |
内核破例把同一块物理内存条同时映射到 A、B 两个进程的虚拟地址空间里,两人直接读写同一张桌子。 | 最快(零拷贝,纳秒级) | PyTorch 多进程 DataLoader 往主进程传巨型图像张量、浏览器渲染进程与 GPU 进程传画面帧。 |
本地回环网络(Loopback 127.0.0.1) |
假装走外网,把数据完整打包成 TCP/IP 数据包,再由内核虚拟网卡自己发给自己。 | 略慢(需走完 TCP 协议栈开销),但跨机兼容性最好 | 本地前后端联调(如本地网页访问本地 localhost:3000 API)。 |
4. 从系统调用看跨语言本质:为什么底层同是一根水管,人类却造出了几十种编程语言与“技术栈”?
看到 Python 写 print()、JavaScript 写 console.log()、C 语言写 printf(),一个直击本质的疑问自然浮现:既然它们最终干的物理活儿完全一样(都是调用操作系统内核的 write(1, buf, len) 往 1 号水管塞字节),为什么学一门新语言还要重新背一套词典?为什么人类不干脆用一种最优雅的“终极语言”大一统,而要衍生出形形色色的“技术栈(Tech Stack)”?
这背后藏着计算机科学最核心的演进哲学:
① “外壳方言” vs. “底层内功”
所有编程语言的外壳语法(Syntax)其实只是人类世界的方言差别——就像中文说“喝水”、英文说“drink water”、日文说“水を飲む”,哪怕写法千差万别,最终喉咙吞咽的生理动作(操作系统内核的系统调用 Syscall)是 100% 一模一样的。
在 AI 时代之前,程序员换语言之所以痛苦,是因为要死记硬背成千上万个标准库 API 的拼写;而今天,只要你真正吃透了底层的“操作系统内功”(懂了 fd 0/1/2 三根水管、懂了栈与堆、懂了事件循环),换一门新语言只需要 10 分钟——因为底层物理机制完全通用,任何语法外壳都可以交给大模型瞬间翻译。
② 编程语言的「不可能三角」
人类历史上无数天才(从早期的 Ada、C++ 到后来的 Java、JavaScript)都曾幻想造出一门“统治一切的终极语言”,但无一例外全都失败了。因为计算机物理世界存在一个残酷的「工程不可能三角」——没有任何一门语言能同时做到① 极致的硬件压榨性能、② 极致的内存与类型安全、以及③ 极致的随手涂鸦开发速度:
| 语言阵营 | 代表语言 | 核心取舍(为了什么,牺牲了什么?) | 为什么它在自己的领地不可替代? |
|---|---|---|---|
| 系统与硬件压榨型 | C / C++ / Rust | 死保极致性能与确定性,牺牲开发轻松度。没有垃圾回收器(GC)保洁阿姨,程序员必须精确控制每一个字节在栈还是在堆、哪一纳秒释放。 | 写操作系统内核、数据库引擎、浏览器 V8 引擎、CUDA 算子。如果用 Python 写操作系统,垃圾回收一暂停,整台电脑连鼠标都会卡住! |
| 快速实验与胶水型 | Python | 死保人类表达的极简与直觉,牺牲原生运行速度。动态类型,不用声明变量大小,写起来像写英语伪代码一样快。 | AI 与数据科学霸主。科学家调模型需要每天改几百次实验逻辑,Python 充当“指挥官”,自己写起来极快,真正重的矩阵乘法则通过 C++ 底层库(PyTorch)甩给 GPU 算。 |
| 高并发连接与全栈型 | JavaScript / TypeScript / Go | 死保高并发网络 I/O 与跨端统一。天生围绕异步事件循环(JS)或轻量级协程(Go)设计,带自动 GC,性能与开发效率折中。 | Web 前后端、Cloudflare Workers、AI Agent 编排底座。唯一能直接在全世界所有浏览器里跑的语言,前后端共用一套类型系统。 |
简言之,你不可能造出一把“既能当手术刀切血管(C/Rust)、又能当挖掘机铲土(Python 调 GPU)、还能当瑞士军刀随身拧螺丝(JS/TS)”的万能铁器。场景的物理约束不同,最优的语言形态就必然不同(这也会在第四讲《编译、AST 与运行时》中从底层彻底揭秘)。
③ 概念对齐:“技术栈(Tech Stack)”与第一讲的“内存栈(Call Stack)”有什么区别?
之所以都叫 Stack(栈),是因为英文里 Stack 的本意就是“像一摞盘子那样一层叠在另一层上面的结构”,但在两个语境下,它们指代的是完全不同维度的“叠盘子”:
| 维度 | 第一讲的 「内存栈(Call Stack)」 | 架构常说的 「技术栈(Tech Stack)」 |
|---|---|---|
| 物理本质 | 微观的硬件内存结构(真实的硅片内存条地址区) | 宏观的软件工程选型组合(架构师的抽象比喻) |
| “盘子”里装的是什么? | 一层层正在执行的函数调用栈帧(如 main() 盘子上面叠着 add() 盘子) |
一层层互相依赖的软件技术组件(如最底下是 Linux 操作系统盘子 上面叠着 SQLite/D1 数据库盘子 再叠 Cloudflare Workers (TS) 后端盘子 最上面是 React 前端盘子) |
| 变化周期 | 纳秒级动态生灭:函数一调就压入,函数一 return 就瞬间弹出销毁 |
按年演进的静态基建:一旦定下用这套“技术拼盘”做项目,整个团队好几年都在这套底座上盖楼 |
问题二:当通信跨越物理网线与太平洋,数据包如何寻址、穿墙并确保不丢不乱?—— 网络四层套娃、IP 代理与 TCP 字节流
一旦 进程 A 在你的笔记本上,而 进程 B 在远端云机房(比如调用云端大模型 API 或远程 MCP 服务),本机操作系统内核的管道就鞭长莫及了——数据必须变成光信号或电磁波,穿过路由器、海底光缆和交换机。
但物理世界是极其残酷且不可靠的:光纤会闪断、路由器排队太满会直接丢弃数据包(Drop Packet)、后发出去的包可能因为走了近路比先发的包更早到达。为了在不可靠的物理电线上造出一条“绝对可靠”的通道,计算机网络设计了著名的「四层信封套娃(TCP/IP 模型)」:
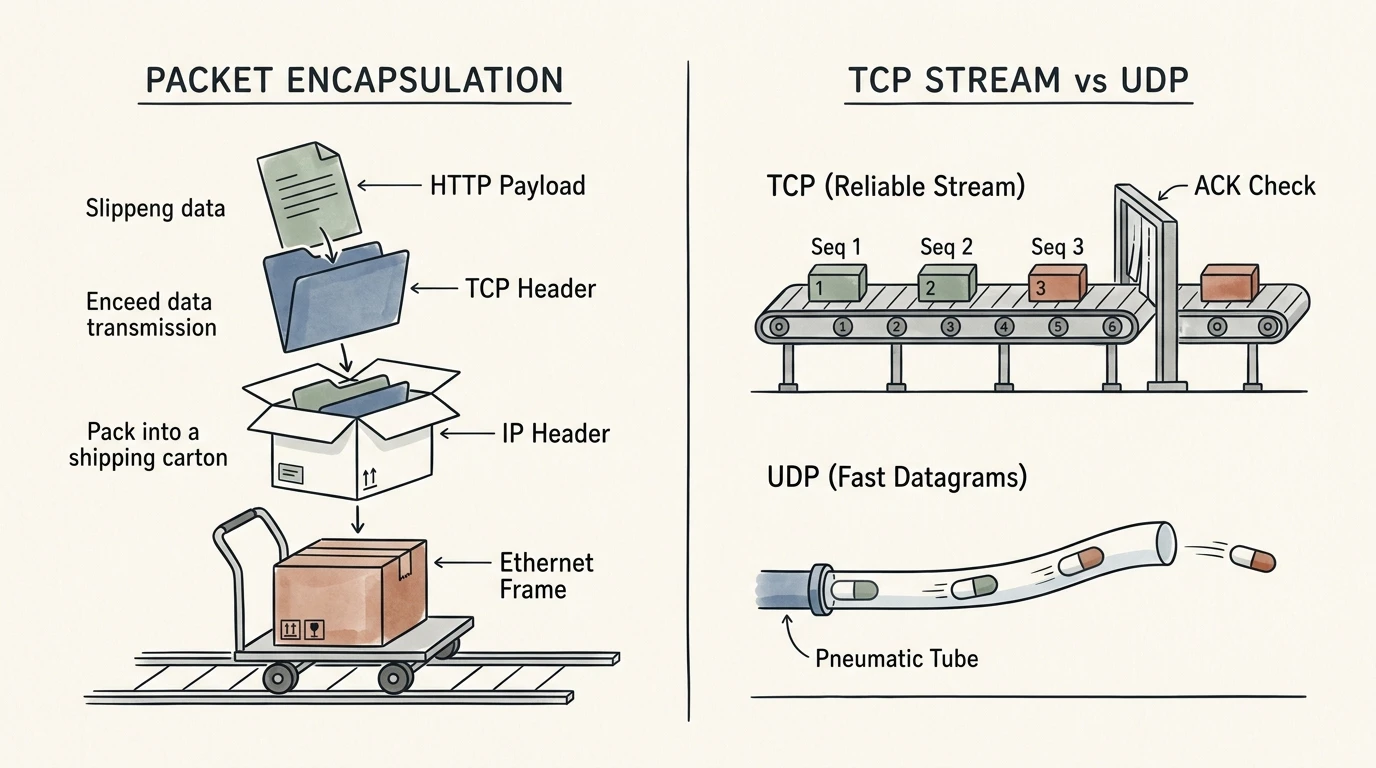 图:网络协议栈的“四层俄罗斯套娃封装”(左)与传输层
TCP vs. UDP 机制对比(右)。左图展示应用层的一页 HTTP/JSON 报文向下传递时,依次套上蓝色的 TCP 传输层信封(标注源/目的端口号 Port 与字节序号 Seq #)、外层的 IP 网络层包装箱(标注全球定位地址 Src IP -> Dst IP),最终装入底层的 Ethernet 数据链路层轨道车(标注相邻网卡物理地址 MAC)发往光纤;右图对比了传输层的两种哲学:上方的 TCP 像带有确认阀门(3-Way Handshake & ACK)的编号传送带,确保字节流严格按序、不丢不重;下方的 UDP / QUIC 则像无需握手的快速气动胶囊炮,追求极致的低延迟首发速度。
1. 四层俄罗斯套娃:每一层到底在解决什么真问题?
很多教科书把“OSI 七层 / TCP/IP 四层”讲得枯燥无比,其实你只需要把它想象成从写信到跨国快递的四个分工部门,每一层只往信封外面多贴一张标签:
| 网络层级(从上到下) | 核心协议代表 | 贴在信封上的核心标签 | 它到底解决了什么物理问题?(缺了它会怎样?) |
|---|---|---|---|
| 4. 应用层(Application) | HTTP, SSE, WebSocket, JSON-RPC, DNS |
信件正文格式 (如 GET /v1/chat、{"role": "user"}) |
解决“说什么人话”:规定双方怎么排版文字,哪里是标题、哪里是正文(不管信怎么寄出去)。 |
| 3. 传输层(Transport) | TCP, UDP |
端口号(Port,如 443)+ 字节编号(Seq) |
解决“交给屋里哪个人 + 丢页了怎么重寄”:IP 地址只能找到大楼,端口号(0~65535)才能精准敲开大楼里对应进程(如 Nginx 或 Node)的房门;同时 TCP 负责把长信裁成小页并编号,丢了哪页重发哪页。 |
| 2. 网络层(Network) | IP(IPv4 / IPv6) |
源 IP 地址 目的 IP 地址 (如 104.18.2.1) |
解决“全球跨国导航”:在全球几十亿台设备中,规划出从你家路由器跳到美国机房的跨国路径(Routing)。 |
| 1. 链路与物理层(Link & Physical) | Ethernet(以太网), Wi-Fi, 光纤 |
相邻网卡 MAC 地址 + 高低电平/光脉冲 |
解决“相邻两站怎么搬砖”:不管全球终点在哪,只管把 0/1 比特流从你电脑网卡准确传给客厅路由器这“下一跳”。 |
[!TIP] 核心概念辨析:一句话分清
IP 地址、端口(Port)、域名(Domain)与DNS
IP 地址(如172.67.150.10):服务器在互联网上的精确经纬度门牌号(定位到哪一台机器)。端口 Port(如:443或:8787):这台机器上的分机号 / 房间号(定位到机器里跑着的哪一个进程)。因为一台服务器可以同时跑网页、数据库、SSH 远程登录,全靠端口号分流。域名与DNS:人类记不住172.67.150.10这种数字串,于是发明了字符别名api.deepseek.com(域名);而DNS(Domain Name System) 就是互联网的 114 查号台——每次你发请求前,电脑先花几毫秒问一下 DNS:“请问api.deepseek.com的 IP 是多少?”拿到数字门牌号后,再真正发包。
2. 深入 IP 层与现代网络实战:我们每天用的「IP 代理」到底在物理层干了什么?
看懂了上面的四层信封套娃,就能瞬间解开一个在调用海外 AI API、跨境数据采集与日常开发中最常遇到的实战问题:当我们说“挂个 IP 代理(如 Clash、Surge 或住宅代理)”时,底层的网络包与物理链路里究竟发生了什么?
先看一眼 IP 数据包的极简信封结构:
+-----------------------------------------------------------------------+
|  IP 头:[源 IP (Source IP): 你的电脑] -> [目的 IP (Dest IP): 目标服务器]   |
+-----------------------------------------------------------------------+
|  TCP 头:[源端口: 54321] -> [目的端口: 443]                              |
+-----------------------------------------------------------------------+
|  应用层有效载荷:HTTP 请求或加密 TLS 密文                                 |
+-----------------------------------------------------------------------+
跨国路由器在沿途转发时,只看 目的 IP 来查路由表跳站;而目标服务器收到数据包后,看 源 IP 来识别来访者身份并决定把回信寄给谁。所谓的“IP 代理”,本质上就是在两点之间安插一个合法的中间节点(Proxy Node),由它替你“撕下原寄件人标签,换贴上代理节点自己的 IP 标签”去和目标服务器打交道。
顺着刚才学的协议栈层级,现代网络工程演化出了四种不同层级的代理机制:
① 客厅路由器里的硬件级地址改写:NAT(网络地址转换)
你甚至不需要安装任何代理软件,其实每天都在使用世界上最普遍的透明 IP 代理——家里的无线路由器。
- 物理痛点:全球 IPv4 地址只有约 43 亿个,早已枯竭。你电脑分配到的通常是局域网私网 IP(如
192.168.1.5),这个地址在公网上根本不存在、也不可路由。 - 改写机制:当你的电脑向外网发包经过路由器时,路由器在硬件层面执行 NAT(Network Address Translation):先把数据包头部的
源 IP: 192.168.1.5:50001改写成路由器自己的公网 IP(如123.45.67.89:61234),并在内存映射表里记下一笔账;等远端服务器把回信寄回路由器的:61234端口,路由器查表将目的 IP换回192.168.1.5递交给你。
② 应用层盲转发隧道:HTTP CONNECT 代理
当我们访问 HTTPS 网站或调用 OpenAI API 时,数据全程受 TLS 强加密保护。我们既希望借代理换 IP,又绝不希望代理节点偷窥我们的明文 API Key,这是怎么实现的?
- 客户端先用明文向海外代理服务器发一条标准 HTTP 建连请求:
CONNECT api.openai.com:443 HTTP/1.1; - 代理服务器在海外机房替你向
api.openai.com:443建立一条 TCP 连接,并向你回复HTTP/1.1 200 Connection Established; - 化身“盲转发水管(Blind Conduit)”:此后,你的电脑与 OpenAI 直接在这根管道内进行端到端 TLS 握手与密文传输。代理节点既解不开密文,也看不懂对话内容,只负责把加密字节流原封不动推给目标服务器;而目标服务器看到的 TCP/IP 报文源 IP,则是这台代理服务器的海外地址。
③ 会话层通用管道:SOCKS5 与虚拟网卡 TUN 透明代理
- SOCKS5 代理:如果跑的不是 HTTP/HTTPS,而是 SSH、Git、数据库或游戏 UDP 流量,
SOCKS5会在传输层之上建立一条与具体应用协议无关的通用隧道,甚至支持让远端代理节点代为执行 DNS 解析(防止本地 DNS 污染)。 - 网络层
TUN透明代理(Enhanced Mode):为什么有时候系统开了代理,终端里的某个 Python 脚本或命令行工具却还是“不走代理”直接超时?因为普通代理需要软件自己主动去读HTTP_PROXY环境变量。为了治本,Clash / Surge 等现代客户端会在操作系统内核注册一张虚拟网卡(TUN Device),并修改系统默认路由表,把本机所有进程发出的每一个原始 IP 数据包强行塞进虚拟网卡,由代理客户端统一截获、打包进加密隧道发往海外——从而实现“零配置、全进程无死角透明代理”。
④ 延伸认知:机房 IP vs. 住宅 IP 代理,以及背后的法律伦理雷区
在高频数据采集或访问风控严苛的 AI 服务时,为什么云厂商服务器(机房 IP)常被拦截,而“住宅代理(Residential IP)”却能放行?
- ASN(自治系统号)身份识别:互联网上的每个 IP 段都登记了所属机构编号(如 AWS 机房为
AS16509,Google Cloud 为AS39698)。Cloudflare 或 OpenAI 的风控网关一查源 IP 属于商业云机房,便知大概率是自动化脚本,直接触发拦截;而商业住宅代理的出口是遍布全球的普通家庭宽带(如 AT&T、Comcast 家庭路由),风控网关查验 ASN 后会将其视为真实家庭用户放行。
[!WARNING] 法律与安全深度审视:百万级“住宅 IP 池”是怎么来的? 商业住宅代理的底层节点来源,是全球网络安全与法律界高度警惕的灰黑产重灾区,主要分为三类渠道:
- 明码带宽共享(违约风险):部分平台(如 Honeygain 等)以每月几十美元招募普通用户安装客户端共享闲置家庭带宽。尽管用户知情,但这通常直接违反了用户与电信运营商(ISP)签订的禁止商用转售条款。
- 免费软件隐式捆绑 SDK(合规风险):部分免费 VPN、格式转换工具或小游戏在代码中嵌入商业代理 SDK,仅在冗长的用户协议角落隐藏“同意将设备作为分布式节点”条款,此类做法屡遭应用商店清退与 GDPR 重罚。
- 恶意木马与僵尸网络(刑事犯罪):黑客在盗版软件或攻破的家用路由器固件中植入代理后门。例如 2024 年多国警方联合侦破的 “911 S5” 僵尸网络案,黑产团伙通过流氓软件劫持了全球 1900 多万个真实家庭 IP 出租给网络犯罪分子,不仅主犯面临重判,被劫持带宽的无辜家庭还面临替黑客违法流量“背锅”被警方溯源调查的巨大风险。
3. TCP 如何驯服狂野的物理网线?—— 三大可靠机制、队头阻塞与超时熔断
回到传输层,为什么全世界的网页、数据库和绝大多数 AI API 底层都默认跑在 TCP(Transmission Control Protocol) 上?因为 TCP 用三套精密的闭环机制,把随时可能丢包乱序的物理光纤改造成了绝对可靠的通道:
- 三次握手(3-Way Handshake):正式传数据前,双方必须先打三个招呼(客户端:
SYN听得到吗? 服务端:SYN+ACK听得到,你呢? 客户端:ACK我也听得到,开始发!),确认双方收发能力正常。 - 序列号与确认重传(Seq & ACK):TCP 给发出去的每一个字节都编上流水号。接收方收到第
1~1000号字节后,会回一张确认收据ACK 1001(意为“前 1000 个字节齐了,请发第 1001 号”)。若发送方超时未收到收据便会自动重发;哪怕第2001~3000号包走了近路先到,接收方的操作系统内核也会将其暂存在缓冲区里,死等第1001~2000号补齐后,再严格按序交给上层应用。 - 超时退避与四道断连熔断防线:如果网线彻底被拔掉、中间包永远重发不过来,接收方和发送方会无限死等下去吗?物理世界的操作系统准备了四道冷酷的“拔管熔断”机制:
- 指数退避重传(Exponential Backoff):发送方没收到 ACK 时,重试间隔不会固定不变,而是按
200ms400ms800ms1.6s几何级数拉长,防止把本就拥堵的网络彻底踩踏崩溃。 - 内核重试上限(
ETIMEDOUT):Linux 内核默认重试 15 次(由tcp_retries2控制,累计约 13~30 分钟)。一旦耗尽仍无音讯,内核直接宣判连接死亡,销毁 Socket 并向上层抛出ETIMEDOUT错误。 - 对端重启就地处决(
RST报文):若对方服务器突然断电重启,重启后的内核收到你发来的旧连接数据包,发现内存里毫无记录,会立即回敬一封RST(Reset)复位报文,客户端瞬间抛出ECONNRESET(Connection reset by peer)。 - 应用层主动兜底(Read Timeout):为了不让用户傻等内核那十几分钟的重试,上层应用(如前端
fetch或大模型 SDK)通常会设定30s应用层超时,到点未收到响应直接调用abort()主动掐断连接。
- 指数退避重传(Exponential Backoff):发送方没收到 ACK 时,重试间隔不会固定不变,而是按
[!NOTE] 架构演进之问:为什么
HTTP/3要抛弃功勋卓著的 TCP,改用基于 UDP 的QUIC? 成也萧何,败也萧何。TCP“死等中间缺页补齐才往上交”的铁律,带来了一个著名的致命副作用——「TCP 队头阻塞(Head-of-Line Blocking)」。 在单连接多路复用的HTTP/2中,10 个网页资源(图片、CSS、JS)混在同一根 TCP 水管里并发传输。此时只要其中 1 个文件掉了 1 个小包,哪怕另外 9 个文件的数据早就安全躺在接收方内核缓冲区里了,内核为了维护“全局字节严格按序”,也会把那 9 个无辜文件全部扣押在内核里不准交给浏览器,导致“一人掉队,全队连坐”! 这正是新一代HTTP/3彻底抛弃 TCP、改在UDP之上构建QUIC协议的根本原因:QUIC把“编号与重传”从操作系统内核搬到了应用层,让每个独立的流(Stream)各管各的序号——A 流丢包只卡 A 流,B 流和 C 流照常丝滑渲染。
4. TCP 的核心副作用:为什么会有“粘包与拆包”?应用层如何画分界线(Framing)?
理解了 TCP 的可靠性后,我们迎来了无数工程师写网络程序或流式解析器时最容易栽跟头的认知冲击:TCP 是「无边界的字节流(Byte Stream)」,它根本不知道什么叫“一条完整的消息”!
- 直觉错觉 vs. 物理真相:在你的代码里,你调用了两次发送:第一次发
{"id": 1},第二次发{"id": 2},你以为对方也会整整齐齐收到两次。但实际上,TCP 就像一根只管通水、不管分桶的自来水管!为了省运费(Nagle算法)或受限于网线单次最大运力(MTU,通常约 1460 字节),发送方内核可能会把你的两条 JSON 粘在一起,一次性发出一坨{"id": 1}{"id": 2}(俗称粘包);或者当你的大模型回复长达 5000 字节时,内核会把它腰斩拆成 4 截分批送到,对方第一次read()只读到了半截残缺的{"id": 1, "content": "你好,我是(俗称拆包 / 半包)! - 应用层的三种破局套路(Framing 分帧):既然底层的 TCP 水管不帮我们画句号,上层的应用层协议(HTTP / SSE / MCP)就必须自己定规矩画分界线。全人类一共只发明了三种画分界线的套路:
- 特殊分隔符法(Delimiter-based):约定每条消息末尾必须敲一个换行符
\n(本地 MCP 的JSON-RPC规定每行一条 JSON,绝不允许 JSON 内部出现未转义的裸换行;SSE则规定用连续两个换行符\n\n作为一条事件的结束标志)。 - 先报长度法(Length-prefixed):在信封头上先写明“后面正文一共
1024个字节”(如 HTTP 的Content-Length: 1024头,以及WebSocket的二进制帧头),接收方拿着尺子数够 1024 个字节再切一刀。 - 流式分块法(Chunked Transfer Encoding):事前不知道大模型一共会吐多少个字怎么办?那就每吐一小段,先写一行“这一小块有
25字节”,再跟上 25 字节正文;直到最后吐出一个长度为0的块,宣告全文终结!
- 特殊分隔符法(Delimiter-based):约定每条消息末尾必须敲一个换行符
问题三:为什么大模型吐字不用普通 HTTP,而要用 SSE 或 WebSocket?—— 三代通信范式的物理演进
搞懂了底层的 TCP 字节流与分帧规则,我们终于来到了 AI 应用工程的主战场:用户在网页上敲下一句提问,远端大模型需要花 30 秒钟、生成 1,000 个 Token 的长回答。这 1,000 个字是怎么跨过网络送到用户屏幕上的?
这直接对应着互联网通信协议的三层演进阶梯:
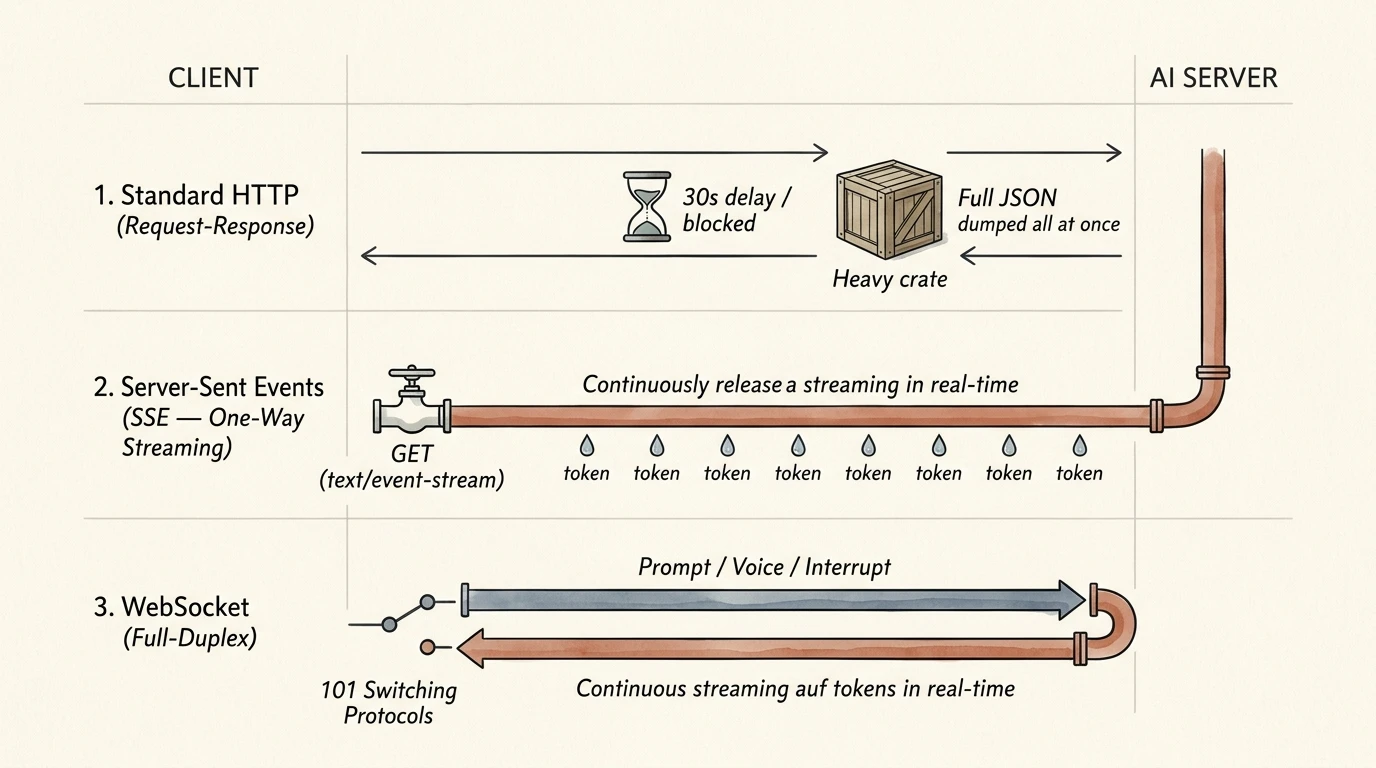 图:客户端与 AI 服务端之间三种通信协议范式的物理轨迹对比。第一轨(顶部,
Standard HTTP):传统“一问一答”模式,客户端发出一道请求后必须在空白屏幕前干等 30 秒,直到服务端将全部 1,000 个 Token 攒成一箱完整的 Full JSON 才一次性砸回并断开逻辑回合;第二轨(中部,Server-Sent Events / SSE):大模型流式输出的标准解法,客户端发起一次普通 HTTP 请求并声明 Accept: text/event-stream,服务端保持 TCP 水管不断开,每算出一个 Token 就顺着单向管道实时滴落一颗 data: token\n\n 水珠;第三轨(底部,WebSocket):全双工双向轨道,通过 101 Switching Protocols 将连接升级为两条并行的独立铁轨,允许客户端在接收音频/文字流的同时,随时逆向发送打断指令(Stop)或实时麦克风语音帧。
1. 第一阶段:传统普通 HTTP(一锤子买卖的“整箱发货”)
- 运作机制:客户端发一个
POST /chat请求过去;服务端收到后,在机房里默默让 GPU 跑满 30 秒,把 1,000 个字全部攒齐在内存里,最后打包成一个完整的 JSON 一次性返回给浏览器,当前 HTTP 回合就此结束。 - 在 AI 时代的死穴:首字延迟(TTFT, Time To First Token)等于总耗时! 用户盯着空白转圈的屏幕整整 30 秒不知道系统是不是死机了;更要命的是,许多云网关(如 Cloudflare、AWS API Gateway)对单次无响应的 HTTP 等待设有硬超时(如 30 秒或 100 秒),一旦长思考模型(如 DeepSeek-R1、o3)想了 2 分钟还没吐出一个字节,网关会直接掐断连接报错
504 Gateway Timeout!
2. 第二阶段:SSE(Server-Sent Events,服务端发送事件)—— 当今大模型 API 的绝对统治者
为了解决“干等 30 秒”的痛苦,工程师们想:能不能客户端只点一次菜,服务员不撤桌子,后厨每炒好一片肉就端上来一片? 这就是 SSE!
- 它的底层到底是什么?为什么它不需要发明新协议?
SSE根本不是什么高深的新协议,它 100% 就是普通的 HTTP 协议! 它的魔法只有两步:- 客户端发请求时,在请求头里加一句暗号:
Accept: text/event-stream; - 服务端回信时,在响应头里写上:
Content-Type: text/event-stream和Transfer-Encoding: chunked(分块传输,不写死总长度),并且故意不调用res.end()关闭这个 HTTP 响应流!
- 客户端发请求时,在请求头里加一句暗号:
- 数据长什么样?
只要这根 HTTP 水管还开着,每当 GPU 蹦出一个新 Token,服务端就往水管里塞一小行纯文本,并且严格以两个换行符
\n\n结尾(正是用问题二讲的“特殊分隔符法”解决 TCP 粘包问题):data: {"choices": [{"delta": {"content": "你"}}]} data: {"choices": [{"delta": {"content": "好"}}]} data: [DONE] - 为什么 OpenAI、Anthropic、DeepSeek 和 MCP 远程传输全都首选
SSE而不是WebSocket? 因为SSE完全寄生在标准 HTTP 之上!这意味着:你现有的所有企业防火墙、Nginx 网关、CORS 跨域配置、Bearer Token 鉴权中间件、以及浏览器的原生fetch()API,一行代码都不用改就能直接穿透支持!而且文本对话本质上是“用户问一句短话 模型回一大篇长文”的非对称单向流,用单向的SSE刚刚好,极简且极其皮实。
3. 第三阶段:WebSocket —— 双向同时开火的“全双工对讲机”
既然 SSE 这么好,什么时候它就不够用了?
- SSE 的物理局限:SSE 是一根单向水管(Unidirectional)——一旦服务端开始哗哗往外吐字,客户端在这根连接上只能听、不能插嘴!如果用户在模型吐字中途想点“停止生成”,或者想把实时麦克风语音帧源源不断传给服务端,单靠一根 SSE 连接是做不到的。
- WebSocket 的破局:
- 连接刚开始时,客户端先借用普通 HTTP 发一个“升级申请”:
GET /realtime+Upgrade: websocket; - 服务端回复状态码
101 Switching Protocols; - 从这一秒起,HTTP 协议正式退场!底层那根 TCP 连接被直接征用为一条全双工(Full-Duplex)双向二进制长连接管道——客户端和服务端可以像打微信语音电话一样,在同一纳秒内同时往对方脸上甩数据包,没有任何 HTTP 头部冗余开销。
- 连接刚开始时,客户端先借用普通 HTTP 发一个“升级申请”:
4. 一张表做好架构选型:普通 HTTP vs. SSE vs. WebSocket
| 维度 | 普通 HTTP (application/json) |
SSE (text/event-stream) |
WebSocket (ws:// / wss://) |
|---|---|---|---|
| 底层协议关系 | 标准 HTTP,一问一答即结束 | 纯正的标准 HTTP 长响应流(不断开) | 借 HTTP 握手升级后,脱离 HTTP 直接跑在 TCP 上 |
| 通信方向 | 半双工(一问一答,严格轮流) | 单向流(客户端发一次请求 服务端持续推流) | 全双工双向流(双方随时、同时互发) |
| 防火墙与网关穿透性 | ⭐⭐⭐⭐⭐(畅通无阻) | ⭐⭐⭐⭐⭐(天然兼容一切 HTTP 基建与鉴权) | ⭐⭐⭐(部分老旧企业代理或 Serverless 网关会拦截或按秒计费) |
| 断线重连与状态管理 | 无状态,每次请求天生独立 | 极其轻量(原生 EventSource 自带断线重连) |
重状态(服务端必须维护连接池、心跳包 Ping/Pong) |
| AI 时代最佳适用场景 | 获取配置、查数据库列表、非流式短接口 | LLM 聊天打字机流式输出、Agent 思考步骤推送、远程 MCP | OpenAI Realtime 实时语音对话(随时打断)、多人协同白板、高频量化行情推送 |
问题四:实战排障直觉 —— 为什么我明明写了流式 SSE,前端却还是卡了 10 秒才一次性蹦出全部文字?
这是几乎所有工程师在把 AI Agent 部署上云(接入 Nginx、Cloudflare 或各类网关)时,都必踩一次的经典血泪坑:代码在自己电脑上跑得好好的,一个字一个字丝滑往外蹦;结果一部署到线上,前端又变成了“傻等 10 秒钟,然后轰隆一下把整段话一次性砸出来”!
为什么你的“流式水龙头”在线上失效了?因为整条网络链路上,有三个好心办坏事的“中间商蓄水池(Buffer)”!
1. 幕后真凶:中间商的“攒够一桶再发货”强迫症
回顾一条 SSE 消息从你的后端代码流到用户浏览器的全过程,它至少要穿过三道关卡:
在传统的网页时代,为了提高吞吐效率、减少零碎网络包的数量,反向代理网关(尤其是 Nginx)默认开启了「响应缓冲(Proxy Buffering)」:
- 当你的 Agent 后端辛苦算出一个字
"你"(只有十几个字节)吐给 Nginx 时,Nginx 心里想:“才十几个字节就让我往外网发一次包?太亏运费了!我先拿个4KB的小水桶接着,等后端攒够4KB文字、或者后端把连接彻底关了,我再一次性打包发给用户!” - 结果就是:你的大模型吐了 500 个字还没攒够
4KB缓冲区,Nginx 就一直死死憋在肚子里不往下发,活生生把丝滑的SSE流式输出憋成了老式 HTTP 整箱发货!
2. 三行响应头,彻底砸碎中间商的“蓄水池”
要让流式 SSE 在任何云环境和 Nginx 反代下都做到“毫秒级即吐即达”,你的后端在返回 SSE 响应头时,必须配齐以下「反缓冲黄金三件套」:
HTTP/1.1 200 OK
Content-Type: text/event-stream; charset=utf-8
Cache-Control: no-cache, no-transform
X-Accel-Buffering: no
Content-Type: text/event-stream:亮明正身,告诉浏览器和沿途的现代网关(如 Cloudflare Workers):“我是流式事件,别拿普通网页那套攒包逻辑对我!”Cache-Control: no-cache, no-transform:严禁沿途 CDN 缓存,且严禁网关中间件对响应体做 Gzip 压缩转换(因为压缩算法为了凑齐字典,也会在内存里攒一大段文字才输出!)。X-Accel-Buffering: no:专门写给 Nginx 看的免死金牌!只要 Nginx 看到后端返回了这个响应头,就会立刻关掉自己的proxy_buffer小水桶,收到 1 个字节就立刻往外网转发 1 个字节。
附录 A:流式分帧(Framing)与半包重组的有限状态机模型
从形式化角度看,基于 TCP 的流式协议解析器本质上是一个将任意切分的字节块序列(Chunked Byte Stream)还原为离散应用层消息序列(Discrete Message Stream)的确定性转换器(Transducer)。
设应用层发送的完整消息序列为 ,经分隔符 (在 SSE 中为双换行符 \n\n,在 JSON-RPC 中为单换行符 \n)编码后,形成连续字节流:
由于底层 TCP 滑动窗口与 MTU 切片的任意性,接收端在时间步 实际调用 read() 获得的字节块序列为 。TCP 的保序不丢字节公理保证了拼接不变式:
但任意单个切块 的边界与消息边界 完全正交无关(即 既可能包含多个 发生粘包,也可能不含任何 甚至将某个多字节 UTF-8 汉字从中间劈开导致半包)。因此,任何工业级流式客户端都必须维护一个驻留在堆内存中的未完成残余缓冲区(Carry-over Buffer) :
- 初始状态:(空字节串);
- 状态转移(每当收到新网络块 ):先将新块流式解码并追加至残余缓冲区得到拼接串 ,随后按分隔符 进行切分:
- 消息产出与状态留存:前 个完整片段 立即作为完整消息派发给上层业务逻辑,而最后一个尚未遇到结束符 的残片被保留为下一时刻的缓冲区状态:
这一简洁的代数不变式揭示了为什么在前端手写 fetch 流式解析器时,绝不能直接对每次 reader.read() 拿到的 chunk 做 JSON.parse(),而必须先过一层 buffer 拼接与 \n\n 切分状态机。
附录 B:最小代码切片 —— 亲手写一个零依赖的 SSE 流式服务端与防拆包客户端
下面这段不到 35 行的全栈 JavaScript 代码(可直接跑在 Cloudflare Workers 或现代 Node.js 中),完整展示了服务端如何用 ReadableStream 一颗水珠一颗水珠地往外吐 Token,以及客户端如何用附录 A 的状态机安全地拆解 SSE 数据流:
// ========= 1. 服务端:创建一根不断开的 SSE 流式水管 =========
export default {
  async fetch(req) {
    const encoder = new TextEncoder();
    const stream = new ReadableStream({
      async start(controller) {
        const tokens = ["计算机", "底层", "其实", "一点", "都不难!"];
        for (const token of tokens) {
          // 严格按 SSE 规范封装:data: <JSON>\n\n
          const payload = `data: ${JSON.stringify({ text: token })}\n\n`;
          controller.enqueue(encoder.encode(payload));
          await new Promise((r) => setTimeout(r, 300)); // 模拟每隔 0.3 秒算出一个新词
        }
        controller.enqueue(encoder.encode("data: [DONE]\n\n"));
        controller.close(); // 全部吐完,关闭水管
      },
    });
    return new Response(stream, {
      headers: {
        "Content-Type": "text/event-stream; charset=utf-8",
        "Cache-Control": "no-cache, no-transform",
        "X-Accel-Buffering": "no", // 敲山震虎:禁止 Nginx 反代攒包!
      },
    });
  },
};

// ========= 2. 客户端:带残余缓冲区(防 TCP 半包/粘包)的流式解析器 =========
async function consumeSSE(url) {
  const res = await fetch(url);
  const reader = res.body.getReader();
  const decoder = new TextDecoder("utf-8");
  let buffer = ""; // 附录 A 中的残余缓冲区 r_t

  while (true) {
    const { done, value } = await reader.read();
    if (done) break;
    buffer += decoder.decode(value, { stream: true }); // stream: true 防止把多字节中文字符劈成乱码
    const parts = buffer.split("\n\n"); // 按 SSE 双换行符切分
    buffer = parts.pop() || ""; // 最后一截可能还没收完整,留回 buffer 等下一个网络包!

    for (const part of parts) {
      if (part.startsWith("data: ") && part !== "data: [DONE]") {
        const data = JSON.parse(part.slice(6));
        process.stdout.write(data.text); // 实时打字机输出!
      }
    }
  }
}