本篇导读:在前两讲中,我们先后拆解了单个进程内部的运行机制(内存栈与堆、线程与异步事件循环)以及跨进程与跨洋网络的通信链路(进程间通信、TCP 与流式协议)。然而,无论是内存里的栈与堆,还是内核管道里的字节流,都有一个致命的共同弱点——断电即焚(Volatile)。一旦服务器重启或进程退出,内存里的所有状态瞬间归零。为了让 AI Agent 的记忆、知识库与业务账本跨越时间长久存活,数据必须落入非易失性的磁盘与数据库中。这立刻引出了存储领域的两个终极矛盾:第一,操作系统如何把一块冰冷的固态硬盘(SSD)抽象成人类熟悉的“文件夹与文件名”,而当你调用
write()写文件或按下 Delete 删文件时,物理硬盘上到底发生了什么?第二,为什么我们不能直接拿一个.json文件当生产数据库,而关系型数据库(如 SQLite / Cloudflare D1 / PostgreSQL)又是如何靠B+ 树、WAL(预写式日志)与MVCC做到“既能毫秒级检索、又能百人同时读写不打架、哪怕拔电源也绝不烂账(ACID)”的? 本篇作为《计算机底层原理》系列的第三讲,围绕四个递进问题,把从底层文件描述符fd到现代数据库事务引擎与实时协同文档的物理全链路彻底打通。
问题一:为什么在 Linux 里“万物皆文件”?删掉大文件与删掉十万个小文件在底层有何天壤之别?—— 文件描述符 fd、inode 与页缓存(Page Cache)
在第二讲中我们学到,每个进程一出生就自带三根标准水管:stdin (fd 0)、stdout (fd 1)、stderr (fd 2)。当时我们把 fd 翻译成“水管编号”,它的正式学名叫文件描述符(File Descriptor)。
为什么操作系统要把“敲键盘”、“往屏幕打字”、“连网络 Socket”和“读写硬盘上的 app.db”全都统一成一个整数编号 fd?这就是 Unix/Linux 最伟大的哲学:「万物皆文件(Everything is a File)」——无论底层硬件是机械磁头、闪存颗粒还是网卡芯片,操作系统内核一律把它们包装成“支持 read(fd) 和 write(fd) 字节流的统一插座”。
那么,当你的代码写下一行 const fd = fs.openSync("app.db", "r+") 时,操作系统内核与硬盘之间到底发生了什么?
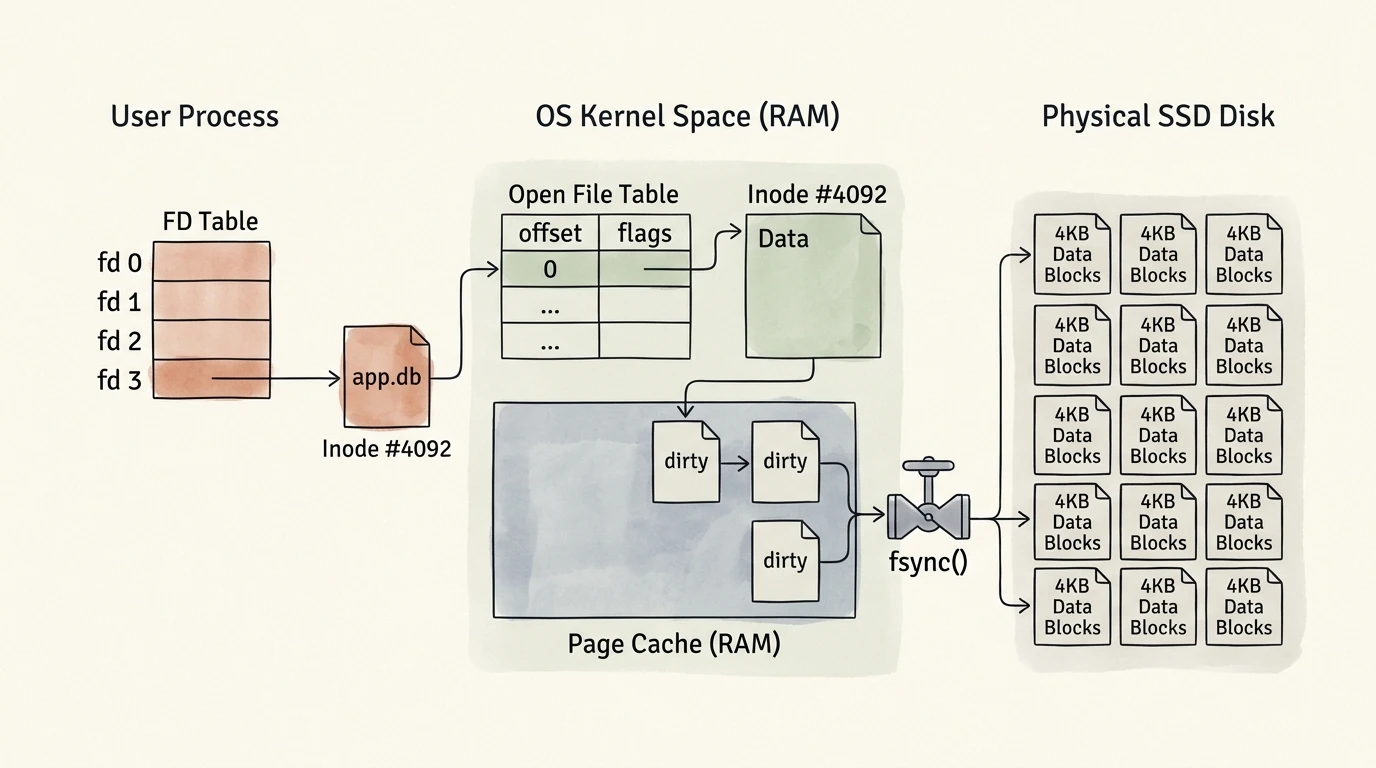 图:从用户进程到物理固态硬盘(SSD)的“三级表映射”与内核页缓存(
Page Cache)机制。左侧用户进程空间(User Process)仅持有一个轻量级整数编号 fd 3,目录文件夹也只是一张将文件名 "app.db" 映射到档案号 inode #4092 的通讯录;中间操作系统内核空间(OS Kernel RAM)维护着全局打开文件表(记录当前读写游标 offset)与 Inode Table(记录文件真实大小、权限、硬链接引用计数 ref_count 以及指向物理磁盘块的指针),并利用内存中的 Page Cache(页缓存) 暂存所有读写数据;只有当内核异步刷盘或程序显式拧开 fsync() 阀门时,内存中的脏页(Dirty Pages)才会真正穿过总线落入右侧物理 SSD 的 4KB Data Blocks 中。
1. 文件系统的真相:文件名只是“外号”,inode 才是“身份证号”
很多初学者以为,“文件名 app.db”就是文件本身。但在操作系统的物理世界里,文件根本没有名字,每个文件只有一张唯一的数字身份证——inode(Index Node,索引节点;在 Windows NTFS 中对应的概念叫 MFT Record 主文件表记录)!
当你把一个文件存进硬盘时,文件系统把磁盘切成了两大区域:
- 数据区(Data Blocks):被整齐划一地切成无数个
4KB大小的标准储物格,里面真正塞着你的 JSON 文本、图片像素或数据库字节。 inode档案室(Inode Table):每个文件占一张固定大小的档案卡(比如#4092号卡),上面精确记载着这个文件的户口本元信息(Metadata):- 文件一共有多少字节(
size)?谁有权限读写它(permissions)? - 最核心的储物格地图:这个文件的正文内容,分别散落在哪几个
4KB磁盘格子里? - 引用计数(
ref_count):当前一共有几个文件名指向我这张#4092号身份证?
- 文件一共有多少字节(
那“文件名”和“文件夹(Directory)”又是什么?
文件夹在磁盘上其实只是一张极简的“两列通讯录表格”:左边一列写着人类好记的外号 "app.db",右边一列写着它对应的身份证号 4092!
2. 删除文件的物理真相:为什么删 1 个 50GB 电影只需 0.01 秒,而在 Windows 上删一个文件夹却慢如蜗牛?
看懂了上面的“通讯录(文件夹) 身份证(inode) 储物格(Data Blocks)”三级结构,就能瞬间解开日常用电脑时最困惑的三个现象:
① 为什么按理说删文件只需要“把名字划掉”,哪怕 50GB 也应该瞬间完成?
直觉完全正确! 当你在硬盘上彻底删除一个 50GB 的单个视频文件 时,操作系统绝对不会傻乎乎地去把硬盘上那 50GB 的 0 和 1 擦除归零,它只干两件耗时不到 1 毫秒 的小事:
- 把文件夹通讯录里
"movie.mp4 -> #4092"这一行划掉; - 把
#4092号inode卡上的引用计数减为0,并在储物格登记表(Bitmap)里把那些4KB格子的状态改标为“闲置可覆盖(Free)”。 至于那 50GB 的真实画面字节,依然原封不动地躺在闪存颗粒里,直到未来某天你下载新文件时把它们覆盖掉——这也是为什么误删文件后,只要立刻停止往硬盘写新东西,数据恢复软件就能顺着残留的数据块把文件完整捞回来!
② 既然删文件只是改个标记,为什么在 Windows 资源管理器里删一个项目文件夹(如 node_modules)会卡半天“正在计算剩余时间”?
既然删 1 个文件只需 0.1 毫秒,为什么在 Windows 上删一个只有几百 MB 的代码文件夹却慢得让人抓狂?因为慢的从来不是“文件体积大”,而是“小文件数量多(比如 10 万个几 KB 的碎文件)”,外加 Windows 图形界面的三大额外包袱:
- 第一遍空跑“数人头”(进度条强迫症):当你用鼠标右键点击删除时,Windows 资源管理器为了给你画出那个绿色的“已完成 X%”进度条,会先递归钻进所有子文件夹,把 10 万个小文件挨个点名数一遍总个数和总大小——光这第一遍“点名”就要耗掉几十秒随机磁盘读取,此时连 1 个文件都还没开始删!
- 默认“搬家进回收站”而非真删除:如果不按
Shift + Delete,普通删除其实是把 10 万个文件搬家到$Recycle.Bin目录,并为每一个小文件单独生成一份记录原路径与删除时间的元数据小文件——10 万次删除瞬间膨胀成了 20 万次磁盘小文件写入! - 杀毒软件与索引器的“三堂会审”:在 Linux 终端执行
rm -rf时,内核只在底层静默摘除inode;而在 Windows 下,每删 1 个小文件都会触发系统级广播,旁边的 Windows Defender 实时杀毒、Windows Search 搜索索引、甚至云盘同步插件都会扑上来拦截检查一次。10 万个文件乘以三四道关卡,把固态硬盘的队列彻底堵死。
💡 实战爽招:在 Windows 上如果要秒删含几十万小文件的目录,别用鼠标右键,直接在终端运行
cmd /c "rmdir /s /q node_modules",跳过 UI 点名与回收站,速度立刻快出十倍!
③ 运维经典血泪坑:为什么在 Linux 上用 rm -rf huge.log 删掉了 50GB 日志,用 df -h 一看硬盘还是 100% 满的?
因为操作系统的物理回收铁律是:只有当磁盘上的文件名引用计数 link_count == 0,且内存中没有任何进程的 fd 打开着这个文件(open_fd_count == 0)时,磁盘上的 4KB 储物格才会被真正释放!
当你的后端服务还在后台源源不断往 huge.log(对应的 fd 3)写日志时,你执行 rm 只是把文件夹通讯录里的名字擦掉了,但进程手里的 fd 3 依然死死拽着 #4092 号 inode 不放!正确解法:要么重启一下那个进程(让 fd 3 松手关闭),要么不删文件而是直接用 > huge.log 把 #4092 号文件原地清空。
3. 内存页缓存(Page Cache)与 fsync:为什么 write() 成功了,拔电源还是会丢数据?
在第一讲中我们对比过硬件速度:CPU 读内存只要 100 纳秒,而读写物理 SSD 硬盘却需要 100,000 纳秒(慢 1,000 倍)。如果每次你的程序调用 write() 写 10 个字节,操作系统都要真刀真枪去擦写一次物理硬盘,整台电脑会慢得像幻灯片一样!
为了掩盖磁盘的龟速,操作系统内核设计了一个蓄水池——内存页缓存(Page Cache):
- 当你的程序调用
write(fd, "hello")时,操作系统内核只是把这几个字节拷贝到了内核内存条(RAM)里的Page Cache缓冲区,把这个内存页标为“脏页(Dirty Page,意为已修改但尚未落盘)”,紧接着立刻告诉你的程序:“写好啦!继续往下跑吧!”(耗时仅几微秒)。 - 至于这些躺在内存条里的“脏页”什么时候真正写进物理硬盘?内核有一个后台保洁线程,默认每隔
5 秒~30 秒、或者当脏页攒够一定比例时,才慢悠悠地把它们批量刷进物理 SSD。 - 破局阀门
fsync(fd):如果在这 5 秒内突然停电,内存里的脏页就会灰飞烟灭。为了给数据库这种“一分钱都不能丢”的系统兜底,操作系统提供了强制拧开物理阀门的系统调用fsync(fd)——调用它时,程序会原地等待,直到内核把该文件在内存Page Cache里的所有脏页真正烧录进物理 SSD 闪存颗粒并收到硬件确认信号后,才允许返回!
问题二:为什么不能直接拿一个 .json 文件当生产数据库?为什么 Git 仓库放在 Google 云盘里会冲突损坏?—— 原子操作、并发锁与 CAS
很多刚开始写独立产品或 Agent 原型的开发者都会想:“搞什么数据库那么麻烦,我直接在服务器上放一个 users.json 文件,每次有人注册就读出来、改一下数组、再 fs.writeFileSync('users.json', ...) 写回去,不就完事了吗?”
在单人本地脚本里这确实能跑;但只要放到线上多人并发访问,或者遇到意外断电,这个 .json 文件会在三分钟内彻底崩盘。
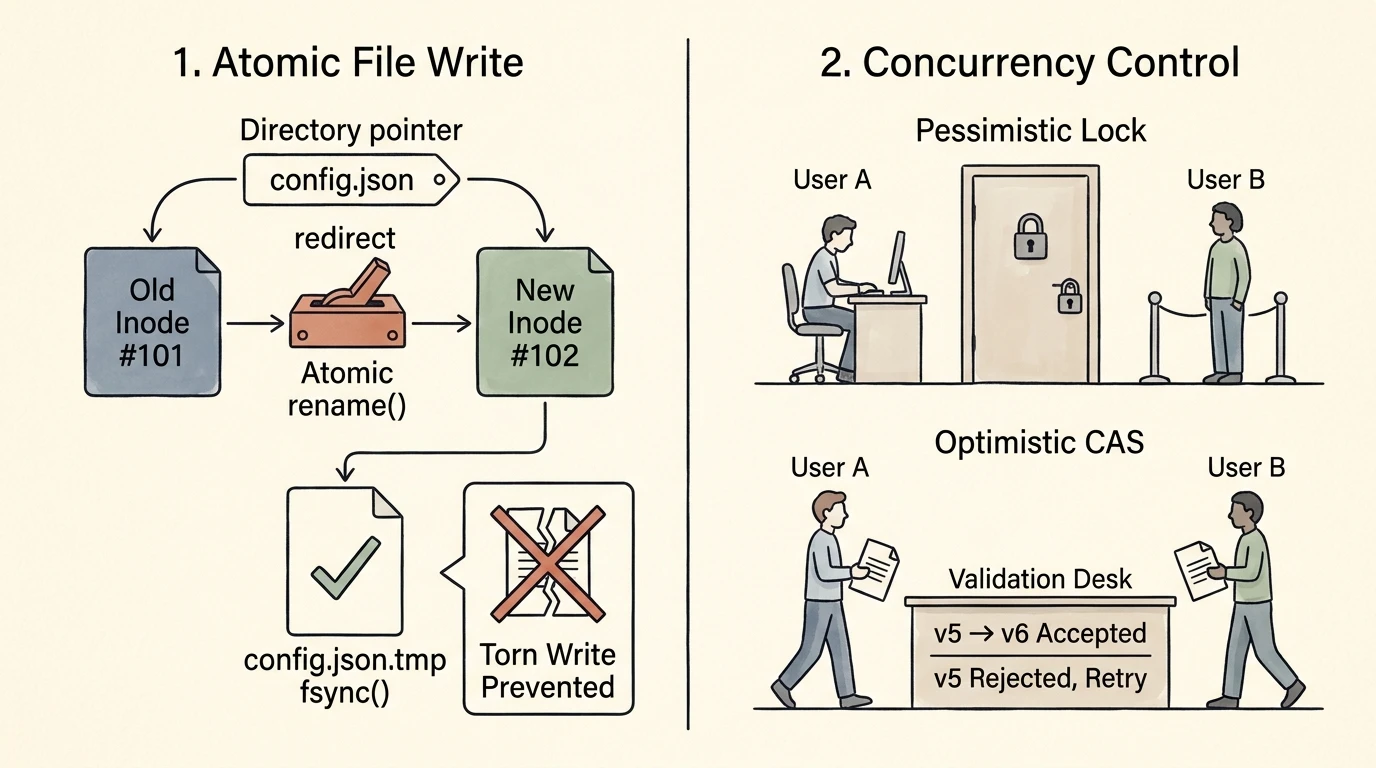 图:安全文件保存的“原子换牌法”(左)与并发冲突控制的两种哲学流派(右)。左面板展示如何避免直接覆盖写导致的“半截文件撕裂(Torn Write)”:程序先将完整内容写入影子临时文件
config.json.tmp(New Inode #102)并对它执行 fsync(),随后拨动操作系统的 Atomic rename() 开关,把文件名 "config.json" 的指针从旧 #101 一步拨到新 #102,最后再对父目录执行一次 fsync(),把“这个名字现在指向新 inode”这条目录项改动也钉到盘上——rename 只保证其他进程要么看到旧文件、要么看到新文件(运行时原子可见),父目录这一次同步才是让替换结果扛过断电的那一步;右面板对比了并发修改时的两种策略:上方 悲观锁(Pessimistic Lock) 像进屋立刻反锁大门的独占房间,门外用户必须排队干等;下方 乐观并发控制(Optimistic CAS) 则不锁大门,允许所有人同时拿复印件修改,仅在交卷柜台核对版本号印章(v5 -> v6 放行通过,拿着过期 v5 的人被驳回重试)。
1. 什么是「原子操作(Atomic Operation)」?为什么普通写文件不是原子的?
在古希腊语中,“原子(Atom / atomos)”的本意是“不可再被切分的最小颗粒”。 在计算机世界里,如果说一个动作是原子操作,意思就是:无论这个动作在底下包含多少步,在外部任何观察者(其他进程、其他线程、之后的任意一次读取)眼里,它都像按电灯开关一样,只有「完全没发生(0%)」和「已经彻底做完(100%)」两种状态——绝不可能被看到卡在「做了一半(50%)」的中间态!
但这里必须立刻划一条界线:「其他进程看到的原子可见性」和「断电之后东西还在不在」是两个层面的问题。原子性说的是切换那一刻不会露出中间态,它本身并不承诺切换之后的结果已经写进了存储设备——后者取决于数据本身和目录项是否都真正完成了 fsync。
-
非原子操作(普通
writeFileSync的断电撕裂灾难): 当你的users.json有10MB时,直接调用writeFileSync覆盖它,操作系统会先把原文件清空为0字节,再像银行柜员数钞票一样,一页一页(每次4KB)往里写。如果刚写到4MB时容器重启或停电,后6MB和结尾的右大括号}就永远消失了——留下一份无法解析的半截废铁(俗称 Torn Write 文件撕裂)。 -
如何用「写临时文件 → fsync → rename → fsync 父目录」搓出不会撕裂、也扛得住的原子替换? 如上图左侧所示,全世界的工业级软件(包括 Git、VS Code、npm)在保存关键配置文件时,从来不直接覆盖原文件,而是严格走下面四步(以 Linux 等支持目录同步语义的文件系统为准):
- 先写影子临时文件:把新内容完整写进旁边的
config.json.tmp(哪怕这时候断电,原文件config.json也毫发无损); - 同步临时文件内容:对
config.json.tmp调用fsync(),确保每一个字节都已经稳稳烙在物理 SSD 上;这一步失败必须向上抛出,绝不能当作成功; - 原子换牌(
rename("config.json.tmp", "config.json")):调用操作系统的rename系统调用。在问题一的文件夹通讯录里,这仅仅是把"config.json"这个名字对应的指针从旧inode #101一步拨动到新inode #102!操作系统内核保证同分区下的rename()是原子的:任何其他进程在任意时刻去读这个名字,读到的要么是完整无损的旧文件、要么是完整无损的新文件,绝不可能读到写了一半的残废文件; - 同步父目录:
rename改的是父目录里的目录项,而这条目录项此刻还躺在内核页缓存里。必须打开父目录拿到它的fd,再对它执行一次fsync()(Linuxfsync(2)手册对此有明确要求):这一步成功之后,才能对外说“这次替换断电后仍然有效”。
换句话说:第 2 步保证新文件的内容落盘,第 3 步保证读者看到的原子可见性,第 4 步才保证目录项的替换落盘。少了第 4 步,断电后完全可能只剩下一份谁也叫不出名字的新
inode,临时文件名也没了。当然,以上都建立在一条前提上:存储设备如实执行了fsync(把缓存里的数据真正写进介质并把结果回报给内核),缓存对自己撒谎的盘、或者不实现这套同步语义的文件系统(部分网络文件系统)都给不了这个保证。 - 先写影子临时文件:把新内容完整写进旁边的
2. 解决并发打架的两种宇宙观:悲观锁(Pessimistic)vs. 乐观并发控制(Optimistic / CAS)
解决了断电撕裂,如果两个用户在同一毫秒给同一个账户各充值 100 元(原余额 0 元),线程 A 和线程 B 同时读出 0、各自加上 100 写回去,最后账上只有 100 元(白白丢了 100 元,称为丢失更新 Lost Update)。为了防止两个人同时改同一份数据撞车,计算机演化出了如上图右侧所示的两大门派:
| 维度 | 悲观锁(Pessimistic Locking) | 乐观并发控制(Optimistic Concurrency Control / CAS) |
|---|---|---|
| 人性假设 | “总有刁民想跟我抢!” —— 每次干活前,先拿一把大铁锁把房间门反锁上,别人全在门外排队等着,我改完交卷了再开门。 | “世上哪有那么多巧合?” —— 进门绝不锁门,大家各自拿一份复印件回去改;交卷时核对一下版本号(version),如果发现我改的期间没人动过,直接盖章生效;如果被人捷足先登改过了,我这版作废重试! |
| 核心细分机制 | 读写锁(Read-Write Lock): • 共享读锁( S-Lock):大家只看不改,允许 100 个人同时进屋看书;• 排他写锁( X-Lock):只要有 1 个人要动笔改,屋里不能有任何其他人(包括读者和写者)。 |
比较并交换(Compare-And-Swap, CAS):在数据表里多加一列 version。读出时 version = 5,写回时执行:UPDATE account SET balance = 200, version = 6 WHERE id = 1 AND version = 5; |
| 优缺点与代价 | 优点:绝对稳妥,写冲突再高也不会白干活。 缺点:一旦有人持锁卡住(或忘了释放锁引发死锁 Deadlock),后面成百上千个请求全部排队阻塞。 |
优点:全程无锁阻塞,在“读多写少”场景下吞吐量极高。 缺点:如果 100 个人同一毫秒秒杀同一件商品,99 个人会交卷失败并疯狂循环重试。 |
[!WARNING] 实战破案:为什么把
.git代码仓库放在 Google Drive / OneDrive 云盘里,经常会报错锁死甚至仓库损坏? 很多开发者尝试把带.git的项目放在 Google 云盘或 OneDrive 里跨电脑同步,结果频繁遇到Unable to create '.git/index.lock': File exists报错,甚至整个 Git 仓库损坏。把上面学的“原子重命名 + 悲观文件锁”拼在一起,案情瞬间水落石出:
- Windows 强制排他文件锁撞上云盘后台扫描:当你在终端执行
git status或git commit时,Git 严格遵循我们刚讲的原子替换法——先创建临时锁文件.git/index.lock,写完后再rename覆盖.git/index。然而在 Windows 上,文件锁是内核级强制排他锁(Mandatory Locking)!就在.git/index.lock刚诞生的第 1 毫秒,Google Drive 的后台同步进程监控到新文件出现,立刻扑上去打开.git/index.lock准备计算哈希并上传;第 2 毫秒,Git 写完了想把index.lock重命名替换掉,却发现该文件正被 Google Drive 捏在手里,Windows 内核当场拒绝 Git 的操作并报错崩溃!- 跨文件“脑裂”毁掉 Git 对象树:更危险的是,Git 的一次提交需要同时更新
.git/objects/下的多个压缩包和.git/refs/heads/main指针文件,要求这几个文件同生共死(跨文件原子一致);而网盘同步是按单个小文件逐个异步排队上传的。一旦网盘先把更新后的main指针同步到了另一台电脑,而对应的代码对象包还在路上,整个.git仓库的指针链条就会当场断裂!所以工程铁律是:纯文档放云盘,代码仓库永远只用git push / pull同步,或者在云盘设置里把.git加入忽略列表!
问题三:数据库如何做到“秒级检索 + 拔电源绝不烂账”?—— 事务 ACID、B+ 树 索引原理与 WAL(预写式日志)
既然裸 JSON 文件既不能按行快速跳读、又扛不住并发和断电,关系型数据库(从轻量的 SQLite / Cloudflare D1 到重型的 MySQL / PostgreSQL)究竟施了什么魔法?
它们向开发者交付了数据库界最高贵的契约——事务(Transaction)的 ACID 四大特性,并在底层用 B+ 树 + WAL(预写式日志) 这对黄金搭档将其变成了物理现实。
1. 一张表拆穿 ACID:谁是最终目的?谁是底层手段?
很多教科书把 ACID 四个词并列罗列,其实它们根本不在同一个逻辑层级上——其中 C(一致性) 是业务追求的最终目的(账本不能乱),而 A(原子性)、I(隔离性)、D(持久性) 则是数据库内核为了保住 C 而提供的三个物理护法:
| 特性 | 英文与中文 | 直白物理定义(以“A 向 B 转账 100 元”为例) | 如果没有它会发生什么鬼故事? | 数据库内核靠什么物理机制实现它? |
|---|---|---|---|---|
A |
Atomicity (原子性) |
全做,或者全不做(All or Nothing)。A 扣 100 和 B 加 100 这两步操作被绑成一颗不可分割的原子。 |
A 的 100 元刚扣掉,服务器突然断电重启;B 没收到钱,100 元人间蒸发。 | Undo Log(回滚日志):改数据前先把旧值记下来;如果中途崩溃或报错 ROLLBACK,按回滚日志把改了一半的数据倒带还原。 |
I |
Isolation (隔离性) |
并发执行的多个事务互不干扰。A 给 B 转账转到一半时,决不允许旁边的查账事务看到“A 扣了钱但 B 还没加上”的中间残态。 | 查账员在转账中途扫了一眼总账,发现公司总资金平白无故少了 100 元,当场报警(脏读)。 | 读写锁 + MVCC(多版本并发控制):让每个读者读取特定时间点的历史快照(Snapshot),与正在修改的最新版本物理隔离。 |
D |
Durability (持久性) |
一旦提示“转账成功(COMMIT)”,哪怕下一秒机房断电,这笔账也绝对不能丢(前提:存储设备如实兑现了 fsync,见附录 B 的说明)。 |
手机屏幕已经弹出“支付成功✅”,结果银行服务器重启后说“刚才还在内存 Page Cache 里没刷盘,不算数”。 |
WAL / Redo Log(预写式重做日志)+ fsync:事务提交时,强制把修改流水刷进物理硬盘才敢向用户返回成功(SQLite 中对应 WAL + synchronous = FULL,NORMAL 只保证一致性,见附录 B)。 |
C |
Consistency (一致性) |
能量守恒定律(不烂账):转账前 A + B = 1000 元,无论中间经历多少次并发、报错还是断电,转账后 A + B 必须严格等于 1000 元。 |
账本总额对不上,或者余额变成了负数。 | 由 A + I + D 三大底层护法 + 业务字段约束共同保驾护航的最终结果! |
2. 深入拆解 B+ 树:它究竟是怎么建立索引、又是怎么做到“只跳 3 次就在 2,000 万行数据里抓出目标”的?
为了解决裸 JSON 文件“查一条数据要从头扫到尾”的痛点,几乎所有关系型数据库都把数据按一个个固定大小的数据页(Page,通常为 4KB 或 16KB) 组织成一棵矮胖的 B+ 树(B+ Tree):
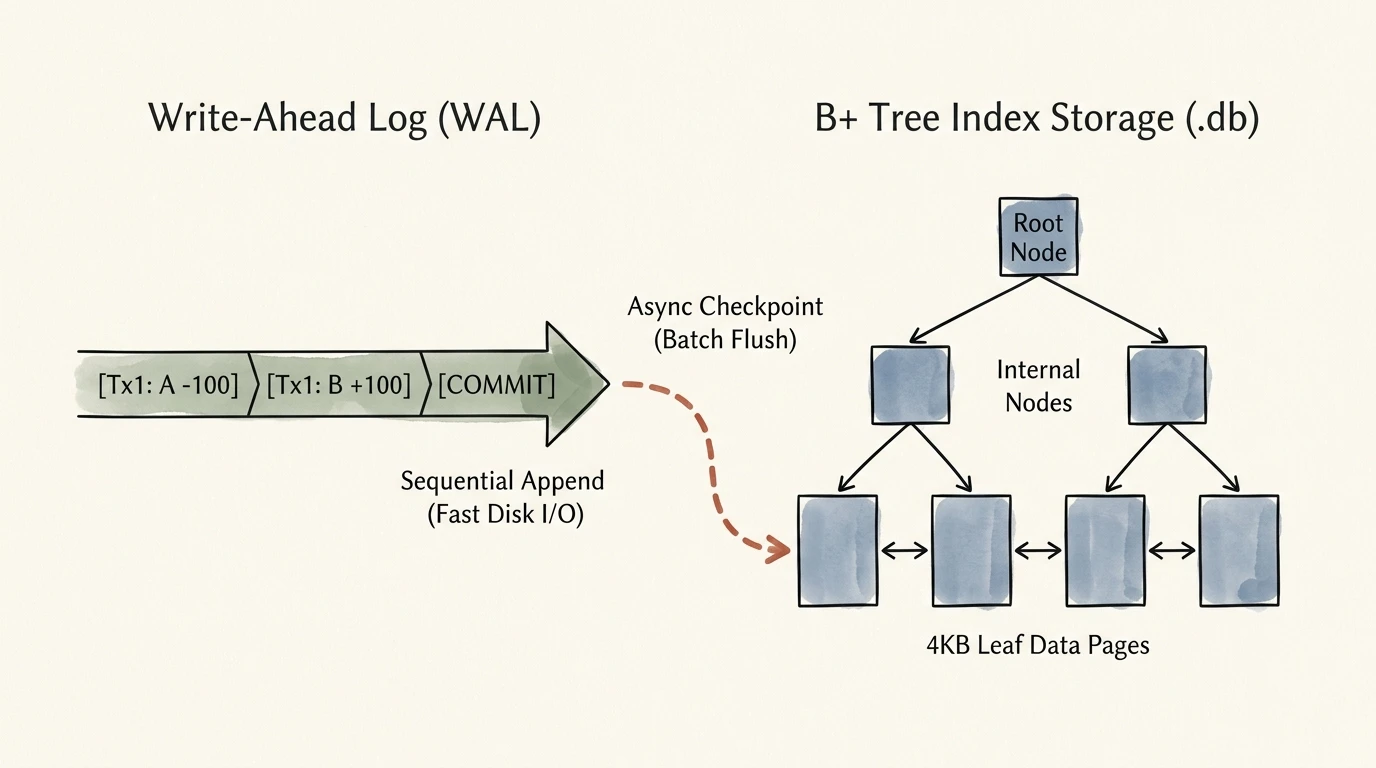 图:数据库存储引擎中
WAL(预写式日志,左)与 B+ 树(主数据存储,右)的协同架构。右侧 B+ 树 将海量数据按主键排序存放在底层的 4KB Leaf Pages(叶子页)中,通过顶层与中层稀疏索引(Root -> Internal Keys),仅需 3 次内存/磁盘跳转即可在千万行数据中精准定位目标页;然而直接修改 B+ 树 涉及跨多个随机页的写入(Random I/O),既慢又有断电撕裂风险。因此数据库引入左侧绿色的 WAL Log(预写式日志):任何事务提交时,仅需以极速的顺序追加(Sequential Append) 将变更记录写到 WAL 末尾并 fsync 即可立即返回成功;随后再由后台 Async Checkpoint(异步检查点) 批量将变更分摊刷回右侧的 B+ 树 磁盘页中。
很多人第一次看到“跳 3 次就能查 2,000 万行”都会觉得不可思议:这棵树到底是怎么建出来的?如果新数据乱序插进来,怎么保证分类和顺序永远正确? 你可以把 B+ 树 想象成一本《新华字典》的检字目录 + 会自动一分为二的活页夹:
① 为什么只有 3 层就能装下 2,000 万行?(“目录与正文彻底分家”带来的百倍扇出)
如果用普通的二叉树(每个节点只分左、右 2 个叉),存 2,000 万行需要 层,查一次要跳 25 层,太慢了!
而 B+ 树 的核心绝招是“上层目录绝对不印正文”(就像字典前面的目录页只写“某字在第几页”,绝不把长篇造句印在目录里):
- 第 1 层(树根 Root)与第 2 层(中间目录层 Internal):只存极瘦的“主键路标(8 字节整数)+ 下级页号指针(6 字节)”。这样一个
16KB的目录页,足足能塞下 约1,200个分叉路标! - 第 3 层(底层叶子页 Leaf Pages):真正存放按主键
id严格从小到大排好序的一行行完整数据,且相邻叶子页之间用双向箭头串成一条链表。 - 算一笔小学乘法:
- 第 1 层(树根,常驻内存):1 个目录页,往下分出
1,200个叉; - 第 2 层(二级目录,常驻内存): 个目录页,再往下分出 ;
- 第 3 层(底层数据叶子页):144 万个数据页,假设每个页只装 15 行用户数据,总容量就是 !
当你查
WHERE id = 58时,先在树根比大小(发现58落在50~90分支,跳去中间页) 在中间页比大小(跳去对应的叶子页) 在叶子页里拿到数据。总共只跳 3 次!
- 第 1 层(树根,常驻内存):1 个目录页,往下分出
② 当新数据乱序插进来时,怎么保证分类永远正确?(满页自动分裂 Page Split)
如果我先存了 [10, 20, 30, 40, 50, 60] 把一个叶子页塞满了,这时候突然要插进一个 58,装不下怎么办?
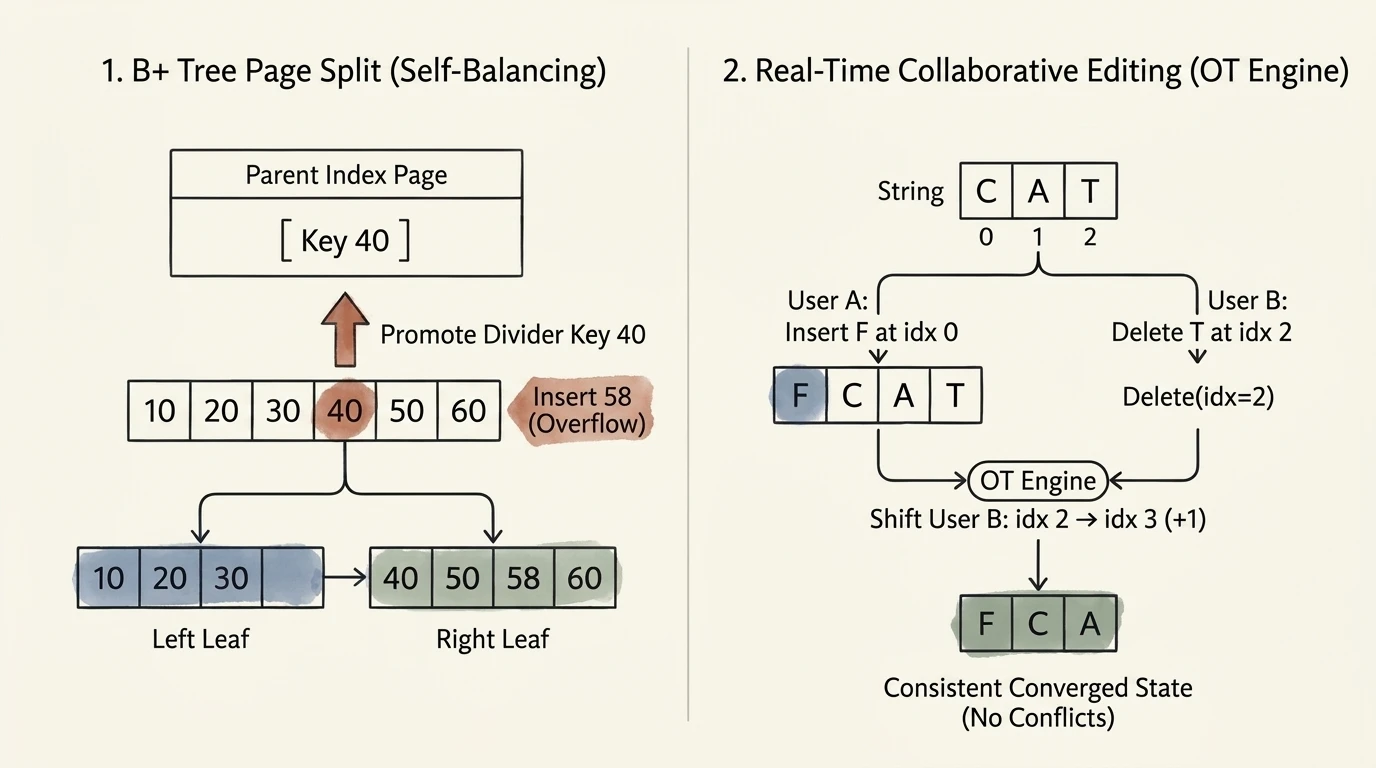 图:左面板展示
B+ 树 在乱序插入时保持永远有序与平衡的核心机关——页分裂(Page Split):当满载的叶子页 [10|20|30|40|50|60] 收到新插入的 58 时,自动从正中间一刀劈成左页 [10|20|30] 与右页 [40|50|58|60],并将分界路标 Key 40 向上推送登记到父目录页(Parent Index Page)中;右面板展示实时协同文档(如 Google Docs)的 WebSocket + OT(操作转换) 机制:当用户 A 在单词 "CAT" 的位置 0 插入 'F'、而用户 B 在同一毫秒删除位置 2 的 'T' 时,中央 OT Engine 自动将用户 B 的删除坐标向右平移 +1(idx 2 -> idx 3),使双方无需加锁报错即可无损收敛为 "FCA"。
如上图左面板所示,B+ 树 靠「页分裂(Page Split)」自动维持绝对秩序:
- 如果那个叶子页还没满:直接在页内把
60往后挪一格,把58插在50和60之间; - 如果那个叶子页已经塞满了:数据库立刻向文件系统新领一张空白叶子页,把原页从正中间一刀劈成两半——前半截
[10, 20, 30]留在左页,后半截[40, 50, 58, 60]搬进新领的右页;同时往上一层父目录页里补登记一条新路标Key 40 -> 右页号! - 如果我不是按主键
id查,而是按邮箱WHERE email = 'a@b.com'查呢? 当你执行CREATE INDEX idx_email ON users(email)时,数据库其实就是按邮箱的字母序('a...' < 'b...' < 'c...')额外再建了一棵瘦身版B+ 树(二级索引),它的底层叶子节点里只写“这个邮箱对应的主键id = 888”。查邮箱时先在邮箱树跳 3 下拿到id = 888,再去主树跳 3 下拿整行数据(俗称“回表”)。
3. 存储引擎的核心矛盾:为什么有了 B+ 树,还非要发明 WAL(预写式日志)?
看懂了上面 B+ 树 的页分裂与二级索引,你就立刻发现了它的致命写痛点:随机改页(Random I/O)既慢又怕断电!
假设你在一个事务里改了 3 个用户的余额,这 3 个用户分散在 B+ 树 的第 105 号页、第 8902 号页和第 45001 号页。如果在每次提交时,都要强行把这 3 个相隔十万八千里的 4KB 页当场刷进物理硬盘:不仅跨块擦写极慢,而且万一刚刷完第 105 号页突然断电,后两个页没刷进去,整棵 B+ 树 的目录结构就会错乱报废!
计算机存储界最优雅的破局:日志先行(WAL, Write-Ahead Logging)!
数据库科学家想出了一个绝妙的主意:当用户提交修改时,我根本不去碰磁盘上那棵庞大的 B+ 树 主文件!
- 内存改树 + 顺序写流水:先把改好的
B+ 树页面留在内存Page Cache里,同时打开旁边一个专门的流水账小本本(WAL日志文件),只往文件最末尾顺序追加(Sequential Append) 一行字:“事务 #88:把第 105 页的 A 改成 900,把第 8902 页的 B 改成 1100,已提交!”,然后对这行小字做一次极速的fsync()。 - 为什么顺序追加快 100 倍且绝对安全? 因为不需要在磁盘上东奔西跑找位置,永远只往文件尾巴上啪啪盖章!哪怕写到一半断电,重启后看一眼最后一行没有完整的
COMMIT印章,直接忽略这半截废话即可;只要印章盖上了,哪怕内存里的B+ 树还没刷入主硬盘文件就停电了,重启后数据库只要照着WAL流水账重放(Redo)一遍,1 秒钟就能把账本完璧归赵! - 后台秋后算账(Checkpoint 检查点):等平时不忙、或者
WAL小本本记满了几百页时,数据库后台再启动 Checkpoint(检查点),把WAL里攒下的修改一次性批量腾抄回B+ 树主文件中。
问题四:在 SQLite 与 Cloudflare D1 实战中,为什么开启 WAL 就能读写齐飞?数据库快照与 Google Docs 实时协同有何区别?
如果你用 Python、Node.js 或在本地开发 Agent 服务时用过 SQLite(或者在 Cloudflare Workers 上用过基于 SQLite 构建的 Serverless 数据库 D1),你一定见过一个臭名昭著的报错:
Error: SQLITE_BUSY: database is locked
为什么全网吹爆的 SQLite 默认会这么容易锁死?而为什么老手总是叮嘱你:“新建 SQLite 数据库的第一行代码,必须无脑执行 PRAGMA journal_mode = WAL;”?
把传统模式和 WAL 模式放在显微镜下一对比,真相大白:
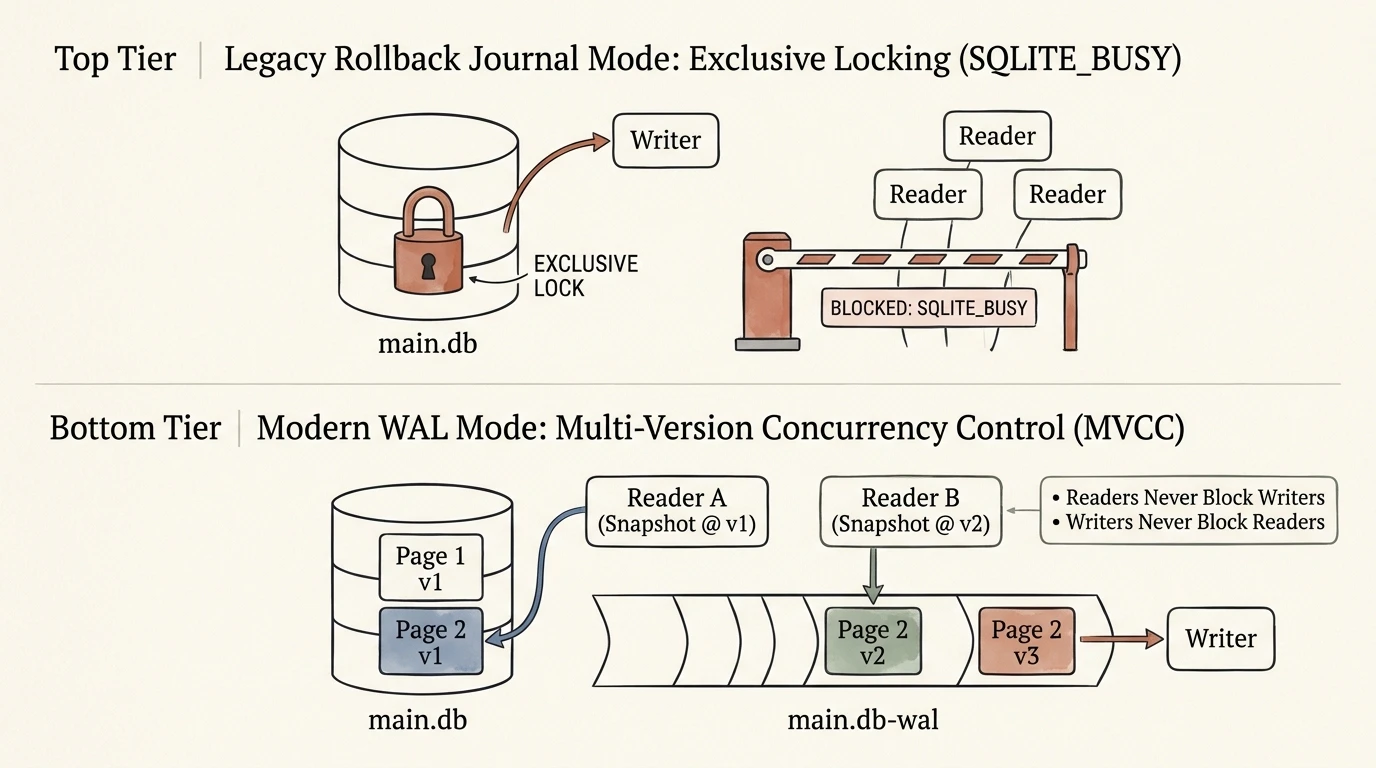 图:SQLite 两种日志模式下的并发读写物理机制对比。上半部分(传统
Rollback Journal 默认模式):写者(Writer)在修改数据时需要直接改写 main.db 原文件,因此必须给整个数据库加上一把沉重的红棕色排他大锁(EXCLUSIVE LOCK),此时所有试图查询数据库的读者(Readers)全部被挡在门外并触发 SQLITE_BUSY 报错(“写阻塞读,读也阻塞写”);下半部分(现代 WAL + MVCC 模式):写者根本不碰 main.db 原文件,而是直接将新版本数据页(如 Page 2 v2、Page 2 v3)顺序追加到旁边的 main.db-wal 文件尾部;与此同时,不同时刻进场的读者各自持有一个轻量级“尾标快照(Snapshot End-Mark)”,Reader A 顺畅读取 Page 2 v1,Reader B 顺畅读取 Page 2 v2,写者则在尾部继续追加 Page 2 v3——真正实现“读绝不阻塞写,写也绝不阻塞读”!
1. 传统默认模式(Rollback Journal)的死穴:直接在原件上动刀,读写彻底互斥
由于历史兼容原因,SQLite 新建数据库时默认处于古老的回滚日志模式:
- 当一个写事务要修改
main.db里的第2页时,它先把第2页的原始备份拷到旁边的main.db-journal临时文件里,然后直接提刀去改写main.db原件里的第2页! - 正因为它直接改原件,如果这时候允许另一个读请求进来读
main.db,读者就会看到改了一半的脏数据!因此,在传统模式下,只要有 1 个写者在写,整个数据库文件就会被加上排他大锁,所有读者全部被拒之门外;反过来,只要还有 1 个读者在读,写者也绝对不准动刀!
2. 开启 WAL 模式的魔法:用“只追加不改原件”免费白嫖 MVCC(多版本并发控制)
当你执行了一句咒语 PRAGMA journal_mode = WAL; 后,磁盘上会多出两个伴生文件:main.db-wal(预写日志)和 main.db-shm(我们在第二讲学过的共享内存索引!),并发规则瞬间进化:
- 写者只往
.db-wal尾巴上贴便利贴: 当写者要把第2页的数据从v1改成v2时,它根本不碰main.db原文件,而是把改好后的整张新页面Page 2 (v2)直接追加到main.db-wal文件的末尾! - 读者靠“时间戳书签(End Mark)”实现天然的快照隔离:
- 当
读者 A在t=1时刻发起一句SELECT查询时,它记下当时.db-wal的末尾位置作为自己的书签。哪怕在这句查询执行的几毫秒内,写者在书签后面又追加了v2、v3新版本,读者 A对书签后面的内容一律视而不见,安安静静读完它的v1版本! - 当
读者 B在t=2时刻进场发起查询时,它的书签定格在v2的位置,读到的就是最新提交的v2版本!
- 当
- 最终工程收益:
- 读与写彻底解耦:1,000 个并发读者和 1 个写者可以在同一毫秒全速狂飙,读者永远不会挡住写者的路,写者也永远不会挡住读者的路!
- 配齐排队等待(
busy_timeout):由于.db-wal只有一个尾巴,同一时刻仍然只允许 1 个写者往尾巴上追加。只需再配上一句PRAGMA busy_timeout = 5000;(遇到其他写者正在追加时,先礼貌排队等最多 5 秒,别立刻报错),单机 SQLite 就能轻松抗住每秒数千次的并发读写!
3. 延伸打通:既然数据库书签读的是快照,那怎么看到最新改动?Google Docs(谷歌文档)的实时多人协同又是怎么实现的?
看到 读者 A 拿着 v1 书签、读者 B 拿着 v2 书签,你可能会问:“那如果读者想看到最新的 v3 改动,该怎么刷新?而且像 Google Docs、Figma 或飞书文档那样,别人每敲一个字母我屏幕上立刻实时跳出来,难道也是靠刷数据库实现的吗?”
这里其实对应着计算机世界里两种完全不同时间尺度的刷新机制:
① 普通网页与业务系统:数据库书签“用完即焚”,重查一次即自动刷新!
千万不要误以为 读者 B 领了 v2 书签就会抱一辈子!在数据库里,一张 MVCC 书签的寿命仅仅等于那一句 SELECT 查询执行的 1~5 毫秒。查询一结束,书签当场销毁;下一秒当网页再发一条新的 SELECT 请求时,数据库会自动把最新的 .db-wal 末尾(v3)发给它做新书签,自然就看到了最新数据。
② Google Docs / Figma 实时协同:第二讲 WebSocket + 内存 OT/CRDT 坐标平移 + 第三讲 WAL 落盘!
如果两个人同时在线改同一篇 Google 文档,绝不能靠“每 0.1 秒查一次数据库”或“整行覆盖 + 乐观锁”(否则两人同时打字,后提交的人会不断弹窗报错*“保存冲突,请重敲”*)。 回顾前面图 4 右侧的示意图,现代实时协同文档实际上把我们第二讲和第三讲的底座合体了:
- 实时通道(不靠轮询查库,靠
WebSocket广播):打开文档时,A 和 B 的浏览器与服务器建立一条第二讲学过的WebSocket全双工长连接。A 每敲下一个字母'F',发出的是一条极小的动作指令Op: 在位置 0 插入 'F';服务器内存收到后,0.01 秒内直接顺着 WebSocket 推送给 B 的浏览器,B 的屏幕当场多出一个'F'! - 同时改同一个词怎么不打架?(
OT操作转换 /CRDT坐标平移):假设原词是"CAT"(位置0, 1, 2),A 在位置0插入'F'(变成"FCAT"),B 在同一毫秒删除位置2的'T'。中央协同引擎(OT Engine)发现 A 在前面插了 1 个字,会自动把 B 的删除坐标+1平移(从删位置2自动修正为删位置3),最终两人屏幕严丝合缝地收敛为同一个词"FCA"! - 断电保护(靠
WAL顺序追加操作流):你在文档里敲的每一个动作指令Op,在服务器内存广播的同时,也会像数据库的WAL一样顺序追加记录到磁盘日志流里——这不仅保证了机房断电一个字不丢,还让你能拖动“文档历史记录”像看电影一样回放每一秒的打字过程!
附录 A:事务隔离级别与 WAL 崩溃恢复的形式化不变式
从计算机科学的形式化视角看,数据库事务引擎的核心任务是在并发交错调度(Interleaved Schedule)与随时可能发生的非预期断电(Crash Failure)下,维持全局状态转移的代数不变式。
1. 两个核心日志法则(ARIES 极简公理)
设内存页缓存中的数据库状态为 ,持久化磁盘上的主数据文件为 ,预写日志序列为 。任何满足 ACID(特别是原子性 A 与持久性 D)的存储引擎必须严格遵守以下两条物理写盘偏序公理(记 表示 必须在 之前完成 fsync 落盘):
-
WAL先行公理(Write-Ahead Logging Rule,保原子性A): 在内存中的任何脏数据页 被刷回磁盘覆盖原数据页 之前,记录该次修改前旧值(Undo 信息)的日志条目 必须已经持久化落盘: 物理意义:确保一旦在覆盖原磁盘页中途断电,重启后仍能根据已落盘的 将半成品脏页倒带回滚。 -
提交强制刷日志公理(Force-Log-at-Commit Rule,保持久性
D): 在向客户端返回事务 提交成功()之前,该事务所产生的所有修改重做记录 及最终的提交标记 必须全部完成持久化落盘: 物理意义:只要客户端收到了成功回执,即便此时内存脏页尚未刷入主文件 ,重启后也能通过顺序重放 中的 Redo 记录无损重构出完整状态。⚠️ 这条公理要真成立,前提是引擎被配置成每次提交都同步日志(SQLite 里就是
synchronous = FULL)。若配置成NORMAL,日志写入可能还停在操作系统缓存里,掉电或操作系统崩溃后最近已提交的事务会被回滚。另外要分清两种故障:应用进程崩溃时内核和页缓存都还活着,数据未必丢;整机断电或内核崩溃时缓存一起消失,只有真正落盘的才算数。
2. 四级事务隔离谱系(Isolation Levels)
当并发度从绝对串行放松以提高吞吐量时,不同隔离级别对三种并发异常(脏读 Dirty Read、不可重复读 Non-repeatable Read、幻读 Phantom Read)的拦截能力构成如下格结构:
| 隔离级别(从弱到强) | 脏读(读到别人未提交的修改) | 不可重复读(同一事务内两次读同一行值不同) | 幻读(同一事务内两次按条件查出的行数不同) | 典型实现机制 |
|---|---|---|---|---|
| 读未提交(Read Uncommitted) | ❌ 可能发生 | ❌ 可能发生 | ❌ 可能发生 | 读完全不加锁,直接读最新内存脏页 |
| 读已提交(Read Committed) | ✅ 杜绝 | ❌ 可能发生 | ❌ 可能发生 | 每条 SELECT 语句各自生成一张全新的 MVCC 快照(PostgreSQL 默认) |
| 可重复读 / 快照隔离(Repeatable Read / Snapshot) | ✅ 杜绝 | ✅ 杜绝 | ✅ 绝大多数杜绝 | 整个事务 BEGIN 时固定一张 MVCC 快照,事务内所有查询复用该书签(SQLite WAL / MySQL InnoDB 默认) |
| 可串行化(Serializable) | ✅ 杜绝 | ✅ 杜绝 | ✅ 彻底杜绝 | 严格两阶段锁(2PL)或可串行化快照隔离(SSI 冲突检测) |
附录 B:最小代码切片 —— 原子文件写入(写临时文件 → fsync → rename → fsync 目录)与 SQLite WAL 并发事务实战
下面两段极简代码切片,分别展示了如何在不依赖数据库时用原子替换法在 Linux 上安全保存 JSON 配置文件(内容与目录项都完成同步后才返回成功),以及在 Python 中初始化一个连持久性也兑现的 SQLite WAL 事务配置:
// ========= 1. 裸文件防撕裂保存:Write-Temp + fsync + Atomic Rename + fsync(目录) =========
import fs from "node:fs";
import path from "node:path";

// 仅适用于 Linux 等「对目录 fd 执行 fsync 即可同步目录项」的文件系统;Windows 不支持对目录这种用法。
// 所有 fsync 失败都向上抛出:只有拿到「目录项也已落盘」的确认,才有资格对外宣称保存成功。
export function saveJsonAtomically(filePath, data) {
  const dir = path.dirname(filePath);
  const tempPath = path.join(dir, `.${path.basename(filePath)}.${process.pid}.tmp`);

  // Step 1: 先打开影子临时文件并写入完整 JSON
  const fd = fs.openSync(tempPath, "w");
  try {
    fs.writeFileSync(fd, JSON.stringify(data, null, 2), "utf-8");
    // Step 2: 拧开 fsync 阀门,强制将内核 Page Cache 脏页刷入物理 SSD 闪存(失败即抛,不吞)
    fs.fsyncSync(fd);
  } finally {
    fs.closeSync(fd);
  }

  // Step 3: 调用操作系统原子重命名,替换目录中的 inode 指针
  // 其他进程只会看到旧文件或新文件,但「改完名字」不等于「这次改名字已经落盘」
  fs.renameSync(tempPath, filePath);

  // Step 4: 对父目录执行 fsync,把这条目录项改动也钉进存储设备
  // 少了这一步,断电后可能只剩一份没有名字的新 inode
  const dirFd = fs.openSync(dir, "r");
  try {
    fs.fsyncSync(dirFd);
  } finally {
    fs.closeSync(dirFd);
  }

  // 四步全部成功,此时才能认为这次替换在断电后依然成立
}
# ========= 2. SQLite 生产级高并发初始化与 ACID 原子转账事务 =========
import sqlite3

def init_production_db(db_path: str) -> sqlite3.Connection:
    conn = sqlite3.connect(db_path, timeout=5.0)
    # 黄金三件套:开启 WAL 多版本并发读写 + 每次提交同步刷日志 + 5秒写锁排队等待
    conn.execute("PRAGMA journal_mode = WAL;")
    # FULL:提交时要等 WAL 真正落盘才返回,才配得上正文「提交成功后断电不丢」的承诺
    conn.execute("PRAGMA synchronous = FULL;")
    conn.execute("PRAGMA busy_timeout = 5000;")
    return conn

def transfer_funds(conn: sqlite3.Connection, from_id: int, to_id: int, amount: int):
    if not isinstance(amount, int) or isinstance(amount, bool) or amount <= 0:
        raise ValueError("转账金额必须为正整数 (amount > 0)!")
    # 使用 with conn 自动开启事务:扣款与入账同属一个事务,
    # 代码块正常结束自动 COMMIT,抛出任何异常(含入账未命中)自动 ROLLBACK!
    with conn:
        cur = conn.execute(
            "UPDATE accounts SET balance = balance - ? WHERE id = ? AND balance >= ?",
            (amount, from_id, amount),
        )
        if cur.rowcount == 0:
            raise ValueError("余额不足或账户不存在,触发事务原子回滚 (ROLLBACK)!")
        cur = conn.execute(
            "UPDATE accounts SET balance = balance + ? WHERE id = ?",
            (amount, to_id),
        )
        # 入账必须恰好命中 1 行:收款账户不存在时此处抛异常,连上面已完成的扣款一起回滚
        if cur.rowcount != 1:
            raise ValueError("收款账户不存在或 id 不唯一,触发事务原子回滚 (ROLLBACK)!")
关于
synchronous的取舍:WAL + synchronous = NORMAL能保持一致性(不会读到半截数据),但同步大多不在每次事务提交时发生,掉电或系统崩溃后可能回滚最近已提交的事务——这是性能与持久性之间的明确取舍,不能拿它冒充“提交成功即不丢”。WAL + FULL才是每次提交都追加并同步 WAL 的配置,本文示例因此用FULL。最后,以上保证最终仍依赖存储设备如实执行fsync;另外要区分应用进程崩溃(内核缓存还在,通常不会丢)与系统崩溃/断电(缓存一起消失,只有落盘的才算数)。