重学 ML 03:浅层学习的几何巅峰 —— 支持向量机与核技巧
本篇导读:在第一篇与第二篇中,我们以概率建模(MLE / MAP)为主线,让所有样本共同参与拉扯出一条平均平衡边界。本篇我们彻底切换视角,进入浅层学习的几何巅峰——支持向量机(SVM):从“抗微扰最宽安全区”出发,推导拉格朗日对偶与 KKT 条件的样本稀疏性,拆解高斯核通往无穷维空间的核技巧,并在文末打通它与现代 Transformer 注意力机制的数学同构。
1. 历史的转折:当概率拟合遇到“几何抗扰动”
在前两站中,我们的核心武器是逻辑回归(对数几率回归)与极大似然/最大后验估计(MLE / MAP)。那是一套典型的概率建模思维:
-
每个样本点无论离分界线多远,都会通过 Sigmoid 函数计算出概率 ,并在交叉熵损失中贡献一份梯度力 ;
-
最终学出的分界线,是全场所有正负样本共同拔河、妥协出的平均平衡线。
然而,在 20 世纪 90 年代初,统计学习理论奠基人弗拉基米尔·瓦普尼克(Vladimir Vapnik)与同事提出了另一个直击本质的几何问题:
如果两类数据在空间中是线性可分的,那么能把它们完美切开的直线(超平面)有无穷多条。在这无穷多条“训练误差都为 0”的分界线中,哪一条才是在面对未知测试数据时最稳健、最不容易出错的?
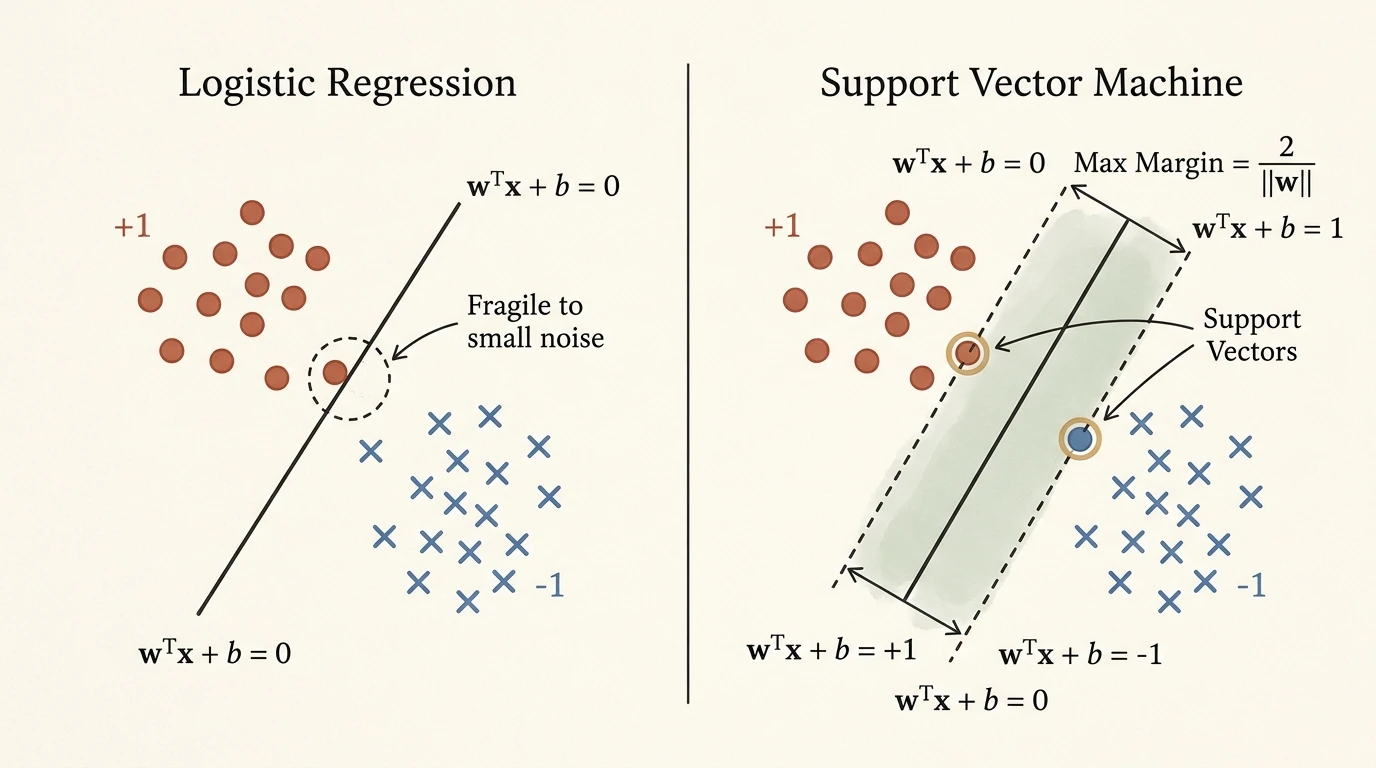 图:分类边界的几何抗扰动对比——左图传统线性分类/逻辑回归受全样本平均拉扯,分界线贴近样本簇边缘,微小噪声抖动即可导致越界误判;右图支持向量机(SVM)在两类边界之间撑开最宽的“无人安全走廊” ,由压在 边界上的支持向量锁定最优决策面
1.1 走钢丝 vs 走大桥:间隔(Margin)的物理直觉
想象你在一条峡谷上方通行:
-
如果分界线紧贴着某一侧的训练样本擦肩而过,虽然当前训练集全部判对,但未来测试样本只要在测量噪声或环境波动下出现哪怕一丁点抖动(),就会直接越界被判错;
-
最稳健的策略,是找到正负两类样本点集之间最宽的那条“真空走廊(隔离带)”,然后把分类超平面不偏不倚地架设在这条走廊的正中央。
这条走廊的宽度,就叫做间隔(Margin)。撑起这条走廊边缘、离分界线最近的那几个关键样本点,就是后来名震天下的支持向量(Support Vectors)。
认知飞跃: 从逻辑回归到硬间隔 SVM,机器学习完成了一次深刻的视角切换——从“最大化全样本的后验概率似然”,转向了“最大化分类边界的抗扰动几何安全距离(最大间隔原理)”。
2. 几何定标:为什么最大化间隔等价于 ?
要把“撑开最宽走廊”的几何直觉变成计算机能解的数学方程,我们需要严格定义“点到超平面的距离”,并消解掉方程里的尺度冗余。
2.1 点到超平面的几何距离
设特征空间中的分类超平面方程为:
其中 是决定超平面朝向的法向量(垂直于超平面,指向正类一侧), 是决定超平面平移位置的截距。
同时,为了书写极其优美,SVM 将二分类标签约定为 (而非逻辑回归里的 )。
对于空间中任意一个样本点 ,它到超平面 的垂直欧氏距离是多少?
通过基础解析几何(将向量投影到单位法向量 上,完整推导见 附录 A),该垂直距离为:
由于我们规定正例 应该落在 一侧,负例 应该落在 一侧,因此只要样本被正确分类, 与 就必然同号!于是绝对值符号可以直接写成两者的乘积:
其中分子 被称为函数间隔(Functional Margin)。
2.2 尺度冗余的消解:用“定标尺”锁死分子
我们的目标是:让所有样本中离超平面最近的那个几何距离 达到最大:
初看这个式子,分子和分母同时含有未知参数 ,是个非凸的分式优化问题。但仔细观察超平面方程 ,你会发现一个极其重要的几何事实:
超平面的参数具有“齐次缩放不变性”:如果你把 同时乘以任意正数 (比如翻 10 倍变成 和 ),方程 表示的是空间中完完全全同一个超平面!法向量方向没变,位置也没变,点到平面的真实几何距离 (分子分母的 刚好约掉)也丝毫未变,唯独分子的函数间隔 被人为放大了 倍。
既然 的整体缩放倍数是个可以任意调节的自由度(如同你可以选“米”或“厘米”做标尺),我们干脆强行定下规矩(Canonical Hyperplane 规范化定标):
在同一超平面的所有等价参数缩放版本中,我们只选那个让离分界线最近的样本点的函数间隔恰好等于 的 !即规定:
这一步“定标”堪称神来之笔!一旦规定了最近点的分子等于 :
-
所有样本的约束条件立刻简化为简洁的线性不等式:
-
走廊的总宽度(裕度 Margin)瞬间只剩下了分母:
-
压在上边界()的正类支持向量到中心平面的距离是 ;
-
压在下边界()的负类支持向量到中心平面的距离也是 ;
-
两条平行边界之间的总隔离带宽度就是:
-
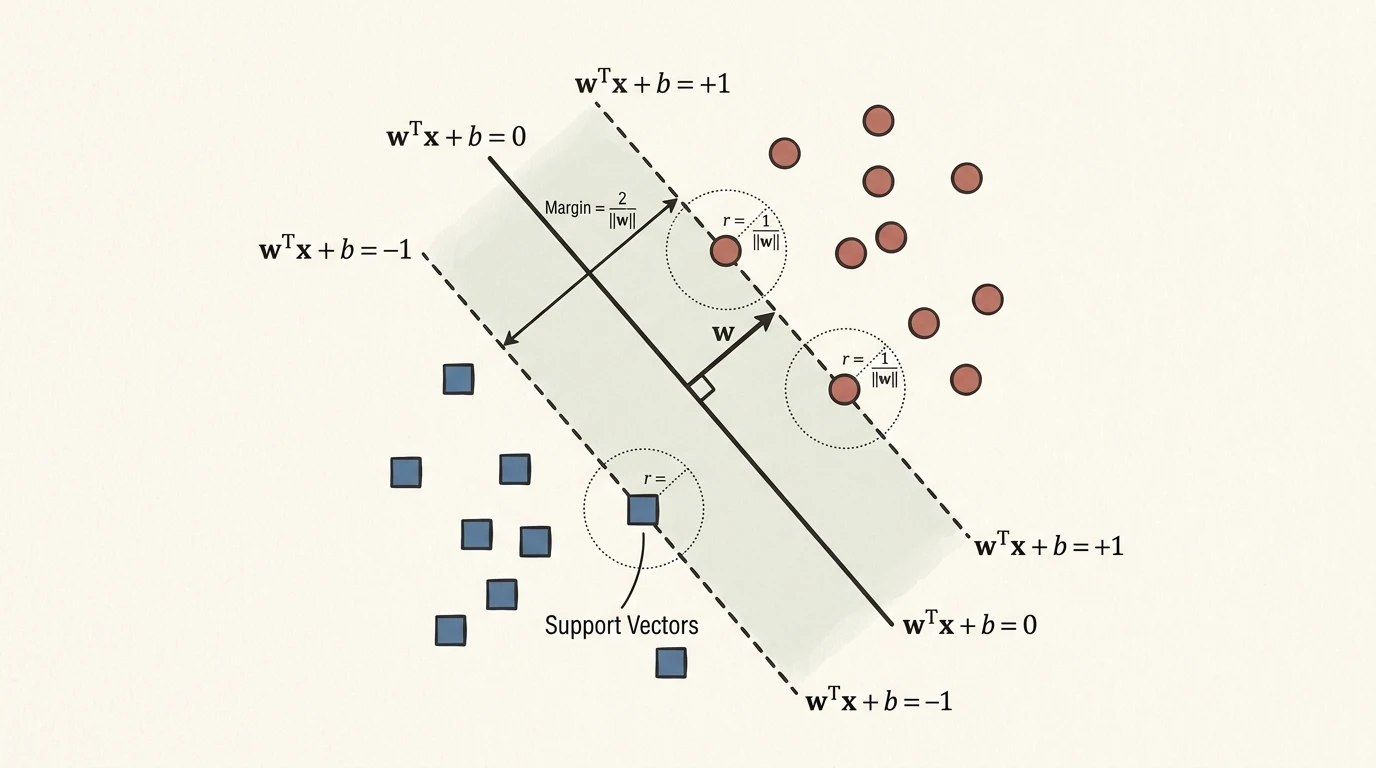 图:支持向量机的规范化几何定标与最大间隔走廊——通过锁死最近样本(支持向量)的函数间隔 ,将最大化走廊总宽度 转化为在每个支持向量周围吹起半径为 的抗微扰安全球
2.3 鲁棒优化视角(Robust Optimization):为每个样本吹大“抗微扰安全球”
很多人初学最大间隔时,会以为“撑开最宽走廊”只是一个纯粹的直观几何比喻。然而在现代鲁棒优化(Robust Optimization)理论中,最大化几何间隔与“最坏情况下的输入微扰鲁棒性(Worst-case Input Perturbation Robustness)”在代数上是完全等价的!
假设我们观测到的训练样本 存在现实测量噪声或物理环境波动,或者未来的未知测试样本会在 附近发生半径为 的欧氏空间微扰 (即真实输入可能落在闭球 内)。
如果我们提出一个最严苛的抗扰动鲁棒分类要求:
“无论扰动 朝哪个最坏的方向偏移,只要其欧氏范数 ,该样本在扰动后的新位置 都必须依然被正确分类,绝不越界!”
用数学语言写出这个最坏情况(Worst-case)鲁棒约束:
我们来严密求解内层的极小化对抗问题:
展开左侧括号:
为了让 达到极小值,扰动向量 必然选择与法向力 严格反向的最坏攻击方向,且使出极限范数 。由柯西-施瓦茨不等式(Cauchy-Schwarz Inequality),该内积的极小值精确为:
代回原鲁棒不等式,立即得到:
这一推导揭示了震人心魄的几何本质:
-
左侧 恰恰就是样本到分类平面的几何间隔 ;
-
右侧 则是系统能够100% 抵御未知微扰的安全球半径(Robustness Radius)!
因此,“最大化两类样本间的几何间隔”,在物理上完完全全等价于“在每个训练样本点周围吹起一个最大的等半径欧氏抗扰安全球 ,并要求所有安全球互不越界、彼此相切”!
在规范化定标 下,这个极限抗扰半径被精确锁死为:
要让抗扰半径 尽可能大,就必须让分母 尽可能小——这也正是上图左侧清晰呈现的几何画面:支持向量周围的抗扰球恰好与中心超平面相切!
2.4 硬间隔 SVM 的主问题(Primal Problem)
想要让走廊宽度 (即抗扰安全球半径 )最大,等价于让分母 最小;为了求导后消去系数 且变成光滑的二次函数,我们等价地最小化 。
于是,硬间隔支持向量机的基本型(主问题)正式诞生:
与第二站 L2 正则化的跨时空回响: 在第二站中,我们从高斯先验导出 ,那时我们说“把 压小是为了防止权重膨胀、压制方差”。 而在第三站,SVM 给了 一个如刀削般锐利的几何解释:当分类边界处的函数输出被定标为 时, 越小,意味着从 爬升到 的斜坡越平缓,两类边界在物理空间中被撑开的安全隔离带 就越宽!统计上的“参数范数收缩”与几何上的“最大安全间隔”,在这里实现了深刻的底层统一。
3. 拉格朗日对偶与 KKT 条件:为什么绝大多数样本“毫无话语权”?
观察上面的主问题:目标函数 是严格凸的二次函数(关于 ),约束条件 是线性的。这是一个标准的凸二次规划(Convex Quadratic Programming, QP)问题,直接丢给现成的数值求解器就能算出唯一的全局最优解 。
既然主问题直接就能解,为什么所有的机器学习教材(包括《西瓜书》)都要大费周章地引入拉格朗日乘子 ,把它转化成“对偶问题(Dual Problem)”?
这里藏着 SVM 走向巅峰的两个核心秘密:
-
揭示解的稀疏结构(物理力学直觉):证明最优超平面仅仅由极少数压线的“支持向量”决定,其余海量内部样本权重严格为 ;
-
为“核技巧(Kernel Trick)”铺平道路(维度解耦):主问题的变量维度是特征维度 (若升维到无穷维就无法直接计算 );而对偶问题中所有的特征向量全部收缩为样本间的成对内积 ,从而让我们能够在无穷维空间中“隐式切分”!
3.1 拉格朗日函数与“零和博弈”鞍点直觉
为了把 个不等式约束 融合进目标函数,我们为每个样本引入一个非负的拉格朗日乘子(Lagrange Multiplier) ,构造广义拉格朗日函数:
为什么主问题等价于 ?你可以把它想象成一场“立法者与找茬裁判的博弈”:
-
先固定 ,让裁判 极大化 :
-
如果你选的 违背了任意一个样本的约束(即存在某个 使得 ),裁判只需把对应的 拧到 ,总目标就会瞬间爆炸为 !
-
反之,如果你选的 乖乖遵守了所有约束(即 恒成立),由于 ,第二项 ;裁判为了尽量让 大一点,只能无奈地把所有严格小于 0 的项对应的 全部设为 ,此时 刚好还原为 。
-
因此,外层再对 求极小,就完全等价于原约束问题!由于该主问题是凸二次规划且在严格线性可分时满足 Slater 条件(强对偶性成立,详细数学条件见 附录 B),我们可以合法地交换 和 的顺序,先固定 对无约束的 求极小,再对 求极大:
3.2 极值消元:从特征参数 到样本内积
在内层固定 ,对 求偏导并令其等于 :
-
对法向量 求偏导:
-
对截距 求偏导:
将上面两个关系式代回拉格朗日函数 中消去 和 (完整代数消元步骤见 附录 B),便得到了只含 的对偶问题(Dual Problem):
3.3 力学图景与 KKT 互补松弛:为什么只有“压线点”决定天下?
请仔细审视刚刚求导得出的三个核心关系,它们与最优解必须满足的 KKT 条件(Karush-Kuhn-Tucker Conditions) 共同构成了极其美妙的刚体静力学平衡图景:
-
最优法向量是样本的线性组合(表示定理的雏形):
这说明:分类超平面的法向量 ,完全是由训练样本 按照权重 叠加而成的!
-
KKT 互补松弛条件(Complementary Slackness)—— 稀疏性的根源:
在最优解处,每个样本的乘子 与其约束余量必须满足乘积为零:
两个非负数的乘积为 ,意味着它们至少有一个必须为 !这直接将全体训练样本切分成了命运截然不同的两类:
-
绝大多数内部样本(远离走廊边缘):它们老老实实待在安全区深处,满足严格不等式 (即括号项 )。为了满足乘积为 ,它们的拉格朗日乘子必须严格等于零:!
这意味着:这些内部样本在公式 中的系数是 !哪怕你把走廊外面的那 99% 的样本点随手删掉、或者在安全区内任意挪动位置,最优分类超平面纹丝不动!
-
极少数压线样本(支持向量 Support Vectors):唯有当 时,该样本才对 有贡献;而一旦 ,括号项就必须等于 ,即:
这些点分毫不差地刚好压在走廊的两条平行边界线 上!它们就像在峡谷两侧顶住隔离板的那几根柱子,独自“支撑”起了整个分类超平面——这就是“支持向量(Support Vectors)”这一名字的精确由来。(注:几何上刚好压在边界 上的点,在退化情形下也可能出现 ;在严格意义上,我们将 的样本定义为支持向量。)
-
-
静力学合力与力矩平衡:
如果把隔离带看作一块刚性挡板,每个支持向量 都在垂直于边界的方向上对挡板施加一个推力,力的大小就是 ,正例()往一个方向推,负例()往反方向推:
-
对偶约束 ,正是正负两侧总推力大小相等、方向相反的“静力学受力平衡条件”(否则挡板就会发生平移)!
-
而 则是两侧推力共同锁定的法向朝向。
-
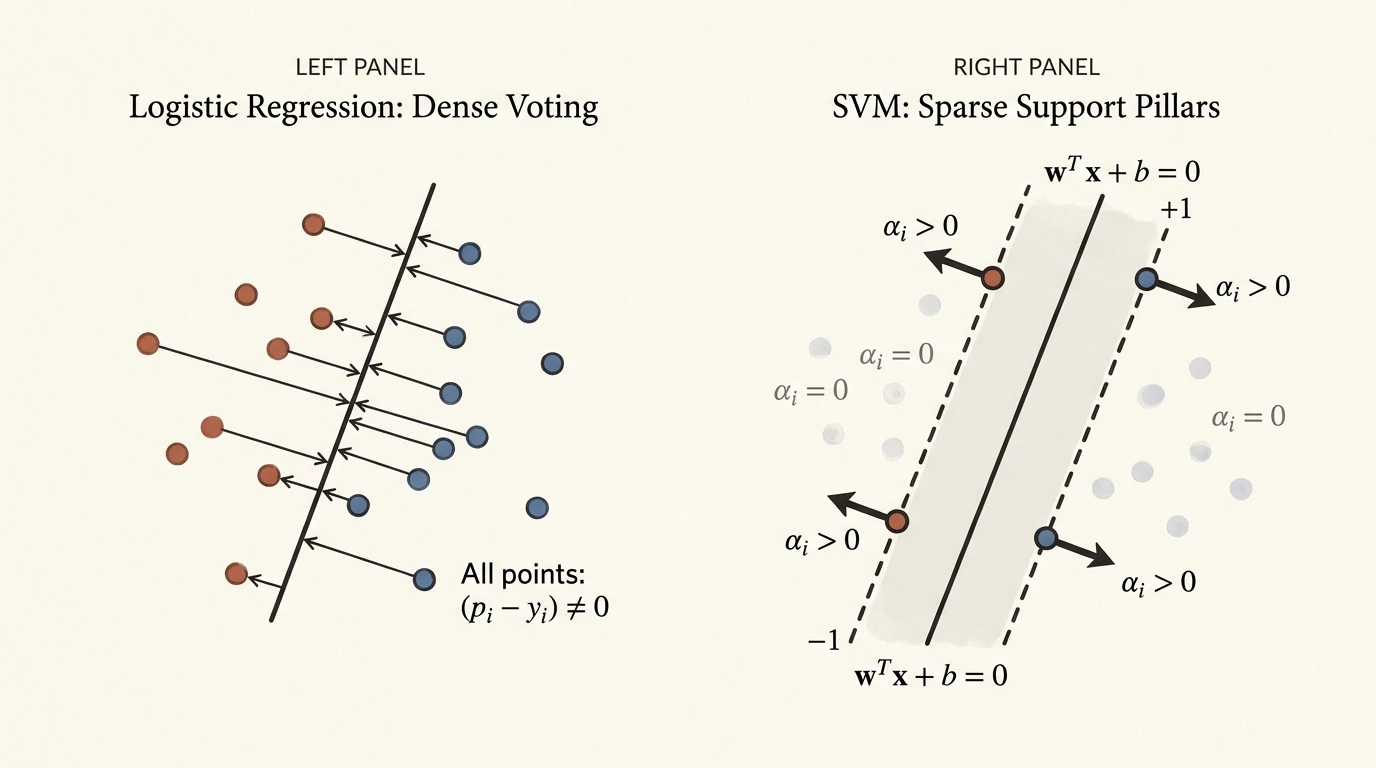 图:KKT 互补松弛条件下的力学图景对比——左图逻辑回归中所有样本均具非零梯度权重 ,全员参与拉扯分界线;右图支持向量机中安全区内部样本乘子严格归零(,删去亦不影响分界线),唯独压在 边界上的支持向量()如刚性支柱般锁定超平面
-
偏置 的反解与测试期新样本预测:
-
为什么对偶问题求完还要单独反解 (且为什么要取平均)?
回看第 3.2 节:当我们对拉格朗日函数求偏导 时, 乘上了 ,从而在对偶目标函数里直接消掉了。这意味着求解对偶问题只能直接拿到乘子 和法向量 ,而截距 必须事后借由支持向量反推出来。
怎么反推?根据互补松弛条件,任意一个支持向量 ()都精确压在间隔边界上,满足 。两边同乘 (利用 ),理论上随便挑任意一个支持向量 ,就能直接算出:
但在计算机数值求解二次规划(如 SMO 算法)时,由于浮点数精度与收敛停止阈值的存在,求出的 会有微小的数值误差,导致代入不同支持向量 算出来的 在小数点后略有波动。因此,在工程实践中(如《西瓜书》式 6.18),通常会把所有支持向量各自算出的 取算术平均,以此抵消数值求解的随机扰动,得到最稳健的截距估计:
-
当训练完成、面对从未见过的测试新样本 时,这公式意味着什么?
将 代入线性判别式 ,由于非支持向量的 ,求和项自动坍缩为仅对支持向量集合 求和:
这个看似简单的代换蕴含着两大极其深远的红利:
-
极致的推理与存储精简(稀疏性红利):训练结束后,那 99% 处于安全区内部的训练样本()可以直接从内存里永久丢弃!哪怕训练集有 10 万个样本,只要最后只有 50 个支持向量,预测一个新样本 时就只需要跟这 50 个支持向量算内积。
-
只依赖“样本对内积”(通往第 4 节核技巧的唯一钥匙):注意看,预测新样本 时,我们甚至不需要显式把向量 算出来存着,而是只需要计算新样本 与各个支持向量 之间的内积 !正是因为训练和预测都只需要“两个样本的内积”,下一节我们才能把内积直接替换成核函数 ,在完全算不出 的无穷维空间里照样轻松分类!
-
-
4. 核技巧(Kernel Trick):不进高维空间,却享高维切分
在第一站的末尾(第 6.2 节),我们见识了线性分类器的阿喀琉斯之踵——XOR 异或难题与非线性分布(比如一圈正例包着一团负例的同心圆分布)。在原始二维平面上,没有任何一条直线能把内圈和外圈切开。
当时的统计学家提出了破局之道:特征映射升维(Feature Mapping)。
既然在低维空间 切不开,我们就找一个非线性映射函数 ,把样本点拍进一个更高维(甚至无穷维)的特征空间 中,然后在高维空间里用超平面 把它们一刀切开!
4.1 为什么要构造“多项式交叉特征”?显式升维又为何会引发“维数灾难”?
(1)直觉追问:为什么要构造 阶多项式交叉特征 ?
回到二维平面 上的两个经典非线性难题,答案立刻水落石出:
-
几何弯曲直觉(把二维曲线拉直成三维平面):
假设正例在半径为 的圆内(),负例在圆外();或者分界线是一个斜着的椭圆 。
在原始二维坐标 下,它是弯曲的二次曲线,任何直线都切不开;但如果我们把二次自乘项与交叉相乘项定义为三维空间的新坐标轴:
那么原来的二维椭圆方程,在新空间 里瞬间变成了一个平平无奇的线性超平面 !同理,如果你要拟合任意复杂度的光滑曲面,根据泰勒展开(Weierstrass 逼近定理),只需引入更高阶( 阶)的多项式项,就能在更高维空间里用“一刀平切”等价实现低维空间里任意蜿蜒曲折的非线性分界线。
-
特征交互直觉(突破线性模型的“独立可加性”盲区):
普通线性分类器 默认特征之间是孤立可加的(特征 1 的贡献与特征 2 的取值无关)。但在真实世界里,分类往往取决于特征之间的协同与逻辑与(AND)交互:
-
比如 XOR 异或问题:正例在一、三象限( 同号),负例在二、四象限( 异号)。单看 或单看 毫无区分度,但只要构造出一个二阶交叉特征 ,正例全部满足 ,负例全部满足 ,瞬间线性可分!
-
比如图像识别:单个像素 是黑是白毫无意义,唯有当“左眼位置的像素 ”、“右眼位置的像素 ”与“鼻梁位置的像素 ”同时出现(即高阶乘积项 非零)时,才能触发“这是一张人脸”的判别特征。
-
(2)维数怎么算出来的?—— 显式升维的噩梦(Curse of Dimensionality)
既然 阶多项式交叉特征这么好用,为什么我们不能直接把它们全部算出来存成新向量 ?
让我们算一笔简单的组合数学账(隔板法 / 可重复组合):
假设原始输入 有 个特征。我们要构造所有总次数不超过 阶的多项式单项式(包含常数项 、一阶项 、二阶项 ……直到 阶项)。
💡 维数公式的直观推导(选球放盒模型): 凑出一个次数 的单项式,等价于手里有 个相同的次数名额(球),要分给 个特征变量 外加 个代表“常数 1”的虚拟桶(一共 个桶,分到常数桶里的名额代表用 占位,从而得到低于 阶的项)。 根据高中组合数学的隔板法, 个球放进 个桶(允许空桶)的方案数,等于在 个球和 块隔板构成的 个位置里选出 个位置放球:
先用 个特征()、 阶验证一下公式:
当特征数很小()时, 维看起来无比温和。但只要放到真实工业场景里动手算一下,就会立刻撞上一堵算力高墙:
假设原始输入 有 个特征(比如一张仅 像素的小灰度图):
-
当 (仅含二次交叉项 )时,映射后的维度是 ;
-
当 (五阶特征交互 )时,映射后的维度高达:
如果按照笨办法,先把每个样本 显式展开成 万亿维的向量 存进内存,再去算高维空间里的内积 ,地球上所有的超级计算机都会瞬间内存溢出、算力瘫痪。
4.2 核技巧的降维打击:先算内积,再做幂运算!
就在这看似绝境的地方,前文推导出的 SVM 对偶问题 展现出了惊人的威力!
请回头看一眼对偶问题和预测函数:在升维后的空间里,我们从头到尾根本不需要单独知道高维向量 长什么样,也不需要显式存储高维法向量 !
无论是在训练目标:
还是在预测决策:
高维映射 永远、且仅仅以“两个样本的高维内积 ”的形式成对出现!
那么,有没有可能完全跳过构造高维向量 的过程,直接在原始低维空间 里用一个极简的二元函数 ,一步算出它们在高维空间里的内积?
让我们看一个让人拍案叫绝的代数魔术:
设原始输入是二维向量 和 。我们在低维空间直接计算它们内积的平方:
仔细看最右边这三项!它可以严丝合缝地拆成两个三维向量的标准内积:
推广到刚才那个 维、 阶多项式的噩梦场景:
-
笨办法(显式映射):先构造两个 8.5 万亿维的向量 和 ,再做 8.5 万亿次乘法求和,复杂度是 ;
-
核技巧(隐式内积):直接在 1000 维空间算一次普通内积 (仅需 1000 次乘法),然后加 再求一次 次方:
计算复杂度仅仅是 次运算!
核技巧(Kernel Trick)的本质定义: 如果存在一个定义在原始低维输入空间上的函数 ,它的计算结果恰好等于某个高维(甚至无穷维)特征空间 中两个映射向量的内积: 我们就称 为核函数(Kernel Function)。核技巧就像一条穿越维度的“虫洞”:你在低维空间付出了极其廉价的 算力,却在数学上等价于在万亿维乃至无穷维空间里完成了线性超平面切分!
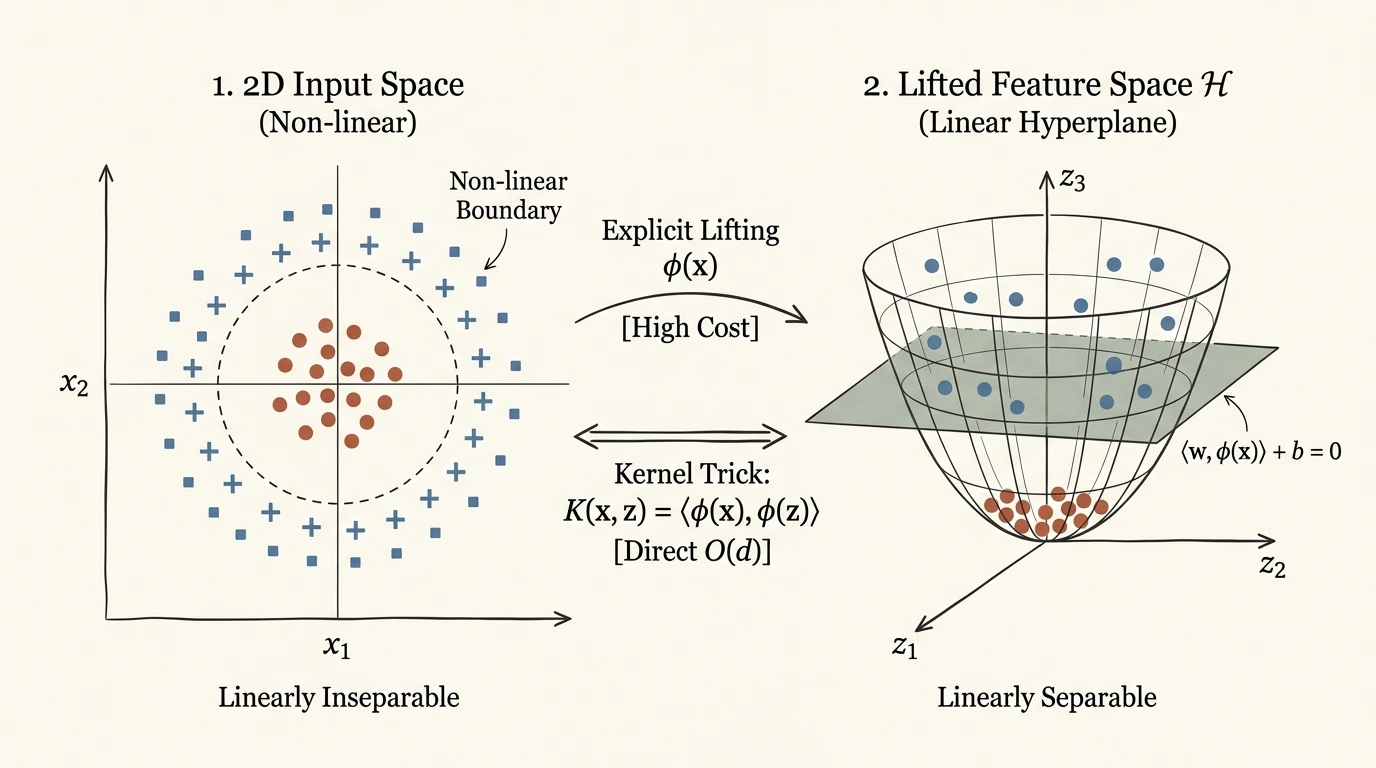 图:特征映射升维与核技巧(Kernel Trick)的几何直觉——在原始二维空间 中线性不可分的同心圆边界(左),经二次多项式映射 托举至三维抛物面空间 后,内圈正例沉在碗底、外圈负例升上碗壁,即可被一张平直的线性超平面 一刀切开(右);而核函数 则直接绕开了高昂的显式升维,以 的计算代价一步算出高维空间内积
4.3 高斯核(RBF 核):为什么一行公式能映射进“无穷维空间”?
在所有核函数中,工业界实战统治力最强、最传奇的当属高斯径向基函数核(Gaussian Radial Basis Function Kernel,简称 RBF 核):
初看这个公式,它明明只是在原始低维空间里算“两个点 和 欧氏距离平方的负指数”,怎么就等价于把样本映射到了无穷维(Infinite-dimensional)特征空间做内积呢?
要把这件事彻底看懂,我们只需要记住核技巧的唯一目标:把一个同时含有 和 的二元函数 ,拆解成“纯含 的项 ”与“纯含 的项 ”相乘再相加的形式(因为两个向量的内积定义就是对应坐标相乘再求和:)。
我们以一维输入 (为书写清爽,不妨设 )为例,分三步拆解这个魔术:
-
第一步:把 拆开,分离“各自独立项”与“交叉纠缠项”
利用初中完全平方公式 ,指数上的减法变成同底数幂的乘法:
看!前两项 和 已经自动分家了(一个只归 管,一个只归 管)。现在唯一的绊脚石是第三项 ——在这里 和 乘在一起塞进了指数里,怎么把它们拆成“左边的 函数 右边的 函数”?
-
第二步:用泰勒级数把 展开成“0 阶到无穷阶多项式的总和”
微积分里最基础的指数泰勒展开公式告诉我们:对任意实数 ,都有
现在把 代进去!因为 ,原本纠缠在指数里的 和 瞬间在每一项里 cleanly 拆成了左右对称的两半:
-
第三步:把外面的高斯衰减包络乘进去,直接读出无穷维坐标 !
把第一步分好家的 和 分别塞进每一项的左右两边,我们就得到了最终的内积分解:
直觉震撼时刻——那个无穷维向量 到底长什么样?
对于任意一个一维数字 ,高斯核实际上隐式地把它映射成了这样一个无穷长( 维)的特征向量:
-
在 4.1 节中,多项式核 只能把特征展开到固定的 阶;
-
而高斯核因为借用了指数函数 的泰勒级数,相当于一口气把 阶、 阶、 阶……直到无穷阶()的所有多项式特征全部打包放进了向量 里!
-
你可能会问:无穷多项加起来不会爆炸(发散)吗? 不会!因为每一维坐标都除以了阶乘根号 (阶乘的增长速度远超幂函数),并且外面还套了一层高斯衰减壳 。所以随着维度 往无穷大走,高阶坐标 会迅速衰减趋近于 ,保证无穷维向量的总长度恒为 (即 ,所有样本都被映射到了无穷维单位超球面上!多维输入 的严格展开与 Mercer 定理详见 附录 C)。
-
高斯核的局部几何直觉:“以支持向量为灯塔的局部相似性叠加”
把高斯核代回 SVM 的预测函数:
这个公式在原始空间里有着极其直观的物理画面:
-
每个支持向量 就像在自己的坐标位置立起了一座“高斯钟形山峰(或灯塔)”(正例支持向量是向上隆起的山峰 ,负例支持向量是向下凹陷的盆地 );
-
当新样本 走过来时, 测量的就是 与各个支持向量之间的局部欧氏相似度;
-
带宽参数 的几何调控:
-
极小( 极大,山峰极其平缓宽阔):每个支持向量的辐射范围覆盖全场,叠加出来的等高线非常平滑、接近线性边界(容易欠拟合,高偏差、低方差);
-
极大( 极小,山峰变成一根根极细的针刺):只有当 几乎贴到某个支持向量脸上时相似度才非零,稍远一点就衰减为 。此时决策边界会在每个正例样本周围画出一个个孤立的“小孤岛”,虽然能把训练集 100% 死记硬背下来,但泛化能力彻底崩溃(严重过拟合,低偏差、高方差)!
-
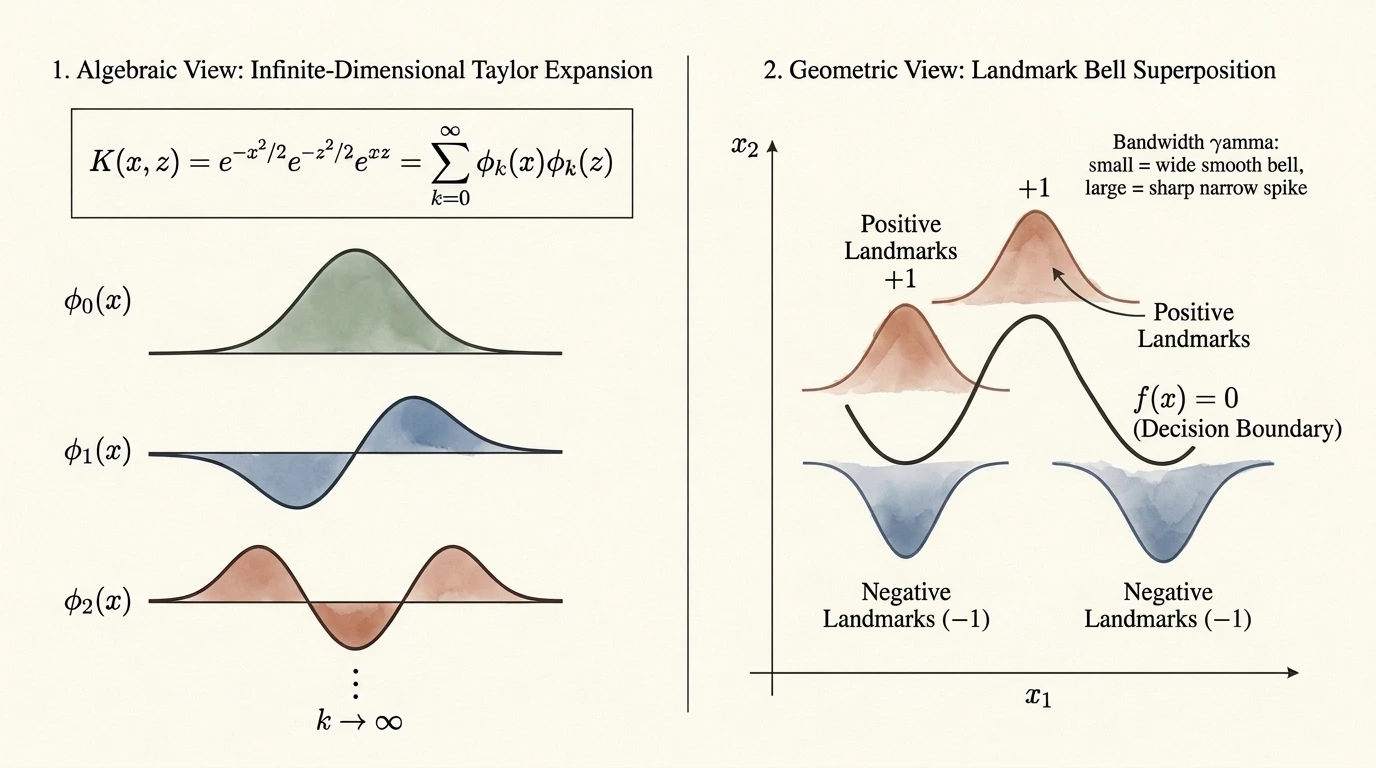 图:高斯核(RBF Kernel)的一体两面——左图(代数视角):通过泰勒级数将交叉项 展开,把高斯核拆解为从 0 阶钟形波 、1 阶奇函数波 、2 阶双峰波 直至无穷阶()特征波包分量在 希尔伯特空间中的无穷维内积;右图(几何视角):在原始空间中,每个正例支持向量立起一座 高斯山峰(陶土红),每个负例支持向量挖出一座 高斯盆地(钢蓝),山峰与盆地相消的零等高线 即雕刻出平滑的非线性分类边界
5. 向现实妥协:两种鲁棒性的辩证博弈与 Hinge 损失大一统
在第 2.3 节中,我们见证了硬间隔 SVM 极其纯粹的物理美感:它通过最大化间隔,在每个样本周围吹起了一个半径为 的抗微扰安全球。
然而,细心的读者在此处会发现一个极其尖锐的“鲁棒性悖论”:
在机器学习中,“鲁棒性(Robustness)”其实存在着两个截然不同、甚至相互冲突的维度:
- 测试期输入微扰鲁棒性(Test-time Input Perturbation Robustness):模型学成后,测试样本受到微小欧氏噪声抖动 ()时,预测判定是否依旧坚挺?
- 训练期异常值/脏数据鲁棒性(Training-time Outlier Robustness):在训练阶段,若数据集中混入了标注错误、测量损坏的离群噪点(Outliers),学出的分界线会不会被严重带偏甚至崩溃?
5.1 硬间隔的“安全气囊悖论”与可行解的灾难性缩水
硬间隔 SVM 的全部理论,建立在一个极端理想化的前提之上:假设训练集里的所有数据都是 100% 绝对纯净、标签绝对正确的模范样本。在此前提下,它将所有精力倾注在最大化测试期输入微扰鲁棒性上。
然而,硬间隔 SVM 对每个样本实行的是“绝对平均主义且拥有一票否决权”的铁腕规则:
-
它根本无法分辨哪个点是普遍规律的代表,哪个点是不小心手滑标错的孤立噪点;
-
它死板地要求:全场所有样本,无论良莠,都必须套上同等厚度的抗扰安全气囊 ,且绝不允许任何一个样本的气囊发生碰撞或越界!
一旦真实的训练集混入哪怕一颗脏数据(Outlier),这种对“测试期抗扰动”的极致死守,立刻会在“训练期抗脏数据”上引发灾难性的崩塌:
-
边缘噪点引发可用解严重缩水,全体正常样本陪葬:若混入的噪点靠近对方阵营,为了给这颗叛徒噪点也吹起同样大小的安全气囊,分类超平面被迫发生剧烈偏转与倾斜;为了不让噪点越界,正负两类之间的走廊被挤压成一条极其狭窄的细缝()。为了迁就唯一一颗脏数据,全体正常样本的测试期抗微扰安全气囊被迫大幅缩水!
-
阵营深处噪点导致几何相撞,可行解空间彻底清零:若噪点直接混入了对方阵营的腹地(例如一个由于录入错误被打上负标的点,物理坐标深深嵌在一堆正例正中央),该噪点的安全气囊与周围正例的气囊必然发生几何干涉与重叠。此时,硬间隔不等式组 瞬间产生代数矛盾,可行域直接变为空集(Infeasible)——模型连一条合法的分界线都选不出来!
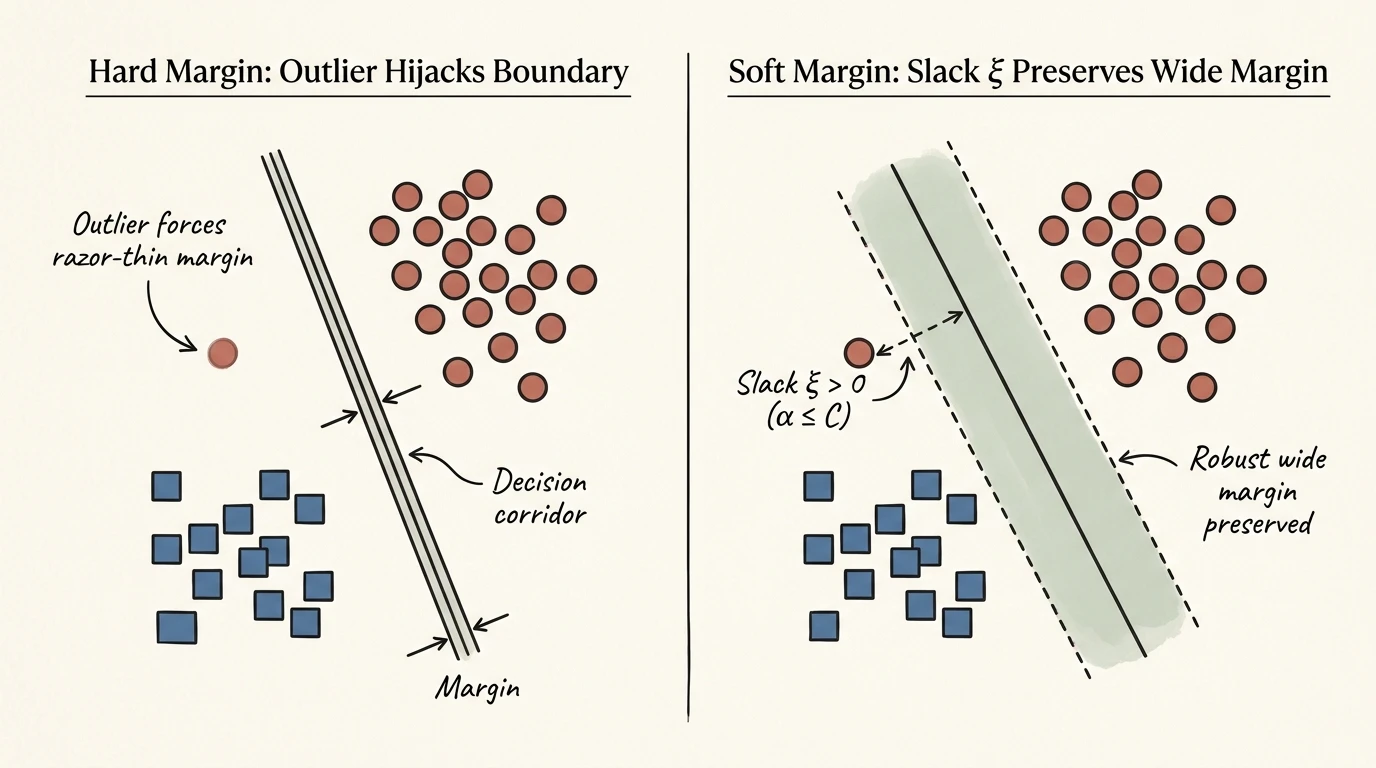 图:两种鲁棒性的冲突与软间隔救赎——左图硬间隔为死保单个离群噪点(Outlier)被迫将决策走廊挤压成细缝;右图软间隔通过松弛变量 (泄气阀)与推力上限 容忍单个噪点越界,从而为绝大多数正常样本保住宽阔稳健的分类走廊
这构成了统计学习史上一段发人深省的哲学反讽:硬间隔 SVM 为了在测试期追求极致的“抗微扰”,却在训练期对“脏数据”表现出了几乎弱不禁风的零容忍度!
5.2 软间隔 SVM:给安全气囊装上“泄气阀”(松弛变量 )
为了打破这一僵局,Vapnik 与 Cortes 于 1995 年提出了软间隔(Soft-margin)SVM。
软间隔的核心智慧极其通透:既然要求所有点都拥有毫无妥协的标准气囊太苛刻,我们为每一个样本 安装一个“气囊泄气阀 / 减压阀”——非负松弛变量(Slack Variable),将硬性约束放宽为:
-
若 :该样本是守法公民,拥有完整的抗扰安全气囊(处于隔离带边界上或深处);
-
若 :气囊部分放气,样本侵入了隔离带走廊内部,但尚未跨过中心决策线 (分类依然正确,只是安全余量不足 );
-
若 :气囊完全瘪掉,样本恰好被推到了中心决策超平面 上;
-
若 :样本彻底越界穿入敌方阵营,被模型分类错误!
当然,放气不是免费的!总体准则依然是“大家的标准气囊 吹得越大越好,但允许个别刺头脏数据交罚款放气”。每多放一单位的气(),就在总目标中交一份罚款 。于是得到软间隔 SVM 的主问题:
这里的惩罚系数 充当了两种鲁棒性之间的宏观调谐器:
-
(零容忍严打):放气罚款无穷大,任何 均被严禁,模型退化回硬间隔 SVM(极致偏向测试期抗微扰,牺牲训练期抗异常值);
-
适中或较小(包容路线):允许少数无法调和的离群点支付代价放气越界(),从而换取绝大多数正常样本享有宽阔从容的全局安全走廊(兼顾输入抗扰度与脏数据鲁棒性)。
5.3 对偶盒式约束:限制单点推力的“涨停板”
软间隔问题写成拉格朗日对偶形式后(完整推导见 附录 B.3),其形式与硬间隔高度统一,唯一的质变是乘子 头顶上出现了一道天花板 :
请从物理力学角度品味这道盒式约束(Box Constraint)的深刻神韵!
在第 3.3 节中我们阐明: 代表样本对分界线施加的“法向拉扯力”。
-
在硬间隔()中,如果混入一个极端离群点,为了强制满足 ,它的推力 可以无上限地飙升至无穷大,凭一己之力把整块隔离板掀翻扭曲;
-
而在软间隔中,任何单个样本对全局超平面的最大话语权(推力)被死死封顶在 以内()!哪怕来了一个坐标极其荒谬、深入敌军腹地的错标噪点,它使出的最大力气也只能是 ;当这股拉扯力无法撼动全局时,模型宁可让它放气越界(),也绝不容许它一人绑架全局决策边界!
由 KKT 互补松弛条件,全体样本在这里被清晰地三分天下:
-
内部样本():隔离带外侧的安全区内部样本(),气囊完好,对边界无推力;
-
自由支持向量(Free Support Vectors)(),严格压在隔离带边界线上(),气囊饱满且刚好相切,工程上正是由这类样本精确反解截距 (⚠️ 注意:绝不能混入 的有界支持向量计算平均值!软间隔截距公式为 ,其中 );
-
有界支持向量(Bounded Support Vectors)(),推力已达涨停板 ,泄气阀被触发,侵入了隔离带内部()甚至已被分错()。
5.4 撕下几何外衣:Hinge Loss(合页损失)与统计正则化的大一统
现在,让我们把软间隔主问题里的不等式约束 和 直接合并。为了使目标最小, 必然取这两者的较大值:
把它直接代回软间隔主问题的目标函数中,约束瞬间全部消失,变成了一个大家无比眼熟的无约束优化问题:
(两边同除以 ,令 ,就完全写成了第二站的标准形式:!)
全书前三站的终极贯通(几何派 vs 统计派的殊途同归): 原来,Vapnik 从纯粹几何“最大间隔 + 松弛变量”推导出来的软间隔 SVM,脱下几何外衣后,在代数上完完全全就是“Hinge 损失函数 + L2 正则化”!
- 惩罚系数 就是 L2 正则化强度 的倒数(): 越小 越大 正则化越强 越小 隔离带 越宽!
- 为什么 SVM 有稀疏性(支持向量),而逻辑回归没有?全看损失函数的形状!
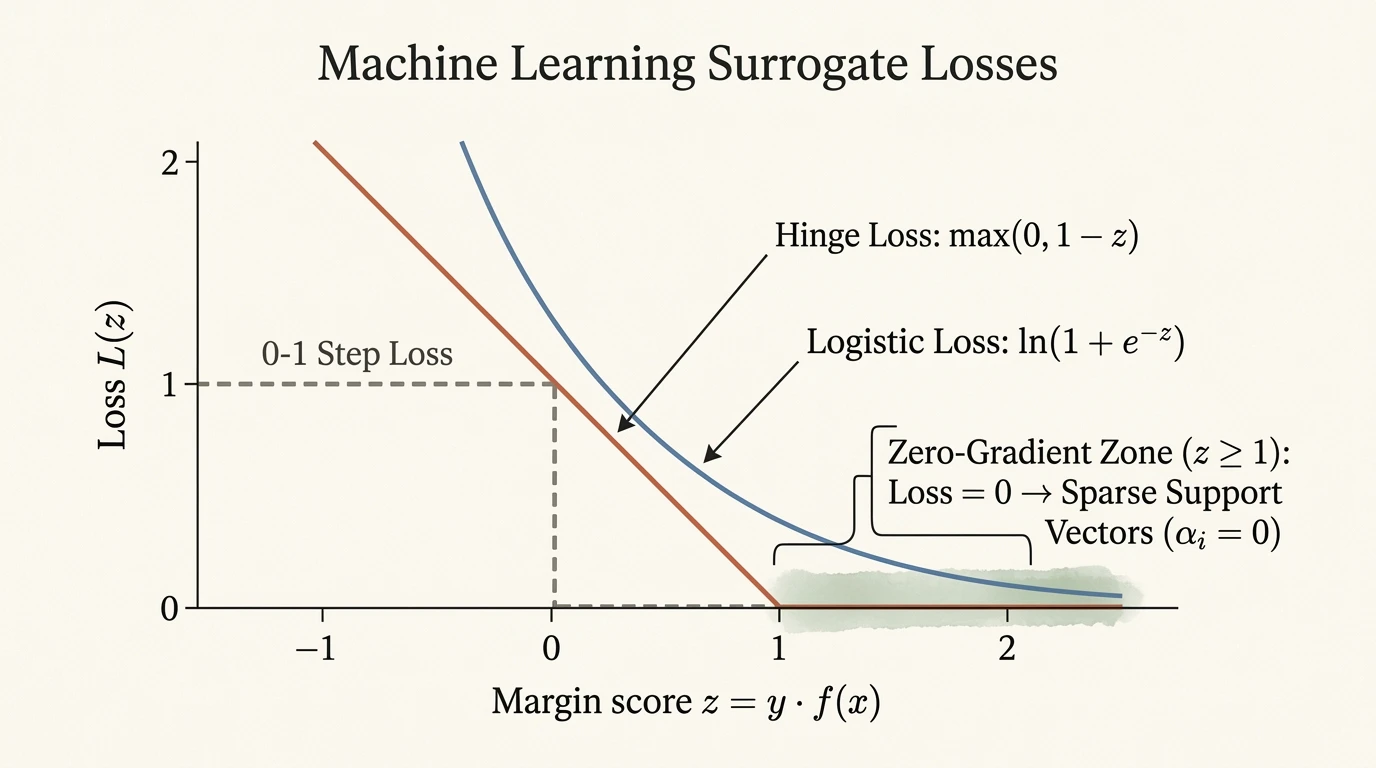 图:分类替代损失函数对比——Hinge 损失在 处存在完全平坦的“零梯度死区”(绿色区域 ),使安全区内部样本乘子严格归零(),造就了支持向量的稀疏性;而 Logistic 损失处处光滑递减、导数永不为零,因此全体样本均参与决策面拉扯
请对比这两条曲线在 (即样本已被正确分类且跑出隔离带以外)时的行为:
-
合页损失(Hinge Loss):
像一扇合页门,在 时以斜率 线性惩罚;但一旦 ,损失直接归零,且导数恒等于 !
这意味着:只要一个样本已经安全退到了隔离带边界 以外,SVM 就会对它说:“你已经及格满分了,我不再关心你还能跑多远,你的梯度归零!” 正是这段水平归零的死区(Flat Zero Region),造就了 的支持向量稀疏性!
-
逻辑回归损失(Logistic Loss)(标签取 时的交叉熵,与 Hinge 损失同尺度对比常除以 ):
这是一条处处光滑严格递减的曲线,虽然当 时渐近趋于 ,但它永远不会严格等于 ,导数 也永远不会等于 !
这意味着:哪怕一个样本已经离分界线十万八千里远(),逻辑回归依然嫌它的预测概率 还不够接近 ,依然会给它分配一个微弱的非零梯度。因此逻辑回归在对偶样本空间的解是稠密的(所有样本的 ,全员都参与组合)。
深度追问:解的“稀疏(Sparse)”与“稠密(Dense)”究竟各有什么优劣势?
既然 SVM 的样本稀疏解(仅少数 )看起来如此干练,为什么工业界没有彻底淘汰稠密解(如逻辑回归与神经网络交叉熵),反而让稠密解在很多场景下占据了统治地位?
把这两者放在天平上对比,我们会看到一场极为经典的工程与统计学权衡:
| 维度 | 稀疏解(Sparse Solution,如 SVM / Hinge Loss) | 稠密解(Dense Solution,如逻辑回归 / Cross-Entropy) |
|---|---|---|
| 核心机制 | 在 处存在零梯度死区,仅边界附近的“支持向量”拥有非零权重 | 损失曲线处处光滑、导数永不为零,全体训练样本都拥有非零话语权 |
| 1. 核方法推理速度与内存开销 | 优势碾压:在核函数非参数化模型中,预测新样本只需计算与少数支持向量的核函数 ,90% 以上的内部样本可直接丢弃,推理复杂度 $$O( | S |
| 2. 抗远端分布漂移 vs. 捕捉全局重心 | 优劣互现:对远离分界线的样本增删或团块移动完全免疫(只要不越过 走廊,边界纹丝不动);但也因此彻底无视了安全区内部的样本密度分布信息 | 优劣互现:利用了全体样本的统计矩信息,能反映两类数据的整体分布重心与密度趋势;但容易被远处大团密集样本或极端远端分布拉扯分界线 |
| 3. 概率校准与不确定性量化 | 天生短板:因为 后梯度归零,模型不再区分“刚压线()”与“极其确信()”,输出的 只是未校准的几何距离,无法直接给出后验概率 (需额外拟合 Platt Scaling) | 天生优势:严格对应伯努利分布极大似然估计,输出值 具有天然的贝叶斯后验概率意义,在需要精确风险定价的场景(广告点击率 CTR 预估、医疗诊断、风控违约率)不可替代 |
| 4. 优化光滑性与边界稳定性 | 不可微与敏感性:Hinge 损失在 处存在尖角(二阶导不存在、一阶导跳变),不能直接用标准牛顿法;且因为分界线仅由极少数边界点“精英独裁”,当样本量极小且边界点恰好带噪时,支持向量的微小变动可能导致超平面摇摆 | 极致光滑与稳定:损失函数无穷阶连续可导()且强凸(加 L2 后),梯度变化极其平滑,天然适配现代深度学习的 SGD / Adam / L-BFGS 等一切一阶与二阶优化器;全员投票机制使分界线随单个边界点抖动的变化更平缓 |
💡 认知折叠:把第二站与第三站的“稀疏性”串成一张网 学到这里,你会发现机器学习里的“稀疏 vs 稠密”恰好构成了一对完美的对偶镜像:
- 第二站(L1 Lasso vs L2 Ridge)是在“特征维度 ”上讨论稀疏:L1 正则通过尖角把无关特征的权重 砍成 (特征选择);
- 第三站(Hinge SVM vs Logistic LR)是在“样本维度 ”上讨论稀疏:Hinge 损失通过 的平坦折角把无关样本的对偶权重 砍成 (样本选择 / 支持向量)! 一切稀疏性的数学源头,都来自于优化目标中的“非光滑尖角 / 折角(Non-smooth Kink)”——光滑的曲线(L2 球面、Logistic 损失)永远只会温和地衰减趋近于 ,唯有带折角的分段函数(L1 菱形顶点、Hinge 合页拐点)才能产生一步到位的“严格等于 ”!
6. 15 行 Python 极简验证:亲眼见证支持向量与核技巧
我们用几行代码对比线性核与高斯 RBF 核在非线性同心圆数据上的表现,并验证“删掉所有非支持向量,模型分界线完全不变”这一核心性质:
import numpy as np
from sklearn.datasets import make_circles
from sklearn.svm import SVC

# 1. 生成二维非线性可分数据:内圈正例,外圈负例(同心圆)
X, y = make_circles(n_samples=100, factor=0.4, noise=0.08, random_state=42)

# 2. 训练高斯核 (RBF) SVM(显式指定 tol=1e-9 以消除工程数值停止容差对理论等价性的干扰)
clf_full = SVC(kernel='rbf', C=10.0, gamma=1.0, tol=1e-9).fit(X, y)
sv_indices = clf_full.support_  # 获取支持向量的下标

# 3. 见证奇迹:删掉 80%+ 的内部样本,【只用支持向量】重新训练一个 SVM!
clf_sv_only = SVC(kernel='rbf', C=10.0, gamma=1.0, tol=1e-9).fit(X[sv_indices], y[sv_indices])

# 4. 对比两个模型的参数与预测差异
max_diff = np.max(np.abs(clf_full.decision_function(X) - clf_sv_only.decision_function(X)))
print(f"总样本数: {len(X)}, 支持向量个数: {len(sv_indices)} (仅占 {len(sv_indices)}%)")
print(f"全样本训练 vs 仅用支持向量训练,决策函数最大数值偏差: {max_diff:.2e}")

# 输出:总样本数: 100, 支持向量个数: 14 (仅占 14%)

#       全样本训练 vs 仅用支持向量训练,决策函数最大数值偏差: 4.24e-09 (在数值收敛精度内完全等价!)
看!在 100 个样本中,只有 14 个压在边界上的支持向量起作用。直接把其余 86 个样本从训练集里彻底抹除,重新训练出的高维非线性曲面与原来在数值精度内完全一致(注:scikit-learn 默认 tol=1e-3 时两轮 SMO 优化路径略有不同会有约 的工程停止浮点差,将精度设为 tol=1e-9 即可见证极限恒等)!这就是 KKT 互补松弛条件赋予 SVM 的数学纯粹性。
7. 历史的回望:为什么 SVM 曾统治江湖,又为何让位于深度学习?
在 1995 年到 2012 年(ImageNet 深度学习爆发前)的十余年间,SVM 几乎凭借一己之力将当时的多层神经网络(MLP)打入冷宫,成为学术界与工业界无可争议的头号霸主:
-
严格的凸优化保证:当年的深层神经网络饱受梯度消失、鞍点停滞、超参数玄学调参之苦;而无论核函数映射到的空间有多高维,SVM 的对偶问题始终是一个凸二次规划问题,保证全局最优,绝无局部极小值陷阱。
-
小样本下的强泛化能力:得益于最大间隔原理与支持向量的稀疏表示,在样本量仅有几百到几千的年代,SVM 展现出远超同期神经网络的抗过拟合能力。
然而,为什么当时代迈入百万级、亿级大数据的今天,核 SVM 却在图像、语音、自然语言领域全面让位于深度神经网络?
这里有两堵核方法在数学结构上无法绕开的铜墙铁壁:
7.1 算力与内存的“样本量平方死穴”:
回顾对偶问题:为了消掉特征维度 ,我们把问题转化成了关于 个样本乘子 的优化,代价是必须计算和访问一张 的核矩阵(Gram Matrix) :
-
当样本量 时,核矩阵只有 个浮点数(约 ),使用 SMO 算法(Sequential Minimal Optimization,序列最小优化) 眨眼即出;
-
当样本量 (一百万,现代深度学习的起步规模)时,核矩阵有 (一万亿)个元素,仅存储这张矩阵就需要 (8 TB)内存!即便使用 SMO 动态缓存局部行,训练时间复杂度依然按 甚至更高阶暴涨,预测时支持向量的数量 通常也会随总样本量 线性增长,导致每次推理都要同成千上万个支持向量算核函数。
-
相比之下,深度神经网络采用固定规模的参数矩阵 ,配合 Mini-batch SGD,每步只看几十个样本,训练复杂度关于样本量 是线性的 ,推理耗时更是与训练样本量 完全无关的常数 !样本越多,神经网络越强,而核 SVM 却被样本量活活撑爆。
7.2 工程实战决策矩阵:面对不同的样本量 与特征维数 ,怎么选主问题/对偶、线性核/高斯核?
把主问题(优化 维参数 )与对偶问题(优化 维样本乘子 )放在一起,我们就能总结出工业界经典的“看 与 下菜碟”铁律(如 LIBLINEAR 与 LIBSVM 的分工哲学):
| 场景特征(样本数 vs 特征维数 ) | 典型工业案例 | 推荐核函数:线性核 vs 高斯 RBF 核? | 推荐求解路线:主问题(Primal)vs 对偶问题(Dual)? |
|---|---|---|---|
| 1. 特征维数极高、样本量较少() 例:, |
基因微阵列测序(百名患者、十万基因位点)、文本 TF-IDF 稀疏袋模型 | 首选线性核(Linear Kernel)! ⚠️ 反直觉避坑:当原始特征维数 已经高达十万维时,数据在如此高维的原始空间里天然就已经线性可分了(Cover 定理)!此时若再套高斯核继续升维,只会引发灾难性的过拟合,且完全没必要。 |
首选对偶问题(Dual)(或带坐标下降的线性求解器) 因为 有 万维,直接算 海森矩阵代价太高;而样本只有 个,对偶问题的 Gram 矩阵 仅仅是 ,转瞬即解! |
| 2. 样本量巨大、特征维数较低或中等() 例:, |
互联网广告点击日志、金融高频风控流水 | 首选线性核(或特征交叉/树模型) 无法直接用精确高斯核(因为 万时, 的核矩阵需要上百 TB 内存,彻底算不动;若非要用核,只能用 Nyström 采样或随机傅里叶特征 RFF 近似成显式低维特征)。 |
必须直接解主问题(Primal)! 绝不能碰 万维的对偶变量 !直接在原始 维空间里,对无约束形式 用 Mini-batch SGD 或坐标下降求解,复杂度仅 。 |
| 3. 样本量中等、特征维数较低且高度非线性( 适中, 小) 例:, |
传感器物理信号分类、工业故障检测、小样本医学图像指标 | 王牌主场:高斯 RBF 核! 原始 维太低、分界线高度弯曲切不开,正好借高斯核映射进无穷维空间完成非线性切分。 |
必须解对偶问题(Dual,SMO 算法)! 因为高斯核映射后 ,主问题里的无穷维向量 根本无法在计算机里显式表示,唯有走对偶路线(只算 的核矩阵 )才能求解! |
7.3 从“固定死核”到“深度学习表征”与“Transformer 注意力(Attention)”的借尸还魂
除了 的算力瓶颈,核 SVM 让位于深度学习还有一个更深刻的认知哲学分野——但令人惊叹的是,核方法的数学灵魂并没有死,而是在 Transformer 的自注意力机制(Self-Attention) 中完成了华丽的涅槃重生!
-
为什么传统核 SVM 输给了深度神经网络?——“固定死核” vs “可学习特征映射”
-
在核 SVM 中,核函数 是人类事先写死、与任务无关的固定相似度公式。它只能在原始像素或浅层特征上僵硬地计算欧氏距离——如果一张猫的照片往右平移了 3 个像素,像素欧氏距离 就会剧变,高斯核立刻傻眼。
-
而深度神经网络把预测写成了 :这里的特征映射 不再是死公式,而是由多层可训练参数 驱动的特征提取器!它通过反向传播自动把原始像素扭曲、折叠、提炼成高层语义空间,使得数据在最后一层天然变成线性可分。
-
-
震撼彩蛋:Transformer 的 Self-Attention,本质上就是一个“可学习的动态核机器(Learnable Kernel Machine)”!
请把核 SVM(或核回归)对新样本 的预测公式,与大语言模型基石 Transformer 的自注意力(Self-Attention)公式并排放在一起对比:
-
核方法(Kernel Method):
-
Transformer 自注意力(Self-Attention):
看出来了吗?!这两者在数学骨架上简直是一个模子刻出来的:
-
继承(同样是“核相似度加权求和”):
Transformer 在处理当前词 (Query)时,依然没有把上下文压缩成一个死参数,而是像核方法拿新样本跟支持向量比对一样,拿当前词 去跟上下文里的每一个历史词 (Key)计算指数内积相似度 (这在数学上正是一个归一化后的指数核 / 高斯核变体!),然后把历史词的信息 按核相似度加权汇聚起来!
-
三大超越(Transformer 是如何进化核方法的?):
-
从“死核”进化为“可学习投影核”:不再直接在原始空间算 ,而是先用可学习的矩阵 把输入投影到语义子空间再算内积 ——什么是相似,由数据自己说了算!
-
从“对称核”进化为“非对称因果核”:传统核必须满足对称性 (Mercer 定理);而由于 ,Attention 打破了对称性束缚(“我关注你”不等于“你关注我”),从而能够表达有向语法依赖与因果推理!
-
连 的软肋都一脉相承:为什么今天长文本大模型(Long-Context LLM)最头疼的是上下文长度 变长时的显存与算力 爆炸?因为 Self-Attention 的那张 注意力矩阵 ,在数学上完完全全就是核方法里那张 的 Gram 核矩阵!而近年来大火的 Linear Attention(线性注意力),用的恰恰就是当年核方法为了绕开 核矩阵而发明的“显式特征映射重构 ”技巧!
-
-
历史的轮回就是如此迷人:二十年前在 SVM 里锤炼出的“内积核度量、对偶样本表示、Gram 矩阵瓶颈与低秩近似”,在二十年后的今天,依然是理解大模型架构演进最硬核的数学钥匙。
8. 本章核心总结与认知闭环
| 演进环节 | 核心数学/几何工具 | 解决的关键问题与认知飞跃 |
|---|---|---|
| 1. 最大间隔与鲁棒等价 | 几何间隔 + 规范化定标 + 最坏微扰对抗 | 从逻辑回归的“全样本概率折中”转向“最大化分界走廊宽度 ”;数学证明最大间隔等价于在每个样本周围吹大半径为 的测试期输入抗微扰安全球,消解尺度冗余后导出主问题 。 |
| 2. 拉格朗日对偶与 KKT | 鞍点极大极小博弈 + + KKT 互补松弛 | 揭示 SVM 的空间稀疏性:内部安全区样本乘子严格归零(),超平面完全由极少数压在 边界上的支持向量按静力学平衡锁定。 |
| 3. 核技巧升维 | 核函数 + 高斯 RBF 泰勒无穷维展开 + Mercer 定理 | 借对偶形式中特征仅以成对内积出现的契机,用低维 核计算绕过显式高维映射的“维数灾难”,在万亿维乃至无穷维空间完成隐式线性切分。 |
| 4. 软间隔与双重鲁棒博弈 | 气囊泄气阀 + 对偶盒式上界 + Hinge 损失 | 调和“测试期输入抗扰”与“训练期脏数据容忍”的辩证矛盾;用盒式上界封顶单点最大推力 ;证明软间隔 SVM 等价于 Hinge 损失 + L2 正则化,Hinge 在 处的水平零梯度死区正是稀疏性的代数根源。 |
| 5. 历史兴衰与范式演进 | Gram 矩阵 瓶颈 vs 神经网络可学习映射 | 厘清核 SVM 统治小样本时代的凸性优势,以及在海量数据时代因 核矩阵内存瓶颈与“预设固定核缺乏层次语义学习能力”而让位于深度学习的历史必然。 |
从本章迈向下一站:在第三站,支持向量机用严丝合缝的解析几何与凸对偶理论,将连续特征空间中的超平面切分推向了浅层学习的巅峰。然而在真实的商业与工业世界里(如银行信贷审批、医疗指标诊断、电商用户行为宽表),数据往往不是连续光滑的几何流形,而是充斥着离散类别、缺失值、量纲悬殊且具有强烈“轴平行阶梯规则”的异构表格数据(Tabular Data)——下一站我们将走进“表格数据的王者”:基于信息熵分治的决策树与集成学习(Random Forest / GBDT / XGBoost)。
📖 深度附录(数学与理论底座)
本附录提供正文主干所依赖的严密数学证明、历史溯源与理论边界推导,供需要严格求证的读者查阅。
附录 A:点到超平面的欧氏距离与最大间隔主问题的严格几何推导
设超平面 ,其中 。
-
为什么 必然垂直于超平面 ?
任取超平面 上的两个点 ,则它们满足:
两式相减得:
由于 是平行于超平面 的任意方向向量,内积为 严格证明了权重向量 是超平面 的法向量(Normal Vector),对应的单位法向量为 。
-
空间任意点 到超平面 的正交投影距离:
设点 在超平面 上的正交投影点(垂足)为 。
因为连线向量 与超平面垂直,它必定平行于单位法向量 。记有向投影距离为 (当 在 指向一侧时 ,反之 ),则:
因为垂足 位于超平面 上,必满足 。将上式代入超平面方程:
注意到 ,化简立即解出有向距离 与绝对欧氏距离 :
-
两条平行支持超平面之间的隔离带宽度:
在规范化定标 下,正负两类的边界超平面分别为:
由上述距离公式,原点到两平面的有向距离之差(即两平行超平面间的垂直距离)为:
附录 B:拉格朗日对偶消元、Slater 强对偶定理与 KKT 条件完整推导
1. 强对偶性(Strong Duality)何时成立?
对于一般优化问题 ,对偶问题最优值 与主问题最优值 之间永远满足弱对偶不等式(Weak Duality):
(直觉:“矮子里拔将军”永远不超过“将军里挑矮子”)。
而要使等号 (强对偶性) 成立,从而允许我们无损地交换 和 ,SVM 满足凸优化中的 Slater 条件:
-
主问题目标函数 是凸函数;
-
约束函数 是仿射函数(线性函数);
-
在凸优化理论中(Boyd & Vandenberghe, Convex Optimization §5.2.3),当所有不等式约束均为仿射函数时,只要主问题存在至少一个可行解(对硬间隔而言即数据线性可分;对软间隔而言,取 恒有严格可行解),强对偶性 与 KKT 充要条件便严格成立!
2. 硬间隔对偶函数的完整代数消元
拉格朗日函数为:
固定 ,将内层极小化一阶条件 与 代入上式:
-
第一项变为:
-
第三项变为:
-
第四项因 直接归零!(注意:若 ,由于 无约束,,对极大化无意义,故 作为硬性约束保留在对偶问题中。)
将第一项( 倍双重求和)与第三项( 倍双重求和)合并,即得对偶目标函数:
3. 软间隔 SVM 的对偶推导与 KKT 三分天下
软间隔主问题有两类不等式约束:(对应乘子 )与 (对应乘子 )。其拉格朗日函数为:
对主变量 分别求偏导并令其等于 :
重点看第 3 式!因为所有含 的项在 中合并为 ,一旦代入 , 就在目标函数中彻底抵消消失了!
同时,由于对偶可行性要求 且 ,两者合并便直接导出了著名的盒式约束(Box Constraint):
结合 KKT 互补松弛条件:
由此可严密推导出三类样本的几何位置:
-
若 (间隔外部安全点);
-
若 ,且由第一式知 (恰好压在间隔边界上的自由支持向量);
-
若 ,且 (侵入间隔内部甚至被分错的有界支持向量)。
附录 C:Mercer 定理、半正定核矩阵与高斯核无穷维映射证明
1. 什么样的二元函数 才有资格充当合法的核函数?
既然核技巧跳过了显式定义 、直接写出 ,那我们随便拍脑袋写一个对称函数(比如 或 ),都能对应某个高维空间里的真实内积 吗?
答案是不能! 内积运算有着极其严格的几何约束(如满足柯西-施瓦茨不等式、自身内积非负 )。Mercer 定理(以及 Moore-Aronszajn 再生核希尔伯特空间 RKHS 定理) 给出了充要条件:
正定核(Positive Semidefinite Kernel)判定定理: 对称函数 能够表示为某个希尔伯特空间 中的内积 的充分必要条件是: 对于输入空间中的任意有限个样本点 ,由它们两两计算构成的 Gram 核矩阵 都是对称半正定矩阵(Symmetric Positive Semidefinite, )!
-
必要性一秒看懂:如果 真是内积,那么对于任意实向量 :
高维向量自身的范数平方永远非负!而且只有当 Gram 矩阵半正定()时,SVM 对偶目标函数中的二次项 才是凹的,对偶问题才不会失去凸优化的全局最优保证!
-
理论脉络溯源:在数学发展史上,Mercer 定理原本基于紧致度量空间与连续对称核,依赖积分算子导出 正交特征函数展开;而将“任意抽象集合上的任意有限样本点集其 Gram 矩阵半正定”作为充要条件直接对应到唯一实再生核希尔伯特空间(RKHS)内积的严格代数保证,是泛函分析中的 Moore-Aronszajn 定理(1950)。机器学习教材常借用广义正定核 / Mercer 核之名统称此充要条件。
2. 多维高斯核(RBF)的无穷维显式映射构造
对任意多维向量 ,高斯核定义为 。利用 :
其中每一阶幂次 由多项式定理展开为所有满足 的多重指标 之和:
代入上式后,每一个多重指标 都对应无穷维空间 中的一个坐标分量:
这严格证明了高斯 RBF 核是合法的正定核,且将有限维输入映射到了可数无穷维希尔伯特空间 中。进一步可以证明:只要输入的 个样本点两两互异()且 ,高斯核生成的 Gram 矩阵是严格正定(Strictly Positive Definite, )且满秩的!