本篇导读:前三讲我们依次拆解了进程内部的内存栈与堆、线程与异步事件循环、跨进程与跨洋的进程间通信、TCP 与流式协议、以及跨越断电的文件系统、并发锁与数据库事务。但有一个最底层的黑盒我们始终没碰:你写的
app.js或main.py,在第三讲眼里不过是磁盘储物格里的一堆文本字节,而第一讲里 CPU 的代码区只认 0 和 1 的机器指令——中间这趟“从英文字符到硅片电信号”的翻译之旅,到底是谁、在哪一步、用什么结构完成的? 第二讲还留下一个悬案:既然所有语言最终都调用同一套内核write()水管,为什么 C、Python、JavaScript 的命运如此不同(“工程不可能三角”)?本篇作为系列收官讲,围绕四个递进问题给出物理答案:① 编译流水线如何把文本炼成指令,抽象语法树(AST)为什么是代码的“意义骨架”?② AOT 编译、解释执行与 JIT 的翻译时机之差,如何决定了语言的速度与生态位?③ 指令之外,代码还需要什么“生命维持系统”(Runtime:垃圾回收、事件循环、跨语言 FFI)才能活下来?④ 当写代码的不再是人而是 LLM,AST 与沙箱如何成为 Agent 安全执行代码的护栏?
问题一:CPU 只认 0 和 1,一行英文代码如何变成电信号?—— 编译流水线与抽象语法树(AST)
回顾第一讲的“内存户型图”:代码区(Text Segment)里躺着塑封压膜、贴在厨房墙上的只读菜谱——机器指令。再看第三讲:你的源代码文件 app.js 在物理上只是 inode 档案卡指向的若干个 4KB 储物格,里面塞着 UTF-8 文本字节。
于是问题赤裸裸地摆在这里:谁把“英文菜谱”翻译成了“硅片菜谱”?
答案是编译器(Compiler)。先祛魅:编译器自己也只是操作系统上的一个普通进程(第二讲),它干的事毫无魔法——读入一个文本文件,吐出另一个字节文件。gcc main.c -o app 与 cat a.txt > b.txt 在“进程读写文件”这个层面没有任何区别,区别只在于它内部的翻译工序。
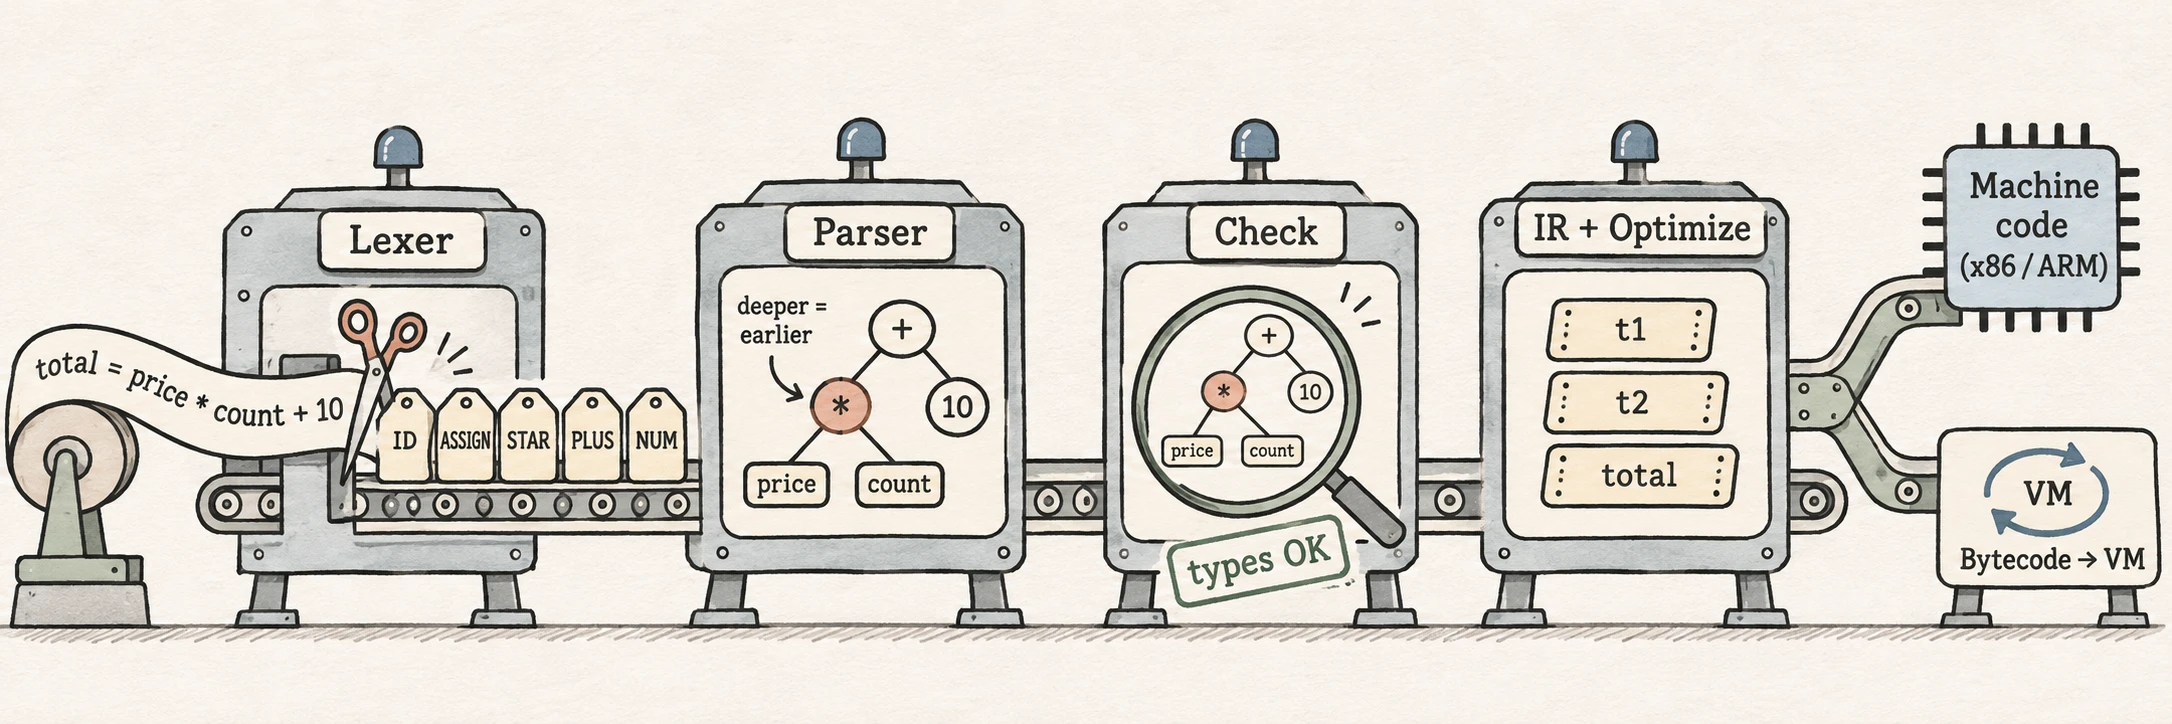 图:一行源代码
total = price * count + 10 的完整翻译流水线。最左侧是磁盘上的纯文本字符流;第一站词法分析(Lexer)把字符切分成一个个带类型的单词(Token);第二站语法分析(Parser)按语法规则把 Token 组装成一棵抽象语法树(AST)——注意 * 节点比 + 节点沉得更深,“先乘除后加减”不是背诵口诀,而是树的几何形状;第三站语义分析检查类型与名字是否合法;第四站降级为中间表示(IR)并做常量折叠等优化;最右侧分岔为两条出路:原生机器码(x86/ARM 指令)或平台无关的字节码(Bytecode,交给虚拟机执行)。
1. 翻译流水线的五道工序:以 total = price * count + 10 为例
① 词法分析(Lexer / Tokenizer):把字符流切成“单词流”
源代码在 lexer 眼里只是一长串字符 t,o,t,a,l, ,=,...。它按词典规则把字符切分成一个个有类型的最小单词(Token),顺手扔掉空格与注释:
| 原始字符片段 | Token 类型 | 记号 |
|---|---|---|
total |
标识符(Identifier) | ID("total") |
= |
赋值运算符 | ASSIGN |
price / count |
标识符 | ID("price") / ID("count") |
* / + |
算术运算符 | STAR / PLUS |
10 |
数字字面量 | NUM(10) |
这一步就像把“我喝水”切成“我 / 喝 / 水”——只分词,不管语法对不对。
切词器是“每语言一个”,不是万能一个。 通用的只是算法骨架,核心一条叫最长匹配(Maximal Munch):能切多长就切多长,于是 === 是一个记号而非 ==+=,x+++y 被切成 x ++ + y(即 (x++) + y)。但“什么算一个单词”这本词典各语言各写各的:Lisp 的 string-append、null? 里减号与问号是名字的合法成分,换到 C 就是运算符;Python 的缩进有意义,lexer 要维护一个缩进栈、在行首吐出原文里根本不存在的 INDENT/DEDENT 记号;JavaScript 的 / 是两面派——a / b 里是除号、/abc/g 里是正则开头,得回头看一眼前一个记号才能定。所以工业界是“一套造 lexer 的方法(正则→自动机,lex/flex/ANTLR)+ 每语言一份词典”。
那“切错了”怎么办?错误在最早能看懂它的那一站被拦下。 分三层看:
- 多数歧义有确定规则当场消解,不算错:最长匹配定
===/++,上下文定/。 - 词典里没有的字符(如 C 里冒出
@):lexer 报词法错误并定位行列——它只能抓“这字符我不认识”这一种错。 - 语法错与语义错它管不了:
total = = 10每个记号都合法,lexer 放行,由下一站 Parser 抓;"hello" * true连语法都合法,要到第三站语义分析才拦。这正是流水线分站的意义。
💡 容错解析(编辑器与半截代码的救星):编辑器里你敲到一半的代码、以及 LLM 流式吐出的半截代码,不能一切错就整棵崩。tree-sitter 这类容错解析器把出错那小段标成
ERROR节点、其余部分照常成树,所以代码敲到一半高亮与跳转照样可用——问题四的 coding agent 也靠它实时验收模型吐出的代码。
② 语法分析(Parser):把单词流组装成一棵“意义骨架树”(AST)
Parser 拿着语言的语法规则(什么单词序列构成合法句子),把 Token 流组装成一棵抽象语法树(Abstract Syntax Tree, AST)。上面那行代码的 AST 长这样(用 JSON 表示,每个节点就是一个语法结构):
{
  "type": "Assignment", "target": "total",
  "value": {
    "type": "BinaryExpr", "op": "+",
    "left": {
      "type": "BinaryExpr", "op": "*",
      "left":  { "type": "Identifier", "name": "price" },
      "right": { "type": "Identifier", "name": "count" }
    },
    "right": { "type": "Number", "value": 10 }
  }
}
盯着这棵树看三秒,你会顿悟一个从小背到大的口诀的真相:“先乘除后加减”根本不是什么需要记忆的规则,而是树的几何形状——* 节点比 + 节点沉得更深,而求值永远是从最深的叶子往树根算,所以乘法天然先算。如果你加上括号写成 (price * count) + 10 与 price * (count + 10),两棵树的形状立刻不同,运算顺序随之改变——括号的作用就是强行掰弯树的形状。
③ 语义分析(Semantic Analysis):语法正确 ≠ 说得通
"hello" * true 每个单词都认识、树也搭得起来,但“字符串乘布尔值”在类型上说不通。语义分析负责类型检查(这俩类型能相乘吗?)与作用域解析(price 这个名字在哪里声明过?)。静态类型语言(TypeScript/Rust)在这一步把大量错误拦在运行之前;动态语言(Python/JS)则把这笔记账推迟到运行时——这正是第二讲“不可能三角”里“开发速度 vs 安全”的第一处物理落点。
④ 中间表示(IR)与优化:把树压扁成流水线指令
AST 是给人和工具看的树,机器不好直接执行。编译器把它降级为更扁平的中间表示(IR),比如三地址码:
t1 = price * count
t2 = t1 + 10
total = t2
在这一步做优化:常量折叠(2 * 3 直接算成 6)、死代码消除(永远执行不到的分支直接删)、公共子表达式合并。优化的铁律是“好像没优化过一样”(as-if rule):无论怎么折腾,程序对外可观察的行为必须一字不差。
⑤ 代码生成:两条出路,决定语言命运
IR 最终被翻译成两种形态之一:原生机器码或字节码。两者都是字节序列,根本区别只在“谁来解码执行”:
- 原生机器码(x86/ARM 指令):某种真实 CPU 的“母语”,CPU 硬件电路直接解码、在硅片上执行,中间没有任何软件。最快,但绑定架构——x86 的二进制丢到 ARM 芯片上就是天书,所以 Mac 与 Windows 往往要各编译一份。
- 字节码(Bytecode):没有任何真实 CPU 懂它,它是给一个软件虚拟机(VM)准备的“模拟 CPU 指令”。VM 本身是一段程序(如 CPython 用 C 写的取指大循环),读一条字节码、再驱动真实 CPU 模仿一个动作。多一层软件模拟故慢一截,但平台无关——同一份字节码,哪台机器装了 VM 就能跑(Java“一次编写,到处运行”即此)。
同样算 a + b,两条出路的产物长这样(示意):
; C 编译出的 x86 机器码 —— CPU 硬件直接执行
mov eax, [a]
add eax, [b]

# Python 编译出的字节码 —— CPython 虚拟机逐条解释
LOAD_FAST   a
LOAD_FAST   b
BINARY_OP   +
一个容易误会的点:字节码也是“编译”出来的——Python 把 .py 编成 .pyc 是一次真编译,只是目标不是真 CPU 而是虚拟机。所以“Python 是解释型语言”准确说是两段:先编译成字节码,再解释执行字节码。
至于走哪条路、什么时候走、各自的速度与生态位代价,就是问题二的全部内容(AOT 直接出机器码;解释/JIT 围着字节码转,JIT 再把跑热的字节码编译回机器码)。
2. 最后一公里:链接(Linker)——你的 printf 其实住在别人家
你写 printf("hi"),但 printf 的实现并不在你的文件里,而在 C 标准库 libc 中。链接器负责把多个编译产物(.o 目标文件)拼装起来,把“调用 printf”这个符号解析到真实地址。两种拼法:
- 静态链接:把 libc 的代码直接复制进你的可执行文件——文件大,但走到哪都能跑。
- 动态链接:只留一张“欠条”,程序启动时由操作系统的加载器把
libc.so(Linux)/.dll(Windows)映射进内存再填地址——省磁盘省内存,但运行时必须找得到这个库(“DLL 地狱”的由来)。
注意:动态库是程序跑起来之后才进场的——“运行时(Runtime)”这个词,从这里就开始露头了。
3. 为什么 AST 是代码的“意义骨架”?——所有代码工具都在骨架上动刀,而不是在皮肤上
文本只是代码的皮肤,AST 才是骨架。看懂这一点,整个现代代码工具链瞬间透明:
| 工具 | 它在 AST 上干什么 |
|---|---|
| Prettier(格式化) | 把 AST 重新“打印”成统一缩进的文本——所以它绝不会改变语义,只是换皮 |
| ESLint(查错) | 在树上做模式匹配:“找到所有 == 节点,建议换成 ===” |
| Babel / codemod(批量改造) | 外科手术式变换树:把一万个调用点的 oldApi(a, b) 精准改成 newApi({a, b}),不碰任何无关字符 |
| tree-sitter(编辑器解析) | 增量解析:你每敲一个键,只重建受影响的那一小段子树,毫秒级完成 |
用正则表达式改代码,是隔着皮肤凭手感整容;用 AST 改代码,是照着 X 光片做骨科手术。这也是 AI 时代的关键伏笔:LLM 吐出来的是文本(皮肤),而验证与变换代码的工具全都工作在 AST(骨架)上——问题四会回到这里。
💡 顺手的打通:
JSON.parse()本质上也是一次“词法分析 + 语法分析”,产出一棵数据树——但它只建数据,绝不执行。而eval()会把字符串当代码完整走一遍编译流水线并执行。同样是“解析字符串”,一个只读骨架、一个引狼入室,这就是为什么第三讲说配置文件用 JSON 而绝不用eval读配置。
4. 打通第二讲:VS Code 的红波浪线从哪来?—— 语言服务器协议(LSP)
把上面的流水线接上第二讲的进程通信,就能解释一个每天都在用、却很少人想过的现象:你在 VS Code 里敲代码,红黄波浪线是怎么实时冒出来的?
关键真相:编辑器自己并不解析你的语言。 VS Code 只当前端(画界面、收按键),它在后台单独起一个语言服务器(Language Server)进程当后端——Python 是 Pylance/pyright、TypeScript 是 tsserver、Rust 是 rust-analyzer。真正跑“词法→语法→语义”流水线、算出错误的是这个后端进程。前后端之间,正是第二讲那根 stdio 匿名管道,里面流的是 JSON-RPC 消息(与本地 MCP 工具调用同一套底座)。
于是形成一个闭环:
- 你敲几下键,VS Code 顺管道发一条
textDocument/didChange(“文件改了,新内容是这些”); - 语言服务器增量重解析(tree-sitter 只重建受影响的子树),把三层诊断算出来;
- 顺管道推回一条
textDocument/publishDiagnostics(“第 3 行第 5 列:类型不匹配”); - VS Code 照着坐标画红波浪线。
💡 分清两套机制:代码本身花花绿绿的上色是编辑器用 TextMate 正则语法做的轻量着色(不做真解析);红/黄波浪线才是语言服务器算出的诊断。而 LSP 与 MCP 是亲兄弟——都是“宿主进程 + 服务进程,JSON-RPC over stdio”,通一个便通另一个。
问题二:同样是写代码,为什么 C 比 Python 快两个数量级?—— AOT、解释执行与 JIT 的翻译时机之争
第二讲我们断言:所有语言的外壳语法只是方言,底层内功(系统调用)完全一样,但“工程不可能三角”让语言注定分化。现在可以揭晓三角的物理根源了:翻译发生在什么时候?运行时谁在旁边陪着?
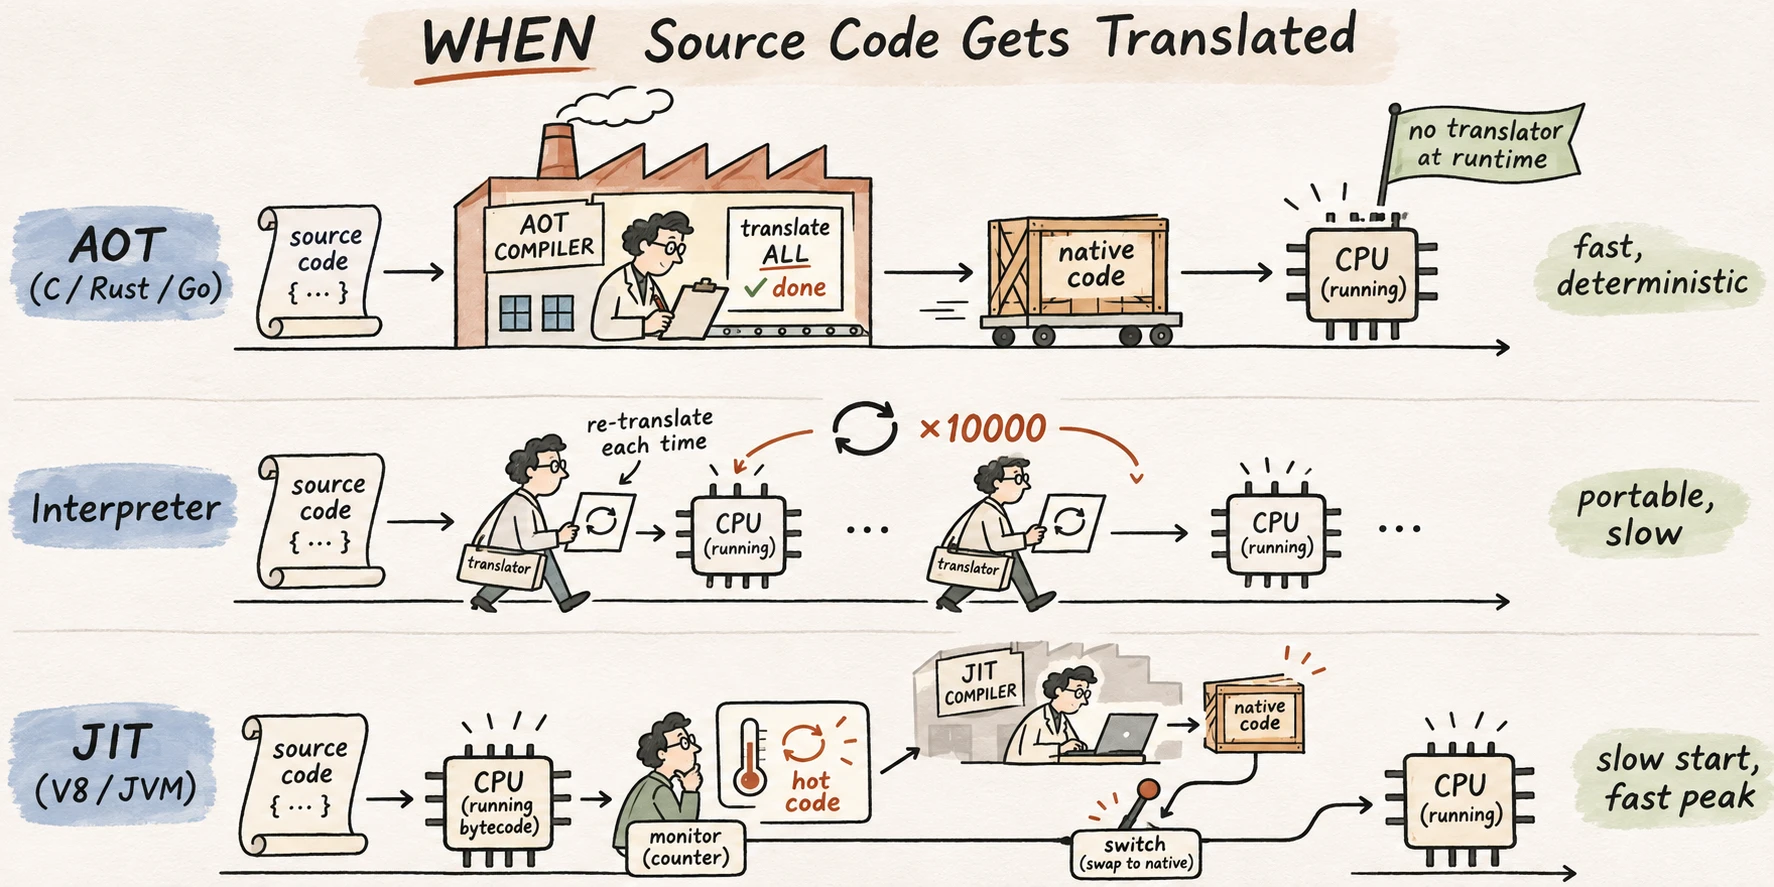 图:三种执行模型的翻译时机对比。上排 AOT(C/Rust/Go):发布前就把全部源码翻译成原生机器码,运行时没有任何翻译官陪同,CPU 直接执行,速度最快且延迟确定;中排纯解释(早期脚本语言):每执行一行都现场翻译一行,循环一万次就重复翻译一万次,便携但慢;下排 JIT(V8/Java HotSpot):先用解释器或字节码虚拟机跑起来,旁路的 profiler 持续统计哪些代码是热点,一旦某段循环被判定为“热代码”,立即在后台把它编译成原生机器码替换执行——启动快、峰值速度逼近 AOT,代价是运行时多养一个翻译团队。
1. 三种翻译时机,三种物理代价
- AOT 提前编译(Ahead-Of-Time,C / Rust / Go):发布前一次性把所有代码翻译成目标平台的原生指令。运行时零翻译开销,速度最快、延迟最确定。代价:① 平台绑定——x86 与 ARM 各编译一份;② 编译慢(大项目几分钟起步);③ 编译时看不到运行时的真实数据,无法“因材施教”。
- 纯解释(早期 JS / Python、Shell):读一行、翻译一行、执行一行。优点是与平台无关、改完即跑;致命伤是循环体每跑一遍都要重新翻译一遍——翻译的开销远大于计算本身。
- 字节码虚拟机(CPython / JVM / V8 Ignition):折中方案——先一次性翻译成紧凑的字节码(
.pyc/.class),再由一个虚拟机循环“取指令 → 执行”。翻译只做一次,但每条字节码仍要虚拟机软件模拟,比原生指令慢一截。
💡 为什么非要 VM 这个“中间层”? 既然原生码最快,为何不全都 AOT?因为软件虚拟机这一层能换来三样原生码给不了的东西:① 跨平台——一份字节码到处跑,不必为 x86-Windows、x86-Linux、ARM-Mac 各编译一份(Java“一次编写,到处运行”);② 沙箱——VM 能逐条验码、限权、管控内存,原生码一跑就是满权限,WASM/JS 的安全沙箱全靠这一层把关(接问题四);③ 运行时做主——VM 看得见真实类型与热点,才能 JIT、反射、GC。代价是软件模拟的速度损失,再由 JIT 补回。这与云计算用 VM/容器/沙箱在硬件与代码之间插一个可控中间层,是同一套算盘。
2. JIT:边跑边看火候的“现场翻译官”(V8 TurboFan / JVM HotSpot)
现代 JS 引擎与 JVM 的绝招是即时编译(Just-In-Time):程序先以字节码跑起来,引擎旁路养着一个 profiler(火候观察员),持续统计每段代码的执行次数。依据二八定律——程序 80% 的时间耗在 20% 的代码上——一旦某段循环被判定为“热代码”,立刻在后台把它编译成原生机器码,下次执行直接替换。
JIT 还有两记 AOT 永远做不到的杀招,因为它看得见运行时的真实数据:
- 内联缓存(Inline Cache)与隐藏类:第一次执行
obj.x时记下“obj长这个形状、x在偏移 8 字节处”,之后同形状的访问直接按地址取,跳过字典查找。 - 投机优化 + 去优化回退(Deoptimization):赌“这个变量永远是整数”,按整数生成极速指令;一旦某天传来字符串,立刻撕毁优化版本回退到字节码——赌错了兜底,赌对了白赚。
一个数量级体感(同一台机器、循环累加 1 亿次的粗略经验值,非精确基准):
| 执行方式 | 耗时数量级 | 为什么 |
|---|---|---|
| C(AOT,开优化) | ~0.1 秒 | 原生指令,编译器把循环优化到寄存器里 |
| JS(JIT 热身后) | ~0.1–0.5 秒 | 热循环被 JIT 编译成原生码,逼近 C |
| CPython(字节码解释) | ~5–10 秒 | 每次 a + b 都要运行时查类型、分发到对应加法实现 |
Python 慢的根源不是“解释”这一个字,而是动态类型把一切记账都推迟到运行时:每个 + 都要现场问“你俩是什么类型?该调哪个加法?”。再叠加第一讲提过的 GIL(同一时刻只许一个线程执行 Python 字节码),纯 Python 循环注定跑不快。但 Python 的生态位从来不是自己算——它当指挥官,重活甩给 C++/CUDA 雇佣兵(问题三的 FFI)。
3. 一张表收束第二讲的“不可能三角”
| 语言 | 翻译时机 | 运行时陪跑者 | 换来的生态位 |
|---|---|---|---|
| C / Rust | AOT | 几乎无(Rust 连 GC 都没有) | 操作系统、数据库引擎、浏览器内核——确定性压倒一切 |
| Go | AOT | 轻量协程调度器 + 低延迟 GC | 云原生后端:单文件部署、毫秒级启动 |
| Python | 字节码解释 | VM + 引用计数 GC + GIL | AI 指挥官:开发速度压倒一切,重活外包 |
| JS / TS | 字节码 + JIT | V8 + 事件循环 + 分代 GC | 浏览器与高并发 I/O:一份代码跑遍所有端 |
| Java | 字节码 + JIT | JVM + 分代 GC | 大型企业服务:长跑服务越跑越快 |
💡 工程选型直觉:短命进程看启动,长跑服务看峰值。CLI 工具与 Serverless 函数偏爱 AOT(Go/Rust)或轻量运行时(WASM),因为冷启动即生死;常驻服务偏爱 JIT,因为跑得越久热代码越多、越跑越快。没有“最快的语言”,只有“翻译时机与你的进程寿命匹配的语言”。
问题三:指令之外,代码还需要什么才能活下来?—— 运行时 Runtime:垃圾回收、事件循环与跨语言 FFI
机器指令只解决“计算”。但一个活着的程序还需要:谁来分配和回收内存?谁来调度 I/O?类型信息存在哪?异常抛出后谁来展开调用栈? 这一整套随代码陪跑的“生命维持系统”,就是运行时(Runtime)。
沿用第一讲的厨房隐喻:CPU 指令是厨师的炒菜动作,Runtime 是整间厨房的水电煤气、保洁阿姨与供应链。语言只是发动机,Runtime 才是整台车。
1. 内存管理的三大门派:谁来打扫堆仓库的冷库?
第一讲说堆是“自由货架大冷库”,货物(对象)随用随放。问题是:货物不用了,谁负责清走?
- 手动挡(C:
malloc/free):程序员自己记账。忘了free→ 内存泄漏;free两次或用完再访问 → 悬垂指针 / 双重释放——操作系统与浏览器历史上大部分安全漏洞,根子都是这类内存错误。 - 编译期记账(Rust 所有权 / C++ RAII):把记账提前到问题一的编译流水线里——Rust 的借用检查器在语义分析阶段就推演清楚每块内存“谁拥有、谁借用、何时死”,编译不过就不许跑。运行时零开销,代价是写代码时要跟编译器“吵架”。
- 运行时保洁(GC 语言:JS / Python / Java / Go):养一个保洁阿姨自动打扫。下面拆解她到底怎么点名。
2. 保洁阿姨的两种点名术:引用计数 vs 标记-清除
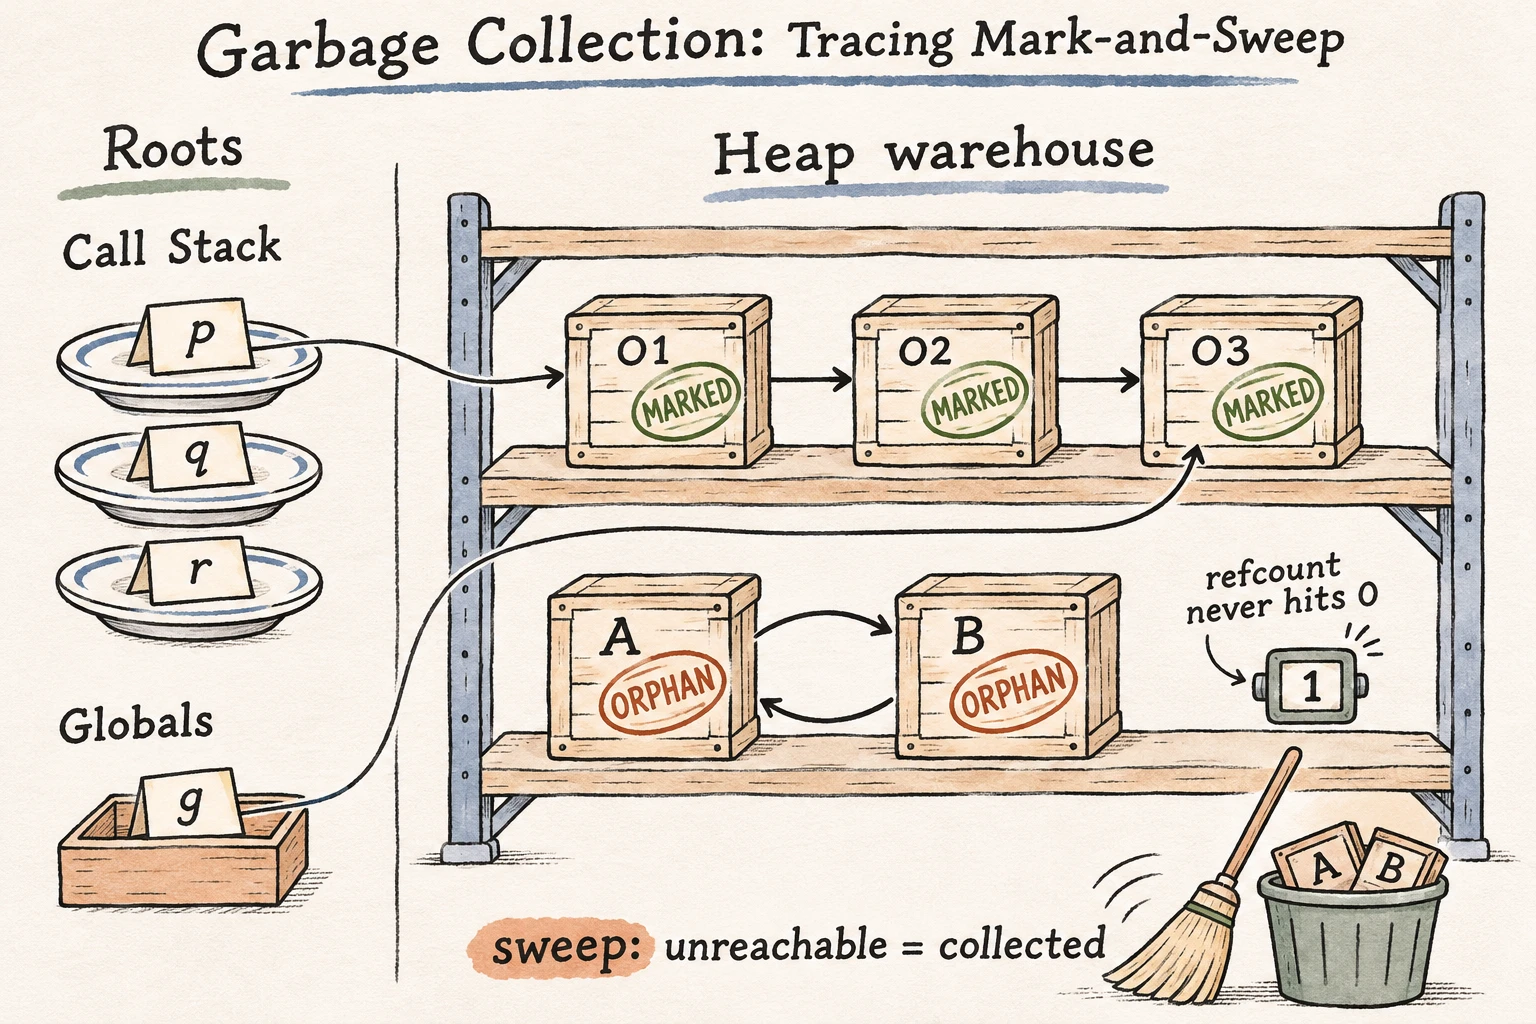 图:追踪式垃圾回收(Tracing Mark-and-Sweep)的物理过程。左侧是调用栈与全局区,栈帧里的小纸条(指针)与全局变量共同构成“根集合(Roots)”;右侧是堆仓库。GC 从根出发顺着指针遍历:凡是被纸条直接或间接指着的货物都盖上绿色“可达(Marked)”印章;遍历结束后,没有任何纸条指向的孤儿货物(红色)被统一清扫回收,内存归还货架。注意图中 A、B 两个对象互相指着对方、但没有任何根纸条指向它们——引用计数对这种循环引用永远数不清,而标记-清除一眼就能判它俩死刑。
- 引用计数(Python / Swift ARC):每个对象挂一个计数器,每多一张纸条指向它
+1,每撕一张-1,归零立刻回收。优点是回收即时、没有集中停顿;死穴是循环引用——A 指着 B、B 指着 A,哪怕外界早已不用它俩,计数永远不为零。所以 Python 在引用计数之外又配了一个周期性循环检测器兜底。 - 标记-清除(Tracing GC:JS / Java / Go):如上图,从根集合(第一讲说的“栈上的小纸条”+ 全局变量)出发遍历整个对象图,可达的留、不可达的扫。循环引用?只要根够不着,一律判死——天然免疫。
分代假说(Generational Hypothesis):经验统计表明绝大多数对象朝生暮死(一次函数调用里的临时对象)。于是现代 GC 把堆分成育婴室(Young Generation)与老年代(Old Generation):新对象全进育婴室,这里频繁做快速小清扫(Minor GC);熬过几轮清扫的长寿对象才搬进老年代,偶尔做一次大清扫(Major GC)。用 90% 的精力打扫 10% 最脏的地方。
代价是停顿(Stop-The-World):清扫时部分阶段要暂停所有业务线程。这就是为什么交易系统与实时渲染对 GC 语言心存忌惮,也是 Go/ZGC 们把停顿压到亚毫秒级的军备竞赛方向。
💡 回扣第一讲的悬案:为什么带 GC 的语言还会内存泄漏?因为保洁阿姨只收“孤儿”,不收“你手里还攥着纸条、但这辈子不会再用的货物”。全局缓存
globalCache一直指着旧数据,阿姨永远不敢收——GC 管的是可达性,管不了你的业务意图。
3. Runtime 解剖:Node.js 与 CPython 里到底装了什么?
| 运行时 | 计算引擎 | 内存保洁 | I/O 调度 | 其他陪跑 |
|---|---|---|---|---|
| Node.js | V8(字节码 + JIT + 分代 GC) | V8 内置 | libuv 事件循环 + 线程池(第一讲的金牌服务员就住在这) | 标准库、原生插件接口 |
| CPython | 字节码虚拟机 | 引用计数 + 循环检测 | asyncio 事件循环(可选) |
GIL、C 扩展接口 |
| 浏览器 JS | V8 / SpiderMonkey | 引擎内置 | 浏览器事件循环 + Web APIs | DOM、网络、渲染管线 |
看清这张表就明白:“JavaScript 是单线程的”说的只是 V8 计算引擎这一个部件;整台 Node.js 赛车里,libuv 的线程池照样在多核上并行做文件 I/O 与加密——第一讲“三台机器接力跑事件循环”的图景,每一台机器上跑的其实都是“引擎 + Runtime”的组合体。
4. FFI:指挥官如何调动雇佣兵(回扣第二讲)
Python 当指挥官的秘诀是跨语言函数接口(FFI, Foreign Function Interface):import numpy 的那一刻,Python 进程把 C 编译的动态库(问题一的 .so)加载进自己的地址空间,矩阵乘法直接甩给 C/CUDA 执行,Python 只负责递参数、收结果。
跨越语言边界不是免费的:类型编组(marshaling)要把 Python 对象翻译成 C 的裸指针与长度,进出各一次;好在 numpy 的数组内存布局与 C 完全一致,大矩阵可以零拷贝直接递过去。调用重计算时还要记得释放 GIL,让其他 Python 线程趁机干活。AI 技术栈注定是“Python 壳 + C++/CUDA 核”的双层结构,不是历史包袱,而是“不可能三角”下的最优解。
💡 那“我的应用该不该用 Rust 重写”?看瓶颈,不看潮流。 回扣第一讲的 I/O 密集 vs CPU 密集:Web 服务、Agent、CRUD 大多是 I/O 密集,99% 时间在等网络/数据库/大模型 API,把胶水层重写成 Rust,等待时间一秒不少(Amdahl 定律:加速只占 5% 耗时的部分,撑死快 5%)。真正立竿见影的是重写吃 CPU 的热路径——于是有了“Python/JS 壳 + Rust/C++ 核”:Ruff(Rust)比 flake8 快几十倍、uv(Rust)比 pip 快几十倍、ripgrep 快过 grep、Polars 快过 pandas,连 OpenAI Codex CLI 都从 TypeScript 重写成了 Rust。注意 Rust 与 Go 不同赛道:Rust 无 GC、压榨极致;Go 带 GC、纯算力慢一截,赢在并发简单与部署省心。语言选型跟着瓶颈走。
5. WASM:把“字节码 + 沙箱”做成通用运行时
WebAssembly(WASM) 是近年最重要的运行时收敛:任何语言(Rust/C/Go)编译成一种紧凑的二进制字节码,在浏览器、服务器、边缘节点的任何 WASM 运行时里以接近原生的速度执行。它天生是能力安全(Capability-based)沙箱:代码只能访问一块显式授予的线性内存,默认摸不到任何 fd、文件或网络(第二、三讲的全部资源都要宿主显式开口子)。这让它成为 Serverless 冷启动与 AI 代码沙箱的新宠——问题四马上用到。
问题四:LLM 只会吐文本,Agent 如何安全地“写代码并跑代码”?—— AST 校验、沙箱执行与 Agent Runtime
前三讲的主角都是“人写的代码”。现在换一个物种:当写代码的是 LLM,跑代码的是 Agent,这套编译与运行时体系如何接住它?
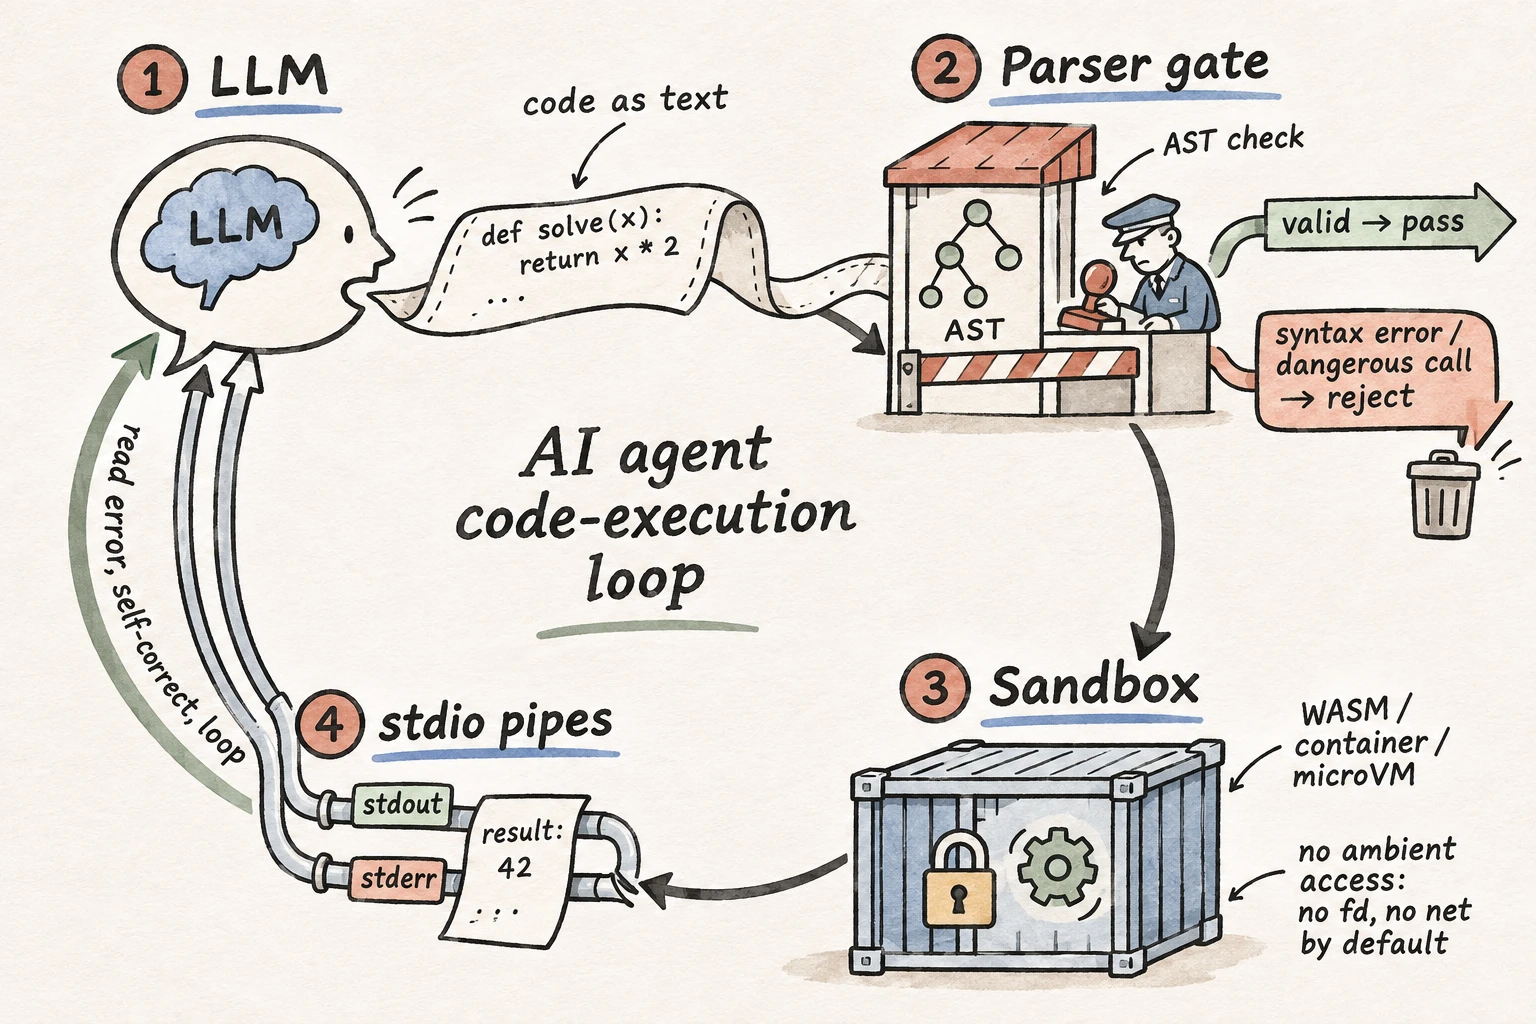 图:Agent 代码执行的完整闭环。左侧 LLM 以 next-token 方式吐出代码文本(皮肤);中间第一道关卡是 Parser 把文本解析成 AST(骨架)——解析失败或命中危险模式(如文件系统删除、网络外联)直接打回,绝不放行;通过校验的代码被送入右侧的沙箱(WASM / 容器 / microVM)执行,沙箱默认剥夺一切环境权限;执行产生的 stdout/stderr 顺着第二讲的 stdio 匿名管道回流给 LLM,模型读到报错后自我修正、再写一版——循环往复,直到任务完成。
1. LLM 吐的是文本,不是 AST:语法错误与幻觉 API 的根源
LLM 的本质是 next-token 预测,没有任何机制保证吐出的字符序列符合语法——它可能漏一个右括号、编造一个不存在的 API。一个有趣的对照:LLM 的 “token”(BPE 子词,纯统计切分)与编译器的 “token”(词法单元,有语法类型)同名不同物;前者是概率的颗粒,后者是语法的颗粒。
工程上的补法是语法约束解码(Grammar-Constrained Decoding):在每一步采样时,用文法规则把不合法的 token 直接屏蔽(JSON mode / 结构化输出就是这么实现的)——等于强迫模型只在合法 AST 的路径上行走。这也解释了为什么结构化输出几乎从不出语法错:不是模型变聪明了,是骨架在每一步扶着它。
2. 代码智能工具链:模型负责提议,骨架负责验证
问题一的 AST 工具链在 AI 时代全部升值:tree-sitter 让编辑器对 LLM 流式吐出的半截代码做增量解析、实时标红;ESLint / 类型检查器在 AST 上拦截幻觉 API 与类型错误;codemod 把模型建议的批量改造精确落到一万个调用点。LLM 生成文本(皮肤),工具链在骨架上验收——这是当前 coding agent 的标准分工。
3. Agent 代码执行循环:为什么绝不能直接 eval()
Coding Agent 与 Code Interpreter 的核心循环如上图:写代码 → 沙箱执行 → stdout/stderr 经 stdio 管道回流(第二讲)→ 模型读报错自我修正 → 再写。代码执行结果是最诚实的反馈信号,比任何 prompt 都硬。
但 LLM 的输出永远不可信(可能带着提示注入的恶意指令),直接 eval() 等于把厨房钥匙交给陌生人。沙箱谱系按隔离强度排开:
| 沙箱层级 | 隔离机制 | 典型场景 |
|---|---|---|
| 进程级 + 权限裁剪 | 独立进程、降权用户、资源限额 | 本地轻量工具执行 |
| 容器(Docker) | namespace + cgroup(《云与 Agent 架构》系列详解) | 通用代码解释器 |
| microVM(Firecracker) | 硬件虚拟化,毫秒级启动的微型虚拟机 | 多租户云函数、不可信代码 |
| WASM 能力沙箱 | 线性内存隔离 + 默认零环境权限 | 边缘计算、插件系统 |
4. 收官回响:从语言 Runtime 到 Agent Runtime
把四讲的镜头拉到最远,会看到一个漂亮的同构:
- 语言 Runtime 给代码提供生命维持:内存管理、I/O 调度、类型元数据——代码只需声明“要算什么”,环境负责“怎么活”。
- Agent Runtime 给模型提供生命维持:循环(Loop)、原子工具(Tools)、上下文(Context)、记忆(Memory)——模型只需决定“下一步干什么”,环境负责供给与兜底。
💡 四件套里,Loop 是引擎,Context 与 Memory 的功夫在“选择”。 模型权重是冻结的,Loop 把执行结果喂回上下文,是它在一次任务里唯一的实时学习。Memory 与 Context 同源却不同层:Memory 是持久海量的仓库(类比磁盘/堆),Context 是当下有限的工作台(类比寄存器/栈),两者之间隔着一层检索与选择——每回合挑哪一小撮 Memory 进 Context,才是真功夫。注意力是稀缺品,无关上下文会稀释它(lost in the middle),腐烂的记忆比没有更坏(被当真理供着、自信走弯路),故 Memory 须讲卫生:会遗忘、更新、解冲突。架构师的手艺是去噪而非限制:清掉腐烂记忆是卫生,把一切预消化成光滑流程则是剥夺自由——insight 恰从杂乱输入中涌现,环境太光滑反而涌现不出。
由此也能看清“画死工作流”与“给模型当架构师”的路线之争在计算机体系里的坐标:预定义工作流是 AOT 思维——把人类工序提前编译成死流程,运行时不许越界,稳定但封顶;Agent Runtime 是 JIT 思维——只备好通用的原子工具与上下文,让模型在运行时按真实火候自行组合,上限交给模型。工具保持通用,模型自会组合出设计者没想到的玩法;而工程师的角色,从画流程图的工长,变成设计循环与环境的架构师。
至此,系列四讲合拢成一张完整的物理图景:第一讲解决“计算与并发如何在内存里活”,第二讲解决“进程之间如何说话”,第三讲解决“状态如何跨越断电存活”,第四讲解决“文本如何变成计算、计算又如何被环境托住”。四个黑盒,一套内功。
附录 A:文法、求值与编译正确性的形式化骨架
1. 上下文无关文法(CFG):优先级即文法分层
问题一的表达式语言可由如下产生式完全刻画( 表达式、 项、 因子):
“先乘除后加减”被编码为文法的分层结构:加法只能挂在 层、乘法只能挂在 层, 比 深一层,故乘法节点必然沉得更深。语法分析树(Parse Tree)剪掉标点与单链冗余节点后,即得 AST。
2. 求值即结构递归(Fold / Catamorphism)
对 AST 的求值是一个从叶子到根的同态折叠:
解释器、编译器、linter、formatter 本质上都是同一棵 AST 上的不同 fold——这正是“所有代码工具共享骨架”的代数表达。
3. 编译正确性与 GC 安全不变式
- 语义保持(as-if rule):设程序 的可观察行为为 ,合法编译与优化必须满足 。
- GC 无悬垂不变式:设活跃状态中所有引用集合为 ,根可达集为 ,则任何回收决策必须满足 ——凡还被指着的,绝不可收;引用计数在循环引用下违反此式的“完备性”(不可达但计数非零者永不回收,造成泄漏),故需 tracing 兜底。
附录 B:最小代码切片 —— 手写递归下降解析器与 AST 批量改造
1. 三十行手写 Parser:亲眼看着文本变成树、树算出值
import re

def tokenize(src):
    return re.findall(r"\d+|[A-Za-z_]\w*|[+*()]", src)

def parse(tokens):
    pos = 0
    def peek(): return tokens[pos] if pos < len(tokens) else None
    def eat():
        nonlocal pos; t = peek(); pos += 1; return t
    def factor():                      # F -> (E) | num | id
        t = eat()
        if t == "(": e = expr(); eat(); return e
        return int(t) if t.isdigit() else t
    def term():                        # T -> T * F | F
        node = factor()
        while peek() == "*": eat(); node = ("*", node, factor())
        return node
    def expr():                        # E -> E + T | T
        node = term()
        while peek() == "+": eat(); node = ("+", node, term())
        return node
    return expr()

def eval_ast(node):
    if isinstance(node, int): return node
    op, a, b = node
    return eval_ast(a) + eval_ast(b) if op == "+" else eval_ast(a) * eval_ast(b)

tree = parse(tokenize("1 + 2 * 3"))
print(tree)          # ('+', 1, ('*', 2, 3))  ← 乘法沉得更深!
print(eval_ast(tree))  # 7
2. 用标准库 ast 做精准 codemod:一万个调用点也不伤及无辜
import ast

src = "old_api(1, 2)\nprint(old_api(3, 4))\nold_api_v2(5)"

class Renamer(ast.NodeTransformer):
    def visit_Call(self, node):
        self.generic_visit(node)
        if isinstance(node.func, ast.Name) and node.func.id == "old_api":
            node.func.id = "new_api"   # 只改函数名节点,绝不碰字符串与注释
        return node

tree = ast.parse(src)
print(ast.unparse(Renamer().visit(tree)))
# new_api(1, 2)
# print(new_api(3, 4))
# old_api_v2(5)   ← 名字相近但不同的函数,毫发无损(正则做不到)